Від робочої групи до SIG Architecture: у центрі уваги AI Conformance
У цьому випуску «У центрі уваги» від SIG Architecture ми поговорили з Janet Kuo (Google) та Yuan Tang (TensorScale AI) про шлях AI Conformance у Kubernetes: від початкової робочої групи до інтеграції в SIG Architecture як підпроєкту.
Знайомство
Frederico Muñoz і Kirti Goyal (FK): Вітаємо, Janet і Yuan, і дякуємо за можливість дізнатися трохи більше про AI Conformance. Чи можете розповісти трохи про себе та про те, як ви долучилися до Kubernetes?
Janet Kuo: Я старший інженер-програміст рівня Staff (Senior Staff Software Engineer) у Google і супроводжую Kubernetes з 2015 року, приєднавшись до спільноти саме тоді, коли ми мчали до запуску версії 1.0. Я починала з написання основних контролерів робочих навантажень, які унормували те, як застосунки оркеструються в Kubernetes. Сьогодні я очолюю SIG Apps як співголова та технічний лідер (TL), а також очолюю програму AI Conformance. Мій теперішній фокус — гарантувати, що Kubernetes залишається найкращою платформою для наступного покоління робочих навантажень, як-от AI.
Yuan Tang: Я співзасновник TensorScale AI, де ми створюємо інфраструктуру AI для моделей світу. До цього я був старшим головним інженером-програмістом (Senior Principal Software Engineer) у Red Hat, де керував розробкою платформи Red Hat AI та стратегією розвитку проєктів із відкритим кодом в апстрімі. Я долучився до Kubernetes на ранньому етапі, сприяючи співпраці між спільнотою Kubernetes і проєктами, які я очолював, зокрема Kubeflow, Argo та KServe. Згодом я допоміг заснувати й очолити WG Serving та програму AI Conformance, просуваючи інновації та зміцнюючи співпрацю спільноти навколо запуску AI-навантажень у Kubernetes.
Програма, робоча група, підпроєкт: яких форм набуває AI Conformance
FK: AI Conformance починався як програма CNCF — саме тоді ви долучилися?
Janet Kuo: Насправді я брала участь із першого дня, адже запропонувала початкову ідею. Тоді стало очевидно, що всі починають запускати AI в Kubernetes, але постачальники будували свої інфраструктурні стеки по-різному. Я занепокоїлася через фрагментацію екосистеми. Тож я написала початкову пропозицію Kubernetes AI Conformance, подала її керівництву CNCF для схвалення й започаткувала програму AI Conformance. Отримавши зелене світло, я звернулася до своїх співголів Yuan Tang, Rita Zhang і Mario Fahlandt, щоб згуртувати спільноту навколо неї.
Yuan Tang: Так. На той час я був співголовою WG Serving, і деякі ініціативи, як-от Gateway AI Inference Extension, швидко набули популярності. У спільноті був сильний інтерес включити вимоги, повʼязані з інференсом, до програми Kubernetes AI Conformance.
FK: Як би ви описали мотивацію створення робочої групи AI Conformance?
Janet і Yuan: Мотивацією створення робочої групи Kubernetes AI Conformance (AI WG) було впоратися зі стрімкою конвергенцією AI-навантажень у Kubernetes і водночас запобігти фрагментації екосистеми.
У міру прискорення впровадження AI організації починали запускати дедалі складніші навантаження, зокрема розподілене навчання, масштабний інференс, конвеєри з інтенсивним використанням GPU та нові агентні AI-системи на багатьох різних платформах Kubernetes. Однак постачальники реалізовували можливості AI-інфраструктури по-різному, особливо щодо GPU, мереж, планування та оркестрації інференсу. Це створювало проблеми з переносимістю, операційну неоднорідність і дедалі більше занепокоєння щодо привʼязки до постачальника.
Робочу групу AI WG було створено, щоб обʼєднати спільноту навколо:
- нейтральних щодо постачальників стандартів AI-інфраструктури;
- сумісних між собою AI-платформ на основі Kubernetes;
- узгодженої операційної поведінки для AI-навантажень;
- і спільних вимог для масштабованого розгортання AI.
FK: Робочі групи за своєю природою тимчасові й орієнтовані на результат: чи можна сказати, що головні цілі WG було досягнуто?
Janet і Yuan: Так, WG досягла своїх головних початкових цілей.
WG досягла успіху в переході екосистеми від фрагментованих, специфічних для окремих постачальників підходів до AI-інфраструктури до спільної, визначеної спільнотою базової лінії для AI-навантажень у Kubernetes.
Серед конкретних показників успіху:
- запуск програми Certified Kubernetes AI Conformance;
- визначення формальних вимог Kubernetes AI Requirements (KARs);
- широка участь провідних гравців екосистеми;
- зростання кількості сертифікованих платформ з 18 до 31 за кілька місяців;
- узгодження щодо новіших примітивів Kubernetes, потрібних для AI-навантажень;
- формування дорожньої карти для автоматизованої перевірки відповідності.
Найголовніше — WG сформувала консенсус щодо того, що AI-навантаження тепер є першорядним сценарієм використання Kubernetes.
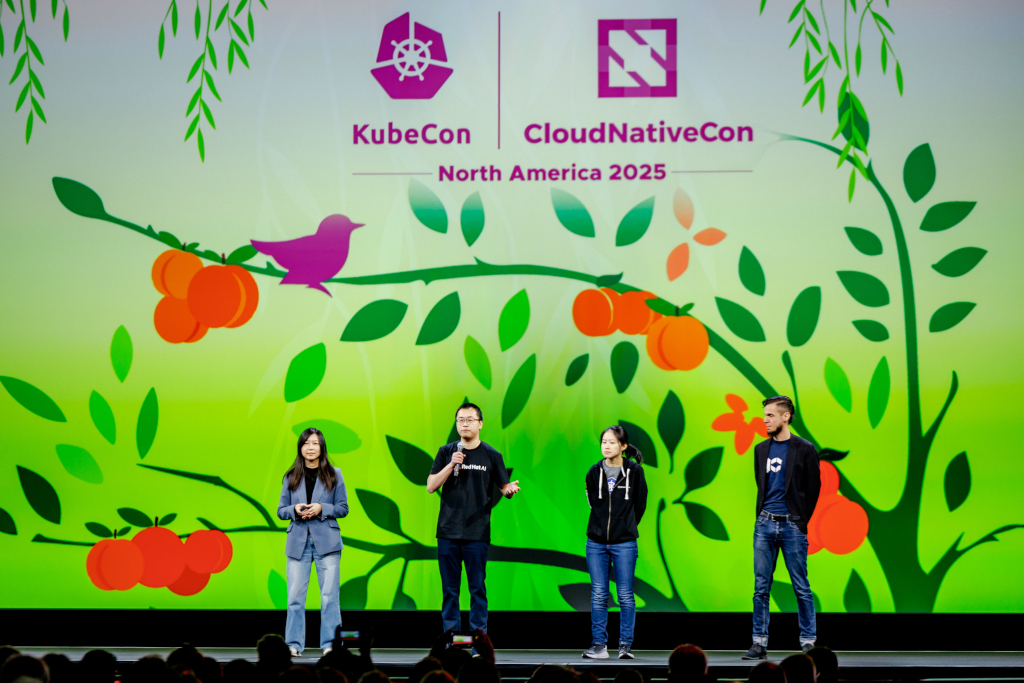
FK: AI Conformance було окремо відзначено на останньому KubeCon — чи є це відображенням зростання важливості AI в межах усього проєкту?
Janet і Yuan: Так, те, наскільки помітною була тема AI Conformance на останньому KubeCon + CloudNativeCon, — яскраве свідчення того, наскільки центральним AI став для всієї екосистеми Kubernetes.
Кілька років тому AI-навантаження в Kubernetes все ще вважалися доволі спеціалізованими й переважно повʼязаними з ML-платформами чи дослідницькими середовищами з великим обсягом GPU. Що змінилося — те, що AI тепер стає мейнстримною інфраструктурною проблемою майже для кожного великомасштабного оператора платформ.
Цей зсув природно підносить AI від застосунку, що працює в Kubernetes, до ключової категорії навантажень, для якої Kubernetes має оптимізуватися.
Ініціатива AI Conformance відображає цю еволюцію. Вона сигналізує, що спільнота тепер вважає вимоги до AI-інфраструктури — як-от планування прискорювачів, високопродуктивні мережі, оркестрацію з урахуванням навантаження та інференс із низькою затримкою — достатньо важливими, щоб стандартизувати їх на рівні екосистеми.
Її помітність на KubeCon також свідчить про ширше стратегічне усвідомлення: якщо Kubernetes має залишатися універсальною панеллю управління для сучасної інфраструктури, йому потрібно забезпечувати узгоджену основу для AI-навантажень у хмарних, локальних і периферійних середовищах.
Тож наголос на AI Conformance — це не просто гонитва за ажіотажем навколо AI; це про те, що Kubernetes адаптується до значного зсуву в моделях навантажень і забезпечує згуртований розвиток екосистеми, а не її розпад на специфічні для кожного постачальника AI-стеки.
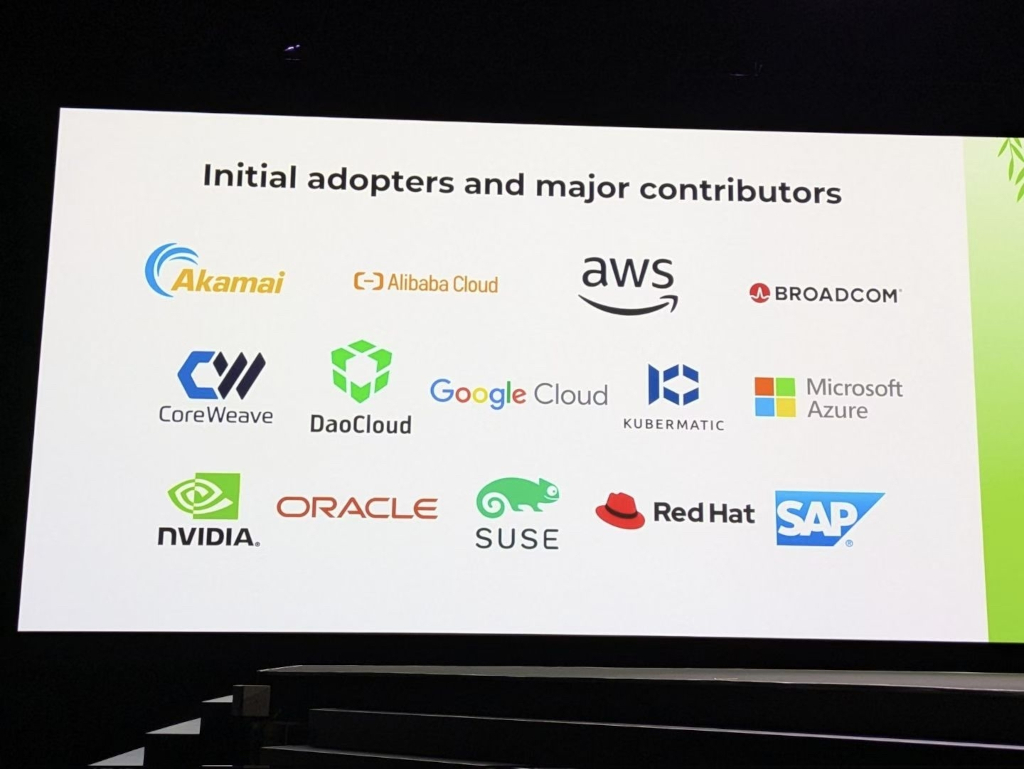
Від робочої групи до підпроєкту SIG Architecture
FK: Як би ви описали перехід від WG до SIG? Чи є це відображенням того, що AI потребує постійного архітектурного нагляду?
Janet і Yuan: У Kubernetes робочі групи задумані як тимчасові. Наша WG мала конкретну мету — опублікувати початкові вимоги Kubernetes AI Conformance і запустити процес сертифікації. Щойно ми досягли цих віх, ми заархівували WG і перевели AI Conformance у статус постійного підпроєкту під егідою SIG Architecture.
Перехід до SIG Architecture безперечно доводить, що AI потребує постійного нагляду. AI — це не просто минуща тенденція чи разове навантаження. Він став ключовою частиною того, що Kubernetes запускає щодня. Оскільки SIG Architecture вже опікується загальною відповідністю Kubernetes і принципами проєктування API, розміщення підпроєкту AI Conformance саме там цілком логічне. Це гарантує, що наші вимоги AI Conformance залишатимуться узгодженими з рештою екосистеми Kubernetes у довгостроковій перспективі.
FK: І з урахуванням цієї зміни, як би ви описали головні цілі та сфери втручання підпроєкту?
Janet і Yuan: Тепер, коли ми є підпроєктом, наша головна мета — підтримувати стандарти AI Conformance актуальними, нейтральними щодо постачальників і такими, що встановлюють стандарти. Ми хочемо, щоб Kubernetes охоплював найновіші досягнення в AI-інфраструктурі й водночас зберігав екосистему справедливою для всіх. Коли ми виявляємо прогалини, де немає чіткого зразка спільноти, ми допомагаємо виростити й сформувати нові стандарти для їх розвʼязання.
AI Conformance і Kubernetes
FK: AI-інфраструктура розвивається дуже швидко, тоді як API Kubernetes створені, щоб залишатися стабільними протягом років. Чи вважаєте ви це викликом?
Janet і Yuan: Це, безумовно, непростий баланс. AI рухається дуже швидко, тоді як Kubernetes створений бути стабільним і передбачуваним. Але ми насправді побудували програму саме навколо цієї напруги.
По-перше, ми використовуємо багаторівневу модель поетапного підвищення. Коли зʼявляються нові концепції AI-інфраструктури, ми вводимо їх як рекомендовані вимоги SHOULD. Це дає екосистемі простір експериментувати й домовлятися про найкращі практики, не привʼязуючи Kubernetes до жорстких API занадто рано. Коли ці API стабілізуються й набувають поширення в екосистемі, ми підвищуємо їх до обовʼязкових вимог MUST.
По-друге, ми навмисно зосереджуємося на інфраструктурному рівні. Ми перевіряємо ключові можливості, як-от підтримку прискорювачів через динамічне виділення ресурсів (DRA), замість того щоб грузнути в конкретних AI-фреймворках чи серверах моделей. Це зберігає базову платформу стабільною, дозволяючи AI-інструментарію розвиватися так швидко, як потрібно.
FK: DRA розвинувся, зокрема завдяки роботі WG Device Management, як важлива частина Kubernetes (особливо для AI-навантажень), і SIG Architecture відіграє важливу роль у тому, як його інтегровано в Kubernetes: чи вбачаєте ви в цьому паралель? Зокрема, чи вважаєте ви, що акцент на інтеграції з архітектурою Kubernetes, що розвивається, посилиться в межах SIG Architecture?
Janet і Yuan: Тут є величезна паралель. Щоразу, коли ми стикаємося з масштабним, складним викликом, який зачіпає кілька частин кодової бази та стосується кількох SIG, робоча група — найкраще місце для початку. Вона дає експертам з різних SIG зібратися разом, щоб розібратися з проблемою й вибудувати консенсус.
Будучи частиною SIG Architecture, ми приділятимемо набагато більше уваги тому, як можливості AI вплітаються в архітектуру Kubernetes, що розвивається. Замість того щоб розглядати AI як додатковий шар, ми дивимося, як ключові примітиви Kubernetes, як-от планування та виділення ресурсів, мають адаптуватися на фундаментальному рівні, щоб підтримувати наступне десятиліття AI-навантажень.
Завершальні зауваження
FK: Для зацікавлених контрибʼюторів — який найкращий спосіб долучитися до підпроєкту AI Conformance?
Janet і Yuan: Ми завжди шукаємо нових контрибʼюторів. Найпростіший спосіб почати — зазирнути до нашого головного репозиторію kubernetes-sigs/ai-conformance і долучитися до наших зустрічей. Якщо вам цікаво визначати нові вимоги AI Conformance, ви можете долучитися до рецензування PR або запропонувати власні, скориставшись нашим шаблоном KAR. Якщо ви хочете писати код, нам завжди потрібна допомога в розширенні наших автоматизованих наборів тестів на Go у каталозі test/.
Постачальникам, які бажають сертифікувати свої платформи, усі подробиці — у cncf/k8s-ai-conformance.
FK: Чи є якісь завершальні коментарі, якими ви хотіли б поділитися?
Janet і Yuan: Ми вражені тим, як швидко спільнота згуртувалася навколо цього. Коли ми вперше оголосили програму AI Conformance під час пленарної доповіді на KubeCon NA 2025, ми не були впевнені, якою буде реакція. Але на момент, коли ми виступали з оновленою доповіддю на KubeCon EU 2026, ми зросли з 18 сертифікованих платформ до 31 лише за кілька місяців.
Таке зростання показує, наскільки галузь прагнула єдиного, нейтрального щодо постачальників стандарту. Це дає організаціям упевненість, що вони можуть запускати свої AI-навантаження на будь-якій сертифікованій платформі Kubernetes, не потрапляючи в залежність від пропрієтарного стека.
Якщо ви постачальник платформи, ми будемо раді бачити вас серед сертифікованих. Якщо ви розробник, якого цікавить перетин AI та хмарно-нативної інфраструктури, долучайтеся до нас у SIG Architecture!
FK: Чудово, дякуємо вам обом за те, що провели нас цією подорожжю світом AI та AI Conformance у Kubernetes.
Це дзеркало оригінальної статті.