Огляд адміністрування кластера призначений для всіх, хто створює кластер Kubernetes або адмініструє його. Він передбачає певне знайомство з основними концепціями Kubernetes.
Планування кластера
Приклади планування, встановлення та налаштування кластерів Kubernetes дивіться в посібниках у розділі Встановлення. Рішення, перелічені в цій статті, називаються дистрибутивами (distros).
Примітка:
Не всі дистрибутиви активно підтримуються. Вибирайте дистрибутиви, протестовані з нещодавньою версією Kubernetes.
Перед вибором посібника врахуйте таке:
Ви хочете спробувати Kubernetes на своєму компʼютері чи побудувати високодоступний кластер із кількома вузлами? Вибирайте дистрибутиви, які найкраще відповідають вашим потребам.
Ви використовуватимете кластер Kubernetes на хостингу, такий як Google Kubernetes Engine, чи розміщуватимете власний кластер?
Ваш кластер буде on-premises чи у хмарі (IaaS)? Kubernetes не підтримує гібридні кластери безпосередньо. Натомість ви можете налаштувати кілька кластерів.
Якщо ви налаштовуєте Kubernetes on-premises, визначте, яка мережева модель підходить найкраще.
Ви запускатимете Kubernetes на фізичному обладнанні (bare metal) чи на віртуальних машинах (VM)?
Ви хочете просто запустити кластер чи плануєте активно розробляти код проєкту Kubernetes? В останньому випадку виберіть дистрибутив, що активно розвивається. Деякі дистрибутиви використовують лише бінарні випуски, але пропонують ширший вибір.
Ознайомтеся з компонентами, необхідними для запуску кластера.
У кластері Kubernetes вузол може бути вимкнено планово й коректно або несподівано через такі причини, як відключення живлення чи інші зовнішні обставини. Вимкнення вузла може призвести до збою робочого навантаження, якщо перед вимкненням для вузла не виконано drain. Вимкнення вузла може бути коректним (graceful) або некоректним (non-graceful).
Увага:
Пакунок unattended-upgrades з Debian у своїй звичайній конфігурації конфліктує з коректним вимкненням вузла. Якщо ви використовуєте стандартну конфігурацію unattended-upgrades, яка змінює період коректного завершення під час вимкнення сервера, kubelet не зможе отримати блокування, потрібне для правильної обробки подій вимкнення.
Це відбувається, якщо значення shutdownGracePeriod перевищує 30 секунд. Щоб уникнути цього, ви можете приглушити частину конфігурації unattended-upgrades, зробивши /etc/systemd/logind.conf.d/unattended-upgrades-logind-maxdelay.conf символічним посиланням на /dev/null.
kubelet намагається виявити вимкнення системи вузла та завершує Podʼи, що працюють на вузлі.
kubelet забезпечує, щоб під час вимкнення вузла Podʼи проходили звичайний процес завершення Podʼа. Під час вимкнення вузла kubelet не приймає нові Podʼи (навіть якщо ці Podʼи вже привʼязані до вузла).
Увімкнення коректного вимкнення вузла
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.21; (стандартно увімкнено)
У Linux коректним вимкненням вузла керує функціональна можливість GracefulNodeShutdown, яку стандартно ввімкнено у версії 1.21.
Примітка:
Коректне вимкнення вузла залежить від systemd, оскільки використовує блокування інгібіторів systemd, щоб затримати вимкнення вузла на заданий час.
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.34; (стандартно увімкнено)
У Windows коректним вимкненням вузла керує функціональна можливість WindowsGracefulNodeShutdown, яку запроваджено у версії 1.32 як альфа-можливість. У Kubernetes 1.34 ця можливість перебуває на стадії бета й стандартно ввімкнена.
Примітка:
Коректне вимкнення вузла у Windows залежить від того, чи працює kubelet як служба Windows; тоді він матиме зареєстрований обробник керування службою, щоб затримати подію preshutdown на заданий час.
Коректне вимкнення вузла у Windows неможливо скасувати.
Якщо kubelet не працює як служба Windows, він не зможе встановити та відстежувати подію Preshutdown, і вузлу доведеться пройти процедуру некоректного вимкнення вузла, згадану вище.
Якщо коректне вимкнення вузла у Windows ввімкнено, але kubelet не працює як служба Windows, kubelet продовжить працювати, а не завершиться збоєм. Однак він запише в лог помилку про те, що його потрібно запускати як службу Windows.
Налаштування коректного вимкнення вузла
Зверніть увагу, що стандартно обидва параметри конфігурації, описані нижче, shutdownGracePeriod та shutdownGracePeriodCriticalPods, мають нульове значення, тому коректне вимкнення вузла не активоване. Щоб активувати цю можливість, обидва параметри потрібно правильно налаштувати, встановивши ненульові значення.
Щойно kubelet отримує сповіщення про вимкнення вузла, він встановлює на Node стан NotReady із reason зі значенням "node is shutting down". kube-scheduler враховує цей стан і не планує жодних Podʼів на цей вузол; очікується, що інші сторонні планувальники дотримуватимуться такої самої логіки. Це означає, що нові Podʼи не плануватимуться на цей вузол, а отже, жоден із них не запуститься.
kubelet також відхиляє Podʼи під час фази PodAdmission, якщо виявлено поточне вимкнення вузла, тому навіть Podʼи з toleration для node.kubernetes.io/not-ready:NoSchedule там не запустяться.
Коли kubelet встановлює цей стан на своєму Node через API, він також починає завершувати всі Podʼи, що працюють локально.
Під час коректного вимкнення kubelet завершує Podʼи у дві фази:
Визначає загальний час, на який вузол має затримати вимкнення. Це загальний період коректного завершення для звичайних і критичних Podʼів.
shutdownGracePeriodCriticalPods:
Визначає час, який використовується для завершення критичних Podʼів під час вимкнення вузла. Це значення має бути меншим за shutdownGracePeriod.
Примітка:
Є випадки, коли вимкнення вузла було скасовано системою (або, можливо, вручну адміністратором). У будь-якому з цих випадків вузол повернеться до стану Ready. Однак Podʼи, які вже розпочали процес завершення, не будуть відновлені kubelet і їх потрібно буде перепланувати.
Наприклад, якщо shutdownGracePeriod=30s, а shutdownGracePeriodCriticalPods=10s, kubelet затримає вимкнення вузла на 30 секунд. Під час вимкнення перші 20 (30-10) секунд буде зарезервовано для коректного завершення звичайних Podʼів, а останні 10 секунд — для завершення критичних Podʼів.
Примітка:
Коли Podʼи виселяються під час коректного вимкнення вузла, вони позначаються як вимкнені. Команда kubectl get pods показує статус виселених Podʼів як Terminated. А kubectl describe pod вказує, що Pod було виселено через вимкнення вузла:
Reason:         Terminated
Message:        Pod was terminated in response to imminent node shutdown.
Коректне вимкнення вузла на основі пріоритету Podʼів
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.24; (стандартно увімкнено)
Щоб забезпечити більшу гнучкість щодо порядку завершення Podʼів під час коректного вимкнення вузла, воно враховує PriorityClass Podʼів, за умови, що ви ввімкнули цю можливість у своєму кластері. Ця можливість дозволяє адміністраторам кластера явно визначати порядок завершення Podʼів під час коректного вимкнення вузла на основі класів пріоритету.
Можливість коректного вимкнення вузла, описана вище, вимикає Podʼи у дві фази: спочатку некритичні Podʼи, а потім критичні. Якщо потрібна додаткова гнучкість, щоб явно й докладніше визначити порядок Podʼів під час вимкнення, можна використовувати коректне вимкнення на основі пріоритету Podʼів.
Коли коректне вимкнення вузла враховує пріоритети Podʼів, його можна виконувати в кілька фаз, кожна з яких вимикає Podʼи певного класу пріоритету. У kubelet можна налаштувати конкретні фази та час вимкнення для кожної фази.
Наведена вище таблиця означає, що будь-який Pod зі значенням priority >= 100000 отримає лише 10 секунд на вимкнення, будь-який Pod зі значенням >= 10000 і < 100000 отримає 180 секунд на вимкнення, будь-який Pod зі значенням >= 1000 і < 10000 отримає 120 секунд на вимкнення. Нарешті, усі інші Podʼи отримають 60 секунд на вимкнення.
Не обовʼязково вказувати значення, відповідні всім класам. Наприклад, можна використовувати ці налаштування:
Значення класу пріоритету Podʼа
Період вимкнення
100000
300 секунд
1000
120 секунд
0
60 секунд
У цьому випадку Podʼи з custom-class-b потраплять до тієї самої групи вимкнення, що й custom-class-c.
Якщо в певному діапазоні немає Podʼів, kubelet не чекає на Podʼи в цьому діапазоні пріоритетів. Натомість kubelet одразу переходить до наступного діапазону значень класу пріоритету.
Якщо цю можливість увімкнено, а конфігурацію не надано, жодних дій з упорядкування не виконується.
Щоб використовувати цю можливість, потрібно ввімкнути функціональну можливість GracefulNodeShutdownBasedOnPodPriority і встановити в ShutdownGracePeriodByPodPriority у конфігурації kubelet потрібну конфігурацію зі значеннями класів пріоритету Podʼів та відповідними періодами вимкнення.
Примітка:
Можливість враховувати пріоритет Podʼів під час коректного вимкнення вузла запроваджено як альфа-можливість у Kubernetes v1.23. У Kubernetes 1.37 ця можливість перебуває на стадії бета й стандартно ввімкнена.
Метрики graceful_shutdown_start_time_seconds та graceful_shutdown_end_time_seconds надаються в підсистемі kubelet для моніторингу вимкнень вузлів.
Обробка некоректного вимкнення вузла
This is a stable feature in Kubernetes, and has been since the 1.28 release. You can no longer toggle this feature (the associated feature gate has been removed).
Вимкнення вузла може не виявити Node Shutdown Manager у kubelet — або тому, що команда не активує механізм блокування інгібіторів, який використовує kubelet, або через помилку користувача, тобто неправильне налаштування ShutdownGracePeriod та ShutdownGracePeriodCriticalPods. Докладніше дивіться в розділі Коректне вимкнення вузла вище.
Коли вузол вимкнено, але Node Shutdown Manager у kubelet цього не виявив, Podʼи, що входять до StatefulSet, застрягнуть у стані завершення на вимкненому вузлі та не зможуть перейти на новий запущений вузол. Це тому, що kubelet на вимкненому вузлі недоступний для видалення Podʼів, тому StatefulSet не може створити новий Pod з такою самою назвою. Якщо Podʼи використовують томи, VolumeAttachments не буде видалено з початкового вимкненого вузла, тому томи, які використовують ці Podʼи, не можна підʼєднати до нового запущеного вузла. Унаслідок цього застосунок, що працює в StatefulSet, не може функціонувати належним чином. Якщо початковий вимкнений вузол знову запрацює, kubelet видалить Podʼи, а нові Podʼи буде створено на іншому запущеному вузлі. Якщо початковий вимкнений вузол не запрацює, ці Podʼи назавжди застрягнуть у стані завершення на вимкненому вузлі.
Щоб помʼякшити цю ситуацію, користувач може вручну додати taint node.kubernetes.io/out-of-service з ефектом NoExecute або NoSchedule до вузла, позначивши його як виведений з експлуатації. Якщо вузол позначено цим taint, Podʼи на вузлі буде примусово видалено, якщо вони не мають відповідних tolerations, а операції відʼєднання томів для Podʼів, що завершуються на вузлі, відбудуться негайно. Це дозволяє Podʼам з виведеного з експлуатації вузла швидко відновитися на іншому вузлі.
Під час некоректного вимкнення Podʼи завершуються у дві фази:
Примусово видаляються Podʼи, які не мають відповідних tolerations out-of-service.
Негайно виконується операція відʼєднання томів для таких Podʼів.
Примітка:
Перш ніж додавати taint node.kubernetes.io/out-of-service, слід перевірити, що вузол уже вимкнений або знеструмлений (а не перебуває в процесі перезапуску).
Користувач має вручну видалити taint out-of-service після того, як Podʼи буде переміщено на новий вузол і користувач перевірить, що вимкнений вузол відновився, оскільки саме користувач додав цей taint.
Примусове відʼєднання сховища за тайм-аутом
У будь-якій ситуації, коли видалення Podʼа не вдалося протягом 6 хвилин, Kubernetes примусово відʼєднає томи, що розмонтовуються, якщо в цей момент вузол несправний. Будь-яке робоче навантаження, що все ще працює на вузлі й використовує примусово відʼєднаний том, спричинить порушення специфікації CSI, згідно з якою ControllerUnpublishVolume «має викликатися після того, як усі виклики NodeUnstageVolume та NodeUnpublishVolume для тому виконано й вони успішно завершилися». За таких обставин томи на цьому вузлі можуть зазнати пошкодження даних.
Примусове відʼєднання сховища є необовʼязковим; користувачі можуть натомість скористатися можливістю «Non-graceful node shutdown».
Примусове відʼєднання сховища за тайм-аутом можна вимкнути, встановивши поле конфігурації disable-force-detach-on-timeout у kube-controller-manager. Вимкнення цієї можливості означає, що для тому, розміщеного на вузлі, який несправний понад 6 хвилин, повʼязаний VolumeAttachment не буде видалено.
Після застосування цього налаштування несправні Podʼи, все ще приєднані до томів, потрібно відновлювати за допомогою процедури обробки некоректного вимкнення вузла, згаданої вище.
Kubernetes можна налаштувати на використання своп-памʼяті на вузлі, що дозволяє ядру звільняти фізичну памʼять, витісняючи сторінки до резервного сховища. Це корисно в багатьох сценаріях. Наприклад, на вузлах, де працюють робочі навантаження, яким може бути корисний своп, зокрема ті, що займають багато памʼяті, але в кожен момент часу звертаються лише до її частини. Своп також допомагає запобігти завершенню Podʼів під час стрибків тиску на памʼять, захищає вузли від стрибків використання памʼяті на рівні системи, які можуть порушити їх стабільність, дозволяє гнучкіше керувати памʼяттю на вузлі й багато іншого.
Вузли Linux підтримують своп; для його увімкнення потрібно налаштувати кожен вузол. Стандартно kubelet не запускається на вузлі Linux, на якому увімкнено своп.
Вузли Windows потребують простору свопу. Стандартно kubelet не запускається на вузлі Windows, на якому вимкнено своп.
Як це працює?
Використання свопу на вузлі можна уявити кількома способами. Якщо kubelet уже працює на вузлі, після налаштування свопу його потрібно перезапустити, щоб він виявив своп.
Коли kubelet запускається на вузлі, на якому своп налаштовано й доступно (з конфігурацією failSwapOn: false), kubelet:
Зможе запуститися на цьому вузлі з увімкненим свопом.
Вказуватиме реалізації Container Runtime Interface (CRI), яку часто називають середовищем виконання контейнерів, стандартно виділяти робочим навантаженням Kubernetes нульовий обсяг своп-памʼяті.
Конфігурація свопу на вузлі доступна адміністратору кластера через memorySwap у KubeletConfiguration. Як адміністратор кластера ви можете вказати поведінку вузла за наявності своп-памʼяті, встановивши memorySwap.swapBehavior.
Поведінка свопу
Вам потрібно вибрати поведінку свопу. Різні вузли у вашому кластері можуть використовувати різну поведінку свопу.
Для вузлів Linux можна вибрати таку поведінку свопу:
NoSwap (стандартно)
Робочі навантаження, що працюють як Podʼи на цьому вузлі, не використовують і не можуть використовувати своп.
LimitedSwap
Робочі навантаження Kubernetes можуть використовувати своп-памʼять.
Примітка:
Якщо ви виберете поведінку NoSwap і налаштуєте kubelet на допуск простору свопу (failSwapOn: false), ваші робочі навантаження не використовуватимуть своп.
Однак процеси поза контейнерами під керуванням Kubernetes, такі як сервіси systemd (і навіть сам kubelet!), можуть використовувати своп.
kubelet використовує API середовища виконання контейнерів і вказує йому застосувати певну конфігурацію (наприклад, для cgroup v2 — memory.swap.max) так, щоб увімкнути бажану конфігурацію свопу для контейнера. Для середовищ виконання, які використовують контрольні групи (cgroups), середовище виконання контейнерів відповідає за запис цих налаштувань до cgroup на рівні контейнера.
Спостережуваність використання свопу
Статистика метрик на рівні вузла та контейнера
kubelet тепер збирає статистику метрик на рівні вузла та контейнера, доступну через HTTP-точки доступу kubelet /metrics/resource (її використовують переважно інструменти моніторингу, такі як Prometheus) та /stats/summary (її використовують переважно автомасштабувальники). Це дозволяє клієнтам, які можуть безпосередньо надсилати запити до kubelet, відстежувати використання свопу та залишок своп-памʼяті під час використання LimitedSwap. Крім того, до cadvisor додано метрику machine_swap_bytes, яка показує загальну фізичну місткість свопу машини. Докладніше дивіться на цій сторінці.
Наприклад, підтримуються такі /metrics/resource:
node_swap_usage_bytes: поточне використання свопу вузлом у байтах.
container_swap_usage_bytes: поточне використання свопу контейнером у байтах.
container_swap_limit_bytes: поточне обмеження свопу контейнера в байтах.
Використання kubectl top --show-swap
Запити до метрик корисні, але дещо незручні, оскільки ці метрики призначені для програмного забезпечення, а не для людей. Щоб отримувати ці дані зручнішим способом, команду kubectl top розширено підтримкою метрик свопу через прапорець --show-swap.
Щоб отримати інформацію про використання свопу на вузлах, можна використовувати kubectl top nodes --show-swap:
Значення <unknown> вказує на те, що поле .status.nodeInfo.swap.capacity не встановлено для цього вузла. Імовірно, це означає, що на вузлі не налаштовано своп або, менш імовірно, що kubelet не може визначити місткість свопу вузла.
Виявлення свопу за допомогою Node Feature Discovery (NFD)
Node Feature Discovery — це надбудова Kubernetes для виявлення апаратних можливостей і конфігурації. Її можна використовувати, щоб виявити, на яких вузлах налаштовано своп.
Наприклад, щоб зʼясувати, на яких вузлах налаштовано своп, використайте таку команду:
kubectl get nodes -o jsonpath='{range .items[?(@.metadata.labels.feature\.node\.kubernetes\.io/memory-swap)]}{.metadata.name}{"\t"}{.metadata.labels.feature\.node\.kubernetes\.io/memory-swap}{"\n"}{end}'
У цьому прикладі своп налаштовано на вузлах k8s-worker1 та k8s-worker2, але не на k8s-worker3.
Ризики та застереження
Увага:
Настійно рекомендується шифрувати простір свопу. Докладніше дивіться в розділі томи в памʼяті.
Наявність свопу в системі знижує передбачуваність. Хоча своп може підвищити продуктивність, роблячи доступною більше оперативної памʼяті, повернення даних у памʼять є важкою операцією, іноді повільнішою на багато порядків, що може призвести до неочікуваного зниження продуктивності. Крім того, своп змінює поведінку системи під тиском на памʼять. Увімкнення свопу збільшує ризик галасливих сусідів, коли Podʼи, що часто використовують свою оперативну памʼять, можуть спричиняти витіснення інших Podʼів до свопу. Крім того, оскільки своп дозволяє робочим навантаженням у Kubernetes використовувати більше памʼяті, ніж можна передбачувано врахувати, а також через неочікувані конфігурації пакування, планувальник наразі не враховує використання своп-памʼяті. Це підвищує ризик галасливих сусідів.
Продуктивність вузла з увімкненою своп-памʼяттю залежить від фізичного сховища. Під час використання своп-памʼяті продуктивність буде значно гіршою в середовищі з обмеженою кількістю операцій вводу-виводу за секунду (IOPS), наприклад у хмарній віртуальній машині з тротлінгом вводу-виводу, порівняно зі швидшими носіями, такими як твердотільні накопичувачі або NVMe. Оскільки своп може спричиняти тиск на ввід-вивід, рекомендується надавати критично важливим системним демонам вищий пріоритет затримки вводу-виводу. Дивіться відповідний розділ у рекомендаціях нижче.
Томи в памʼяті
На вузлах Linux томи в памʼяті (такі як монтування томів secret або emptyDir з medium: Memory) реалізовано за допомогою файлової системи tmpfs. Вміст таких томів завжди має залишатися в памʼяті, тому його не слід витісняти на диск. Щоб вміст таких томів залишався в памʼяті, використовується параметр noswap для tmpfs.
Ядро Linux офіційно підтримує параметр noswap з версії 6.3 (докладніше дивіться у Вимогах до версії ядра Linux). Однак різні дистрибутиви часто переносять цей параметр монтування й у старіші версії Linux.
Щоб перевірити, чи підтримує вузол параметр noswap, kubelet виконує такі дії:
Якщо версія ядра вища за 6.3, вважається, що параметр noswap підтримується.
В іншому разі kubelet під час запуску спробує змонтувати фіктивний tmpfs з параметром noswap. Якщо kubelet отримає помилку, що вказує на невідомий параметр, вважатиметься, що noswap не підтримується, і його не буде використано. kubelet запише в лог запис, щоб попередити користувача, що томи в памʼяті можуть витіснятися на диск. Якщо kubelet виконає це успішно, фіктивний tmpfs буде видалено, а параметр noswap буде використано.
Якщо параметр noswap не підтримується, kubelet запише в лог попередження, а потім продовжить роботу.
Приклад налаштування свопу дивіться в розділі Налаштування своп-памʼяті на вузлах Kubernetes. Однак обробка зашифрованого свопу не входить до сфери відповідальності kubelet; це загальне питання конфігурації ОС, і його слід вирішувати на цьому рівні. Адміністратор відповідає за налаштування зашифрованого свопу, щоб зменшити цей ризик.
Виселення
Налаштування порогів виселення за памʼяттю для вузлів з увімкненим свопом може бути складним завданням.
Якщо своп вимкнено, доцільно налаштувати пороги виселення kubelet трохи нижче за місткість памʼяті вузла. Причина в тому, що Kubernetes має почати виселяти Podʼи до того, як на вузлі закінчиться памʼять і буде викликано OOM killer (Out Of Memory), оскільки OOM killer нічого не знає про Kubernetes, тому не враховує такі речі, як QoS, пріоритет Podʼів чи інші специфічні для Kubernetes чинники.
З увімкненим свопом ситуація складніша. У Linux параметр vm.min_free_kbytes визначає поріг памʼяті, за якого ядро починає агресивно вивільняти памʼять, зокрема витісняти сторінки до свопу. Якщо пороги виселення kubelet налаштовано так, що виселення відбувається раніше, ніж ядро почне вивільняти памʼять, робочі навантаження можуть ніколи не встигнути витіснити дані до свопу під час тиску на памʼять вузла. Однак занадто високі пороги виселення можуть призвести до вичерпання памʼяті на вузлі та виклику OOM killer, що теж не ідеально.
Щоб розвʼязати цю проблему, рекомендується встановлювати пороги виселення kubelet трохи нижчими за значення vm.min_free_kbytes. Так вузол може почати використовувати своп до того, як kubelet почне виселяти Podʼи, що дозволяє робочим навантаженням витісняти невикористовувані дані до свопу й запобігає виселенню. З іншого боку, оскільки значення лише трохи нижче, kubelet, імовірно, почне виселяти Podʼи до того, як на вузлі закінчиться памʼять, тим самим уникаючи OOM killer.
Значення vm.min_free_kbytes можна визначити, виконавши на вузлі таку команду:
cat /proc/sys/vm/min_free_kbytes
Невикористаний простір свопу
У режимі LimitedSwap обсяг свопу, доступний для Podʼа, визначається автоматично на основі частки запитаної памʼяті відносно загальної памʼяті вузла (докладніше дивіться розділ нижче).
Така архітектура означає, що зазвичай певна частина свопу залишатиметься недоступною для робочих навантажень Kubernetes. Наприклад, оскільки Kubernetes 1.37 не дозволяє використовувати своп Podʼам із класом QoS Guaranteed, обсяг свопу, пропорційний запиту памʼяті Podʼів Guaranteed, залишатиметься невикористаним робочими навантаженнями Kubernetes.
Така поведінка несе певний ризик у ситуації, коли багато Podʼів не мають права на своп. З іншого боку, вона фактично зберігає певний зарезервований системою обсяг своп-памʼяті, який можуть використовувати процеси поза межами Kubernetes, такі як системні демони й навіть сам kubelet.
Рекомендації щодо використання свопу в кластері Kubernetes
Вимкнення свопу для критично важливих системних демонів
Під час тестування та на основі відгуків користувачів було помічено, що продуктивність критично важливих системних демонів і сервісів може знижуватися. Це означає, що системні демони, зокрема kubelet, можуть працювати повільніше, ніж зазвичай. Якщо ви зіткнулися з цією проблемою, рекомендується налаштувати cgroup для system slice так, щоб запобігти свопінгу (тобто встановити memory.swap.max=0).
Захист критично важливих системних демонів від затримок вводу-виводу
Своп може збільшити навантаження вводу-виводу на вузлі. Коли тиск на памʼять змушує ядро швидко витісняти сторінки до свопу й повертати їх, критично важливі системні демони й сервіси, що покладаються на операції вводу-виводу, можуть зазнати зниження продуктивності.
Щоб помʼякшити це, користувачам systemd рекомендується надавати пріоритет system slice щодо затримки вводу-виводу. Користувачам без systemd рекомендується налаштувати окрему cgroup для системних демонів і процесів та так само надати їй пріоритет щодо затримки вводу-виводу. Цього можна досягти, встановивши io.latency для system slice, що надає йому вищий пріоритет вводу-виводу. Докладніше дивіться в документації cgroup.
Своп та вузли панелі управління
Проєкт Kubernetes рекомендує запускати вузли панелі управління без налаштованого простору свопу. Панель управління переважно розміщує Podʼи з класом QoS Guaranteed, тому своп зазвичай можна вимкнути. Основна проблема полягає в тому, що свопінг критично важливих сервісів на панелі управління може негативно вплинути на продуктивність.
Використання виділеного диска для свопу
Проєкт Kubernetes рекомендує використовувати зашифрований своп щоразу, коли ви запускаєте вузли з увімкненим свопом. Якщо своп розташований на розділі або в кореневій файловій системі, робочі навантаження можуть заважати системним процесам, яким потрібно записувати на диск. Коли вони використовують той самий диск, процеси можуть перевантажити своп, порушуючи ввід-вивід kubelet, середовища виконання контейнерів і systemd, що вплине на інші робочі навантаження. Оскільки простір свопу розташований на диску, важливо переконатися, що диск достатньо швидкий для запланованих сценаріїв. Альтернативно можна налаштувати пріоритети вводу-виводу між різними відображеними областями одного пристрою зберігання.
Планування з урахуванням свопу
Kubernetes 1.37 не підтримує розподіл Podʼів по вузлах з урахуванням використання своп-памʼяті. Планувальник зазвичай використовує запити ресурсів інфраструктури для вибору розміщення Podʼів, а Podʼи не запитують простір свопу; вони запитують лише memory. Це означає, що планувальник не враховує своп-памʼять під час прийняття рішень щодо планування. Хоча ми активно працюємо над цим, це ще не реалізовано.
Щоб Podʼи не планувалися на вузли зі своп-памʼяттю, якщо вони спеціально не призначені для її використання, адміністратори можуть додати taints на вузли з доступним свопом і так захиститися від цієї проблеми. Taints гарантують, що робочі навантаження, які допускають своп, не перетікатимуть під навантаженням на вузли без свопу.
Вибір сховища для оптимальної продуктивності
Пристрій зберігання, призначений для простору свопу, критично важливий для збереження чутливості системи під час високого використання памʼяті. Обертові жорсткі диски (HDD) погано підходять для цього, оскільки їх механічна природа вносить значну затримку, що призводить до серйозного зниження продуктивності та пробуксовування системи (thrashing). Для сучасних вимог до продуктивності, ймовірно, відповідним вибором для свопу є такий пристрій, як твердотільний накопичувач (SSD), оскільки його електронний доступ із низькою затримкою мінімізує сповільнення.
Подробиці поведінки свопу
Як визначається обмеження свопу для LimitedSwap?
Конфігурація своп-памʼяті, зокрема її обмежень, є значним викликом. Її не лише легко налаштувати неправильно, але й, оскільки це властивість рівня системи, будь-яке неправильне налаштування може поставити під загрозу весь вузол, а не лише конкретне робоче навантаження. Щоб зменшити цей ризик і забезпечити справність вузла, ми реалізували своп з автоматичною конфігурацією обмежень.
З LimitedSwap Podʼам, які не належать до класу QoS Burstable (тобто Podʼам із класом QoS BestEffort/Guaranteed), заборонено використовувати своп-памʼять. Podʼи з класом QoS BestEffort мають непередбачувані шаблони споживання памʼяті, а інформації про використання ними памʼяті немає, тому важко визначити безпечний обсяг своп-памʼяті. Натомість Podʼи з класом QoS Guaranteed зазвичай використовують для застосунків, які покладаються на точне виділення ресурсів, заданих робочим навантаженням, і на негайну доступність памʼяті. Щоб зберегти згадані вище гарантії безпеки та справності вузла, цим Podʼам не дозволено використовувати своп-памʼять, коли діє LimitedSwap. Крім того, високопріоритетним Podʼам не дозволено використовувати своп, щоб памʼять, яку вони споживають, завжди перебувала в RAM і була готова до використання.
Перш ніж докладно описати обчислення обмеження свопу, потрібно визначити такі терміни:
nodeTotalMemory: загальний обсяг фізичної памʼяті, доступної на вузлі.
totalPodsSwapAvailable: загальний обсяг своп-памʼяті на вузлі, доступний для використання Podʼами (частину своп-памʼяті може бути зарезервовано для потреб системи).
Іншими словами, обсяг свопу, який може використовувати контейнер, пропорційний його запиту памʼяті, загальній фізичній памʼяті вузла та загальному обсягу своп-памʼяті на вузлі, доступному для використання Podʼами.
Важливо зазначити, що для контейнерів у Podʼах із класом QoS Burstable можна відмовитися від використання свопу, вказавши запити памʼяті, що дорівнюють обмеженням памʼяті. Контейнери, налаштовані таким чином, не матимуть доступу до своп-памʼяті.
Довідкову інформацію дивіться в початковому KEP, KEP-2400, та його дизайні.
3 - Автомасштабування вузлів
Автоматично надавайте та консолідуйте вузли у вашому кластері, щоб адаптуватися до попиту та оптимізувати витрати.
Щоб запускати робочі навантаження у вашому кластері, вам потрібні вузли. Вузли у вашому кластері можуть автомасштабуватися, тобто динамічно надаватися або консолідуватися, щоб забезпечувати потрібну місткість і водночас оптимізувати витрати. Автомасштабування виконують автомасштабувальники вузлів.
Автомасштабувальники надають вузли, створюючи та видаляючи ресурси хмарного провайдера, на яких ті працюють. Найчастіше такими ресурсами є віртуальні машини.
Головна мета надання вузлів — зробити всі Podʼи придатними для планування. Цієї мети не завжди можна досягти через різні обмеження, зокрема досягнення налаштованих обмежень надання, несумісність конфігурації надання з певним набором Podʼів або брак місткості хмарного провайдера. Під час надання автомасштабувальники вузлів часто намагаються досягти додаткових цілей (наприклад, мінімізувати вартість наданих вузлів або збалансувати кількість вузлів між доменами відмов).
Конфігурація автомасштабувальника може також містити інші тригери надання вузлів (наприклад, падіння кількості вузлів нижче налаштованої мінімальної межі).
Примітка:
Раніше надання було відоме в Cluster Autoscaler як масштабування вгору (scale-up).
Обмеження планування Podʼів
Podʼи можуть задавати обмеження планування, щоб обмежити види вузлів, на яких їх можна запланувати. Автомасштабувальники вузлів враховують ці обмеження, щоб Podʼи в очікуванні можна було запланувати на наданих вузлах.
Найпоширеніший вид обмежень планування — це запити ресурсів, задані контейнерами Podʼів. Автомасштабувальники подбають про те, щоб надані вузли мали достатньо ресурсів для задоволення цих запитів. Однак вони не враховують безпосередньо реальне використання ресурсів Podʼами після їх запуску. Щоб автомасштабувати вузли на основі фактичного використання ресурсів робочими навантаженнями, ви можете поєднати горизонтальне автомасштабування робочих навантажень з автомасштабуванням вузлів.
Обмеження вузлів, що накладаються конфігурацією автомасштабувальника
Характеристики наданих вузлів (наприклад, кількість ресурсів, наявність певної мітки) залежать від конфігурації автомасштабувальника. Автомасштабувальники можуть або вибирати їх із заздалегідь визначеного набору конфігурацій вузлів, або використовувати автоматичне надання.
Автоматичне надання
Автоматичне надання вузлів — це режим надання, у якому користувачеві не потрібно повністю налаштовувати характеристики вузлів, які можуть бути надані. Натомість автомасштабувальник динамічно вибирає конфігурацію вузла на основі Podʼів в очікуванні, на які він реагує, а також попередньо налаштованих обмежень (наприклад, мінімальної кількості ресурсів або потреби в певній мітці).
Консолідація вузлів
Під час роботи кластера головне — щоб усі придатні для планування Podʼи працювали, а вартість кластера залишалася якомога нижчою. Для цього запити ресурсів Podʼів мають використовувати якомога більше ресурсів вузлів. З цього погляду загальне використання вузлів у кластері може слугувати непрямим показником того, наскільки економічно ефективним є кластер.
Примітка:
Правильне налаштування запитів ресурсів ваших Podʼів так само важливе для загальної економічної ефективності кластера, як і оптимізація використання вузлів. Досягти цього допоможе поєднання автомасштабування вузлів з вертикальним автомасштабуванням робочих навантажень.
Вузли у вашому кластері можна автоматично консолідувати, щоб покращити загальне використання вузлів, а отже, й економічну ефективність кластера. Консолідація відбувається через видалення з кластера набору недовикористаних вузлів. За потреби для їх заміни можна надати інший набір вузлів.
Консолідація, як і надання, під час прийняття рішень враховує лише запити ресурсів Podʼів, а не реальне використання ресурсів.
Для цілей консолідації вузол вважається порожнім, якщо на ньому працюють лише Podʼи DaemonSet і статичні Podʼи. Видаляти порожні вузли під час консолідації простіше, ніж непорожні, і автомасштабувальники часто мають оптимізації, створені спеціально для консолідації порожніх вузлів.
Видалення непорожніх вузлів під час консолідації спричиняє порушення — Podʼи, що працюють на них, завершуються, і, можливо, їх доведеться створити заново (наприклад, через Deployment). Однак усі такі перестворені Podʼи мають плануватися на наявні вузли кластера або на вузли-замінники, надані в межах консолідації. Зазвичай жоден Pod не повинен переходити в стан очікування внаслідок консолідації.
Примітка:
Автомасштабувальники передбачають, як перестворений Pod імовірно буде заплановано після надання або консолідації вузла, але вони не контролюють фактичне планування. Через це деякі Podʼи можуть перейти в стан очікування внаслідок консолідації — наприклад, якщо під час консолідації зʼявляється абсолютно новий Pod.
Конфігурація автомасштабувальника може також дозволяти запускати консолідацію за іншими умовами (наприклад, за часом, що минув від створення вузла), щоб оптимізувати інші властивості (наприклад, максимальну тривалість життя вузлів у кластері).
Подробиці виконання консолідації залежать від конфігурації конкретного автомасштабувальника.
Примітка:
Раніше консолідація була відома в Cluster Autoscaler як зменшення масштабу (scale-down).
Автомасштабувальники
Можливості, описані в попередніх розділах, надають автомасштабувальники вузлів. Окрім API Kubernetes, автомасштабувальники також мають взаємодіяти з API хмарних провайдерів, щоб надавати та консолідувати вузли. Це означає, що вони мають бути явно інтегровані з кожним підтримуваним хмарним провайдером. Продуктивність і набір можливостей певного автомасштабувальника можуть відрізнятися залежно від інтеграції з хмарним провайдером.
graph TD
    na[Автомасштабувальник вузлів]
    k8s[Kubernetes]
    cp[Хмарний провайдер]

    k8s --> |отримання Podʼів/вузлів|na
    na --> |drain вузлів|k8s
    na --> |створення/видалення ресурсів вузлів|cp
    cp --> |отримання ресурсів вузлів|na

    classDef white_on_blue fill:#326ce5,stroke:#fff,stroke-width:4px,color:#fff;
    classDef blue_on_white fill:#fff,stroke:#bbb,stroke-width:2px,color:#326ce5;
    class na blue_on_white;
    class k8s,cp white_on_blue;
З погляду користувача кластера обидва автомасштабувальники мають забезпечувати схожий досвід автомасштабування вузлів. Обидва надаватимуть нові вузли для Podʼів, які неможливо запланувати, і обидва консолідуватимуть вузли, які більше не використовуються оптимально.
Різні автомасштабувальники можуть також надавати можливості, що виходять за межі описаного на цій сторінці автомасштабування вузлів, і ці додаткові можливості можуть у них відрізнятися.
Ознайомтеся з розділами нижче та документацією окремих автомасштабувальників за посиланнями, щоб вирішити, який із них краще підходить для вашого сценарію.
Cluster Autoscaler
Cluster Autoscaler додає вузли до попередньо налаштованих груп вузлів або видаляє їх звідти. Групи вузлів зазвичай відповідають певній групі ресурсів хмарного провайдера (найчастіше групі віртуальних машин). Один екземпляр Cluster Autoscaler може одночасно керувати кількома групами вузлів. Під час надання Cluster Autoscaler додає вузли до тієї групи, яка найкраще відповідає запитам Podʼів в очікуванні. Під час консолідації Cluster Autoscaler завжди вибирає конкретні вузли для видалення, а не просто змінює розмір базової групи ресурсів хмарного провайдера.
Karpenter автоматично надає вузли на основі конфігурацій NodePool, заданих оператором кластера. Karpenter керує всіма аспектами життєвого циклу вузла, а не лише автомасштабуванням. Це, зокрема, автоматична заміна вузлів, коли вони досягають певного віку, та автоматичне оновлення вузлів, коли випускаються нові образи робочих вузлів. Він працює безпосередньо з окремими ресурсами хмарного провайдера (найчастіше окремими віртуальними машинами) і не покладається на групи ресурсів хмарного провайдера.
Основні відмінності між Cluster Autoscaler та Karpenter:
Cluster Autoscaler надає можливості, повʼязані лише з автомасштабуванням вузлів. Karpenter має ширшу сферу застосування й надає також можливості для керування всім життєвим циклом вузлів (наприклад, використання порушень для автоматичного перестворення вузлів, коли вони досягають певного віку, або їх автоматичного оновлення до нових версій).
Cluster Autoscaler не підтримує автоматичне надання: групи вузлів, з яких він може надавати вузли, мають бути попередньо налаштовані. Karpenter підтримує автоматичне надання, тому користувачеві потрібно лише налаштувати набір обмежень для наданих вузлів, а не повністю налаштовувати однорідні групи.
Cluster Autoscaler надає інтеграції з хмарними провайдерами безпосередньо, тобто вони є частиною проєкту Kubernetes. Для Karpenter проєкт Kubernetes публікує Karpenter як бібліотеку, з якою хмарні провайдери можуть інтегруватися для створення автомасштабувальника вузлів.
Cluster Autoscaler надає інтеграції з багатьма хмарними провайдерами, зокрема з невеликими й менш популярними. З Karpenter інтегрується менше хмарних провайдерів, зокрема AWS та Azure.
Поєднання автомасштабування робочих навантажень і вузлів
Горизонтальне автомасштабування робочих навантажень
Автомасштабування вузлів зазвичай працює у відповідь на Podʼи — воно надає нові вузли для розміщення Podʼів, які неможливо запланувати, а потім консолідує вузли, коли вони більше не потрібні.
Горизонтальне автомасштабування робочих навантажень автоматично масштабує кількість реплік робочого навантаження, щоб підтримувати бажане середнє використання ресурсів у репліках. Іншими словами, воно автоматично створює нові Podʼи у відповідь на навантаження застосунку, а потім видаляє їх, коли навантаження зменшується.
Ви можете використовувати автомасштабування вузлів разом із горизонтальним автомасштабуванням робочих навантажень, щоб автомасштабувати вузли у вашому кластері на основі середнього реального використання ресурсів ваших Podʼів.
Якщо навантаження застосунку зростає, середнє використання його Podʼів також має зростати, що спонукає автомасштабування робочого навантаження створити нові Podʼи. Автомасштабування вузлів має надати нові вузли для розміщення нових Podʼів.
Коли навантаження застосунку зменшується, автомасштабування робочого навантаження має видалити непотрібні Podʼи. Автомасштабування вузлів, у свою чергу, має консолідувати вузли, які більше не потрібні.
За правильного налаштування цей шаблон гарантує, що ваш застосунок завжди матиме місткість вузлів для обробки сплесків навантаження, коли це потрібно, але вам не доведеться платити за місткість, коли вона не потрібна.
Вертикальне автомасштабування робочих навантажень
Під час використання автомасштабування вузлів важливо правильно встановлювати запити ресурсів Podʼів. Якщо запити певного Podʼа занадто низькі, надання для нього нового вузла може не допомогти йому реально запуститися. Якщо запити певного Podʼа занадто високі, це може помилково перешкоджати консолідації його вузла.
Ви можете використовувати автомасштабування вузлів разом із вертикальним автомасштабуванням робочих навантажень, щоб коригувати запити ресурсів ваших Podʼів, зберігаючи можливості автомасштабування вузлів у кластері.
Увага:
Під час використання автомасштабування вузлів не рекомендується налаштовувати вертикальне автомасштабування робочих навантажень для Podʼів DaemonSet. Автомасштабувальники мають передбачати, якими будуть Podʼи DaemonSet на новому вузлі, щоб прогнозувати доступні ресурси вузла. Вертикальне автомасштабування робочих навантажень може зробити ці прогнози ненадійними, що призведе до неправильних рішень щодо масштабування.
Супутні компоненти
У цьому розділі описано компоненти, що надають можливості, повʼязані з автомасштабуванням вузлів.
Descheduler
Descheduler — це компонент, що надає консолідацію вузлів на основі власних політик, а також інші можливості, повʼязані з оптимізацією вузлів і Podʼів (наприклад, видалення Podʼів, що часто перезапускаються).
Автомасштабувальники робочих навантажень на основі розміру кластера
Щоб дізнатися, як генерувати сертифікати для свого кластера, дивіться Сертифікати.
5 - Мережа в кластері
Мережа — центральна частина Kubernetes, але буває складно зрозуміти, як саме вона має працювати. Потрібно розвʼязати 4 окремі мережеві проблеми:
Взаємодія тісно повʼязаних контейнерів: цю проблему розвʼязують Podʼи та взаємодія через localhost.
Взаємодія між Podʼами: це основна тема цього документа.
Взаємодія Podʼів із Service: це описано на сторінці Services.
Взаємодія із Service ззовні: це також описано на сторінці Services.
Kubernetes — це система розподілу машин між застосунками. Зазвичай для розподілу машин потрібно переконатися, що два застосунки не намагаються використовувати одні й ті самі порти. Координувати порти між багатьма розробниками у великому масштабі дуже складно, і це наражає користувачів на проблеми на рівні кластера, які вони не можуть контролювати.
Динамічне призначення портів дуже ускладнює систему — кожен застосунок має приймати порти як прапорці, API-сервери мають уміти вставляти динамічні номери портів у блоки конфігурації, сервіси мають знати, як знаходити один одного, тощо. Щоб не мати з цим справи, Kubernetes обирає інший підхід.
Кластери Kubernetes потребують виділення IP-адрес, які не перекриваються, для Podʼів, Services та вузлів з діапазону доступних адрес, налаштованого в таких компонентах:
Мережевий втулок налаштований на призначення IP-адрес Podʼам.
kube-apiserver налаштований на призначення IP-адрес Services.
kubelet або cloud-controller-manager налаштовані на призначення IP-адрес вузлам.
Типи мереж у кластері
Залежно від налаштованих сімейств IP, кластери Kubernetes можна поділити на такі категорії:
Лише IPv4: мережевий втулок, kube-apiserver та kubelet/cloud-controller-manager налаштовані на призначення лише IPv4-адрес.
Лише IPv6: мережевий втулок, kube-apiserver та kubelet/cloud-controller-manager налаштовані на призначення лише IPv6-адрес.
Мережевий втулок налаштований на призначення адрес IPv4 та IPv6.
kube-apiserver налаштований на призначення адрес IPv4 та IPv6.
kubelet або cloud-controller-manager налаштовані на призначення адрес IPv4 та IPv6.
Усі компоненти мають бути узгоджені щодо налаштованого основного сімейства IP.
Кластери Kubernetes враховують лише сімейства IP, присутні в обʼєктах Pod, Service та Node, незалежно від наявних IP-адрес представлених обʼєктів. Наприклад, сервер або Pod може мати кілька IP-адрес, призначених його інтерфейсам, але під час реалізації мережевої моделі Kubernetes і визначення типу кластера враховуються лише IP-адреси в node.status.addresses або pod.status.ips.
Як реалізувати мережеву модель Kubernetes
Мережеву модель реалізує середовище виконання контейнерів на кожному вузлі. Найпоширеніші середовища виконання контейнерів використовують втулки Container Network Interface (CNI) для керування своїми мережевими можливостями та можливостями безпеки. Існує багато різних CNI-втулків від різних постачальників. Деякі з них надають лише базові можливості додавання та видалення мережевих інтерфейсів, тоді як інші пропонують складніші рішення, такі як інтеграція з іншими системами оркестрування контейнерів, запуск кількох CNI-втулків, розширені можливості IPAM тощо.
Неповний перелік мережевих надбудов, які підтримує Kubernetes, дивіться на цій сторінці.
Що далі
Ранній дизайн мережевої моделі та її обґрунтування докладніше описані в документі дизайну мережі. Про майбутні плани та поточну роботу над поліпшенням мережевих можливостей Kubernetes дивіться в KEPs SIG-Network.
6 - Спостережуваність
Дізнайтеся, як отримати наскрізну видимість кластера Kubernetes завдяки збору метрик, логів і трейсів.
У Kubernetes спостережуваність — це процес збору та аналізу метрик, логів і трейсів (їх часто називають трьома стовпами спостережуваності), щоб краще зрозуміти внутрішній стан, продуктивність і справність кластера.
Компоненти панелі управління Kubernetes, а також багато надбудов генерують і надсилають ці сигнали. Обʼєднуючи та корелюючи їх, ви можете отримати єдину картину панелі управління, надбудов і застосунків у всьому кластері.
На схемі 1 показано, як компоненти кластера надсилають три основні типи сигналів.
flowchart LR
    A[Компоненти
кластера] --> M[Конвеєр метрик]
    A --> L[Конвеєр логів]
    A --> T[Конвеєр трейсів]
    M --> S[(Зберігання та
аналіз)]
    L --> S
    T --> S
    S --> O[Оператори та
автоматизація]
Схема 1. Високорівневі сигнали, які надсилають компоненти кластера, та їх споживачі.
Метрики
Компоненти Kubernetes надають метрики у форматі Prometheus через свої точки доступу /metrics, зокрема:
kube-controller-manager
kube-proxy
kube-apiserver
kube-scheduler
kubelet
kubelet також надає метрики через /metrics/cadvisor, /metrics/resource та /metrics/probes, а надбудови, такі як kube-state-metrics, доповнюють ці сигнали панелі управління статусом обʼєктів Kubernetes.
Типовий конвеєр метрик Kubernetes періодично опитує ці точки доступу та зберігає отримані зразки в базі даних часових рядів (наприклад, у Prometheus).
API метрик Kubernetes надає дані про використання CPU та памʼяті вузлами та Podʼами. Команда kubectl top та такі компоненти, як HorizontalPodAutoscaler і VerticalPodAutoscaler, використовують цей API.
kubectl top підтримує як metrics.k8s.io/v1, так і metrics.k8s.io/v1beta1. Він надає перевагу v1, коли ця версія доступна, і повертається до v1beta1. У Kubernetes v1.37 контролер HorizontalPodAutoscaler підтримує лише metrics.k8s.io/v1beta1; підтримка metrics.k8s.io/v1 запланована, але ще недоступна.
На відміну від точок доступу метрик компонентів, описаних раніше, API метрик обслуговується через шар агрегації API Kubernetes. У вашому кластері має працювати Metrics Server або інша реалізація цього API. API метрик навмисно надає лише метрики ресурсів, потрібні для автомасштабування та базової перевірки; він не замінює повноцінний конвеєр моніторингу.
Щоб дізнатися про API, його реалізації та потік даних від kubelet до його клієнтів, дивіться конвеєр метрик ресурсів.
Логи містять хронологічні записи подій усередині застосунків, системних компонентів Kubernetes та дій, повʼязаних із безпекою, таких як логування аудиту.
Середовища виконання контейнерів отримують вивід контейнеризованого застосунку з потоків стандартного виводу (stdout) та стандартного виводу помилок (stderr). Хоча середовища виконання реалізують це по-різному, інтеграцію з kubelet стандартизовано через формат логування CRI, а kubelet робить ці логи доступними через kubectl logs.
Схема 3a. Архітектура логування на рівні вузла.
Логи системних компонентів фіксують події в кластері й часто корисні для налагодження та усунення несправностей. Ці компоненти поділяються на два види: ті, що працюють у контейнері, і ті, що працюють поза ним. Наприклад, kube-scheduler і kube-proxy зазвичай працюють у контейнерах, тоді як kubelet і середовище виконання контейнерів працюють безпосередньо на хості.
На машинах із systemd kubelet і середовище виконання контейнерів пишуть у journald. В іншому разі вони пишуть у файли .log у теці /var/log.
Системні компоненти, що працюють у контейнерах, завжди пишуть у файли .log у /var/log, оминаючи стандартний механізм логування контейнерів.
Логи системних компонентів і контейнерів, що зберігаються в /var/log, потребують ротації, щоб запобігти неконтрольованому зростанню. Деякі сценарії розгортання кластерів стандартно встановлюють ротацію логів; перевірте своє середовище та за потреби змініть налаштування. Докладніше про розташування, формати та параметри конфігурації дивіться в довідці щодо системних логів.
Більшість кластерів запускають агент логування на рівні вузла (наприклад, Fluent Bit або Fluentd), який стежить за цими файлами та пересилає записи до центрального сховища логів. У посібнику з архітектури логування пояснюється, як проєктувати такі конвеєри, налаштовувати термін зберігання та спрямовувати потоки логів до бекендів.
На схемі 3 показано типовий конвеєр агрегації логів.
flowchart LR
    subgraph Джерела
        A[Вивід застосунку
в stdout / stderr]
        B[Логи
панелі
управління]
        C[Записи аудиту]
    end
    A --> N[Агент логування
на рівні вузла]
    B --> N
    C --> N
    N --> L[Центральне
сховище
логів]
    L --> Q[Dashboards,
сповіщення,
SIEM]
Трейси фіксують, як запити проходять через компоненти та застосунки Kubernetes, повʼязуючи затримки, час і взаємозвʼязки між операціями. Збираючи трейси, ви можете візуалізувати проходження запиту від початку до кінця, діагностувати проблеми з продуктивністю та виявляти вузькі місця або несподівані взаємодії в панелі управління, надбудовах чи застосунках.
Kubernetes 1.37 може експортувати відрізки (spans) через OpenTelemetry Protocol (OTLP) — або безпосередньо через вбудовані експортери gRPC, або пересилаючи їх через OpenTelemetry Collector.
OpenTelemetry Collector отримує відрізки від компонентів і застосунків, обробляє їх (наприклад, застосовуючи відбір або редагування) і пересилає до бекенду трасування для зберігання та аналізу.
На схемі 4 показано типовий конвеєр розподіленого трасування.
flowchart LR
    subgraph Джерела
        A[Відрізки
панелі управління]
        B[Відрізки
застосунків]
    end
    A --> X[OTLP exporter]
    B --> X
    X --> COL[OpenTelemetry
Collector]
    COL --> TS[(Бекенд
трасування)]
    TS --> V[Візуалізація
та аналіз]
Примітка: Цей розділ містить посилання на проєкти сторонніх розробників, які надають функціонал, необхідний для Kubernetes. Автори проєкту Kubernetes не несуть відповідальності за ці проєкти. Проєкти вказано в алфавітному порядку. Щоб додати проєкт до цього списку, ознайомтеся з посібником з контенту перед надсиланням змін. Докладніше.
Примітка: цей розділ містить посилання на сторонні проєкти, які надають можливості спостережуваності, потрібні для Kubernetes. Автори проєкту Kubernetes не несуть відповідальності за ці проєкти, які перелічені в алфавітному порядку. Щоб додати проєкт до цього списку, перед внесенням змін прочитайте посібник зі вмісту.
Інструменти метрик
Cortex пропонує горизонтально масштабоване, довгострокове сховище Prometheus.
Grafana Mimir — проєкт Grafana Labs, який надає багатоорендне, горизонтально масштабоване сховище, сумісне з Prometheus.
Prometheus — це система моніторингу, яка збирає та зберігає метрики з компонентів Kubernetes.
Thanos розширює Prometheus глобальними запитами, проріджуванням даних (downsampling) та підтримкою обʼєктного сховища.
Інструменти логування
Elasticsearch забезпечує розподілене індексування логів та пошук у них.
Fluent Bit збирає та пересилає логи контейнерів і вузлів із низьким споживанням ресурсів.
Fluentd маршрутизує та перетворює логи, надсилаючи їх до кількох місць призначення.
Grafana Loki зберігає логи у форматі на основі міток, натхненному Prometheus.
OpenSearch надає індексування логів і пошук із відкритим кодом, сумісні з API Elasticsearch.
Інструменти трасування
Grafana Tempo пропонує масштабоване та недороге сховище розподілених трейсів.
Jaeger збирає та візуалізує розподілені трейси для мікросервісів.
Логи застосунків можуть допомогти вам зрозуміти, що відбувається всередині застосунку. Логи особливо корисні для налагодження проблем і моніторингу активності кластера. Більшість сучасних застосунків мають певний механізм логування. Так само рушії контейнерів розроблені з підтримкою логування. Найпростіший і найпоширеніший метод логування для контейнеризованих застосунків — запис у стандартні потоки виводу та помилок.
Однак вбудованих можливостей рушія контейнерів або середовища виконання зазвичай недостатньо для повноцінного рішення для логування.
Наприклад, вам може знадобитися доступ до логів застосунку, якщо контейнер зазнає збою, Pod буде виселено або вузол вийде з ладу.
У кластері логи повинні мати окреме сховище та життєвий цикл, незалежний від вузлів, Podʼів чи контейнерів. Ця концепція називається логуванням на рівні кластера.
Архітектури логування на рівні кластера потребують окремого бекенду для зберігання, аналізу та запитів до логів. Kubernetes не надає власного рішення для зберігання логів. Натомість існує багато рішень для логування, які інтегруються з Kubernetes. У наведених нижче розділах описано, як обробляти та зберігати логи на вузлах.
Логи Podʼів та контейнерів
Kubernetes збирає логи з кожного контейнера в запущеному Podʼі.
У цьому прикладі використовується маніфест Pod з контейнером, який раз на секунду записує текст у стандартний потік виводу.
Для отримання логів використовуйте команду kubectl logs, як показано нижче:
kubectl logs counter
Вивід буде схожим на:
0: Fri Apr  1 11:42:23 UTC 2022
1: Fri Apr  1 11:42:24 UTC 2022
2: Fri Apr  1 11:42:25 UTC 2022
Ви можете використовувати kubectl logs --previous для отримання логів з попереднього запуску контейнера. Якщо ваш Pod має кілька контейнерів, вкажіть, логи якого контейнера ви хочете переглянути, додавши назву контейнера до команди з прапорцем -c, ось так:
kubectl logs counter -c count
Потоки логів контейнерів
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.32; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the PodLogsQuerySplitStreams feature gate for all relevant components in your cluster.
Як альфа-можливість, kubelet може розділяти логи двох стандартних потоків, які створює контейнер: стандартного виводу та стандартного потоку помилок. Щоб скористатися цією поведінкою, потрібно ввімкнути функціональну можливість PodLogsQuerySplitStreams. З увімкненою функціональною можливістю Kubernetes 1.37 надає доступ до цих потоків логів безпосередньо через Pod API. Ви можете отримати конкретний потік, вказавши його назву (Stdout або Stderr) за допомогою рядка запиту stream. Ви повинні мати доступ на читання субресурсу log цього Podʼа.
Щоб продемонструвати цю можливість, ви можете створити Pod, який періодично записуватиме текст як до стандартного потоку виводу, так і до потоку помилок.
Середовище виконання контейнерів обробляє та перенаправляє весь вивід у потоки stdout та stderr контейнеризованого застосунку. Різні середовища виконання контейнерів реалізують це по-різному; однак інтеграцію з kubelet стандартизовано як формат логування CRI.
Стандартно, якщо контейнер перезапускається, kubelet зберігає один завершений контейнер з його логами. Якщо Pod виселяється з вузла, усі відповідні контейнери також виселяються разом зі своїми логами.
kubelet надає клієнтам доступ до логів через спеціальну можливість API Kubernetes. Зазвичай доступ до неї здійснюється за допомогою команди kubectl logs.
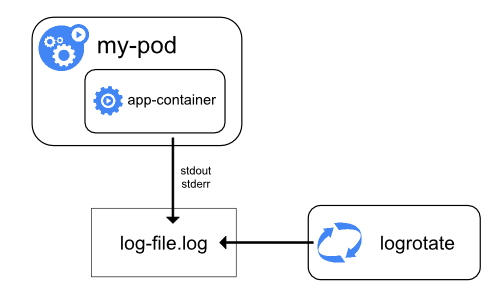
Ротація логів
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.21
kubelet відповідає за ротацію логів контейнерів і керування структурою тек логів. kubelet передає цю інформацію середовищу виконання контейнерів (через CRI), а середовище виконання записує логи контейнерів у вказане місце.
Ви можете налаштувати два параметри конфігурації kubelet, containerLogMaxSize (стандартно 10Mi) та containerLogMaxFiles (стандартно 5), за допомогою файлу конфігурації kubelet. Ці параметри дозволяють налаштувати максимальний розмір кожного файлу логу та максимальну кількість файлів для кожного контейнера відповідно.
Для ефективної ротації логів у кластерах, де робочі навантаження генерують великий обсяг логів, kubelet також надає механізм налаштування ротації: кількості одночасних ротацій логів та інтервалу, з яким логи відстежуються й за потреби ротуються. Ви можете налаштувати два параметри конфігурації kubelet, containerLogMaxWorkers та containerLogMonitorInterval, за допомогою файлу конфігурації kubelet.
Коли ви виконуєте kubectl logs, як у прикладі базового логування, kubelet на вузлі обробляє запит і читає безпосередньо з файлу логу. kubelet повертає вміст файлу логу.
Примітка:
Через kubectl logs доступний лише вміст останнього файлу логу.
Наприклад, якщо Pod пише 40 MiB логів і kubelet ротує логи після 10 MiB, виконання kubectl logs поверне максимум 10MiB даних.
Логи системних компонентів
Є два види системних компонентів: ті, що зазвичай працюють у контейнері, і ті, що безпосередньо беруть участь у запуску контейнерів. Наприклад:
kubelet і середовище виконання контейнерів не працюють у контейнерах. kubelet запускає ваші контейнери (згруповані в Podʼи).
Планувальник Kubernetes, менеджер контролерів та API-сервер працюють у Podʼах (зазвичай статичних Podʼах). Компонент etcd працює в панелі управління, найчастіше також як статичний Pod. Якщо ваш кластер використовує kube-proxy, зазвичай його запускають як DaemonSet.
Розташування логів
Те, як kubelet і середовище виконання контейнерів записують логи, залежить від операційної системи вузла:
На вузлах Linux, які використовують systemd, kubelet і середовище виконання контейнерів стандартно пишуть у journald. Для читання журналу systemd використовуйте journalctl; наприклад: journalctl -u kubelet.
Якщо systemd немає, kubelet і середовище виконання контейнерів пишуть у файли .log у теці /var/log. Якщо ви хочете, щоб логи записувалися в інше місце, можна запускати kubelet опосередковано через допоміжний інструмент kube-log-runner і за допомогою нього перенаправляти логи kubelet у вибрану вами теку.
Стандартно kubelet вказує середовищу виконання контейнерів записувати логи в теки всередині /var/log/pods.
Стандартно kubelet записує логи у файли всередині теки C:\var\logs (зверніть увагу, що це не C:\var\log).
Хоча C:\var\log є стандартним розташуванням цих логів у Kubernetes, деякі інструменти розгортання кластера налаштовують вузли Windows так, щоб логи записувалися в C:\var\log\kubelet.
Якщо ви хочете, щоб логи записувалися в інше місце, можна запускати kubelet опосередковано через допоміжний інструмент kube-log-runner і за допомогою нього перенаправляти логи kubelet у вибрану вами теку.
Однак стандартно kubelet вказує середовищу виконання контейнерів записувати логи в теку C:\var\log\pods.
Компоненти кластера Kubernetes, які працюють у Podʼах, пишуть у файли всередині теки /var/log, оминаючи стандартний механізм логування (ці компоненти не пишуть у журнал systemd). Ви можете використовувати механізми сховища Kubernetes, щоб підключити постійне сховище до контейнера, у якому працює компонент.
kubelet дозволяє змінити теку логів Podʼів зі стандартної /var/log/pods на власний шлях. Це можна зробити за допомогою параметра podLogsDir у файлі конфігурації kubelet.
Увага:
Важливо зазначити, що стандартне розташування /var/log/pods використовувалося протягом тривалого часу, і певні процеси можуть неявно використовувати цей шлях. Тому до зміни цього параметра слід підходити з обережністю і на власний ризик.
Ще одне застереження: kubelet підтримує розташування на тому самому диску, що й /var. В іншому разі, якщо логи розташовані в окремій від /var файловій системі, kubelet не відстежуватиме використання цієї файлової системи, що може призвести до проблем, якщо вона заповниться.
Докладніше про etcd та його логи дивіться в документації etcd. Знову ж таки, ви можете використовувати механізми сховища Kubernetes, щоб підключити постійне сховище до контейнера, у якому працює компонент.
Примітка:
Якщо ви розгортаєте компоненти кластера Kubernetes (наприклад, планувальник) так, щоб вони писали логи в том, спільний із батьківським вузлом, вам потрібно подбати про ротацію цих логів. Kubernetes не керує цією ротацією логів.
Ваша операційна система може автоматично виконувати певну ротацію логів — наприклад, якщо ви надаєте статичному Podʼу компонента спільний доступ до теки /var/log, ротація логів на рівні вузла обробляє файл у цій теці так само, як файл, записаний будь-яким компонентом поза Kubernetes.
Деякі інструменти розгортання враховують цю ротацію логів та автоматизують її; інші залишають це на вашу відповідальність.
Архітектури логування на рівні кластера
Хоча Kubernetes не надає власного рішення для логування на рівні кластера, існує кілька поширених підходів, які ви можете розглянути. Ось деякі варіанти:
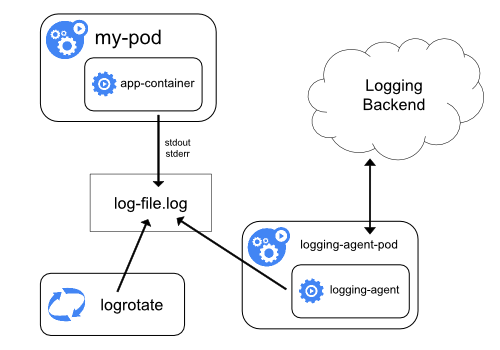
Використання агента логування на рівні вузла, який працює на кожному вузлі.
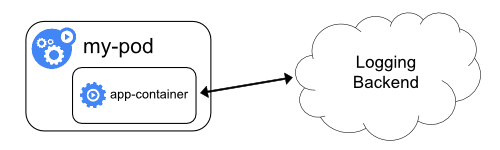
Додавання в Pod застосунку спеціального sidecar-контейнера для логування.
Надсилання логів безпосередньо до бекенду із застосунку.
Використання агента логування на рівні вузла
Ви можете реалізувати логування на рівні кластера, розмістивши на кожному вузлі агент логування на рівні вузла. Агент логування — це спеціальний інструмент, який відкриває доступ до логів або надсилає їх до бекенду. Зазвичай агент логування — це контейнер, який має доступ до теки з файлами логів усіх контейнерів застосунків на цьому вузлі.
Оскільки агент логування повинен працювати на кожному вузлі, рекомендується запускати агента
як DaemonSet.
Логування на рівні вузла створює лише одного агента на вузол і не вимагає жодних змін у застосунках, що працюють на вузлі.
Контейнери пишуть у stdout та stderr, але без узгодженого формату. Агент на рівні вузла збирає
ці логи та пересилає їх для агрегації.
Використання sidecar-контейнера з агентом логування
Ви можете використовувати sidecar-контейнер одним із таких способів:
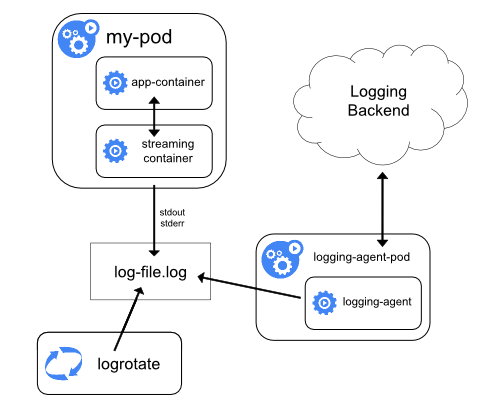
Sidecar-контейнер транслює логи застосунку у свій власний stdout.
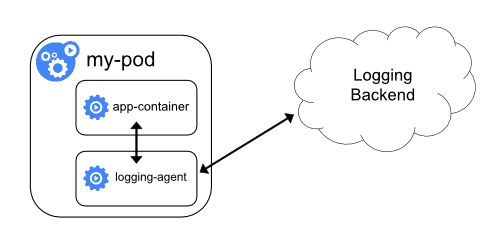
У sidecar-контейнері працює агент логування, налаштований збирати логи з контейнера застосунку.
Sidecar-контейнер для трансляції
Якщо ваші sidecar-контейнери пишуть у власні потоки stdout та stderr, ви можете скористатися kubelet та агентом логування, які вже працюють на кожному вузлі. Sidecar-контейнери читають логи з файлу, сокета або journald. Кожен sidecar-контейнер виводить лог у свій власний потік stdout або stderr.
Цей підхід дозволяє розділити кілька потоків логів із різних частин вашого застосунку, деякі з яких можуть не підтримувати запис у stdout або stderr. Логіка перенаправлення логів мінімальна, тому це не створює значних накладних витрат. Крім того, оскільки stdout та stderr обробляє kubelet, ви можете використовувати вбудовані інструменти, такі як kubectl logs.
Наприклад, у Podʼі працює один контейнер, який записує до двох різних файлів логів у двох різних форматах. Ось маніфест для Podʼа:
apiVersion:v1kind:Podmetadata:name:counterspec:containers:- name:countimage:busybox:1.28args:- /bin/sh- -c- > i=0;
while true;
do
echo "$i: $(date)" >> /var/log/1.log;
echo "$(date) INFO $i" >> /var/log/2.log;
i=$((i+1));
sleep 1;
donevolumeMounts:- name:varlogmountPath:/var/logvolumes:- name:varlogemptyDir:{}
Не рекомендується записувати записи логів різних форматів в один потік логів, навіть якщо вам вдалося перенаправити обидва компоненти до потоку stdout контейнера. Натомість можна створити два sidecar-контейнери. Кожен sidecar-контейнер може читати кінець певного файлу логів зі спільного тому й перенаправляти логи до власного потоку stdout.
Ось маніфест для Podʼа, в якому є два sidecar-контейнери:
Тепер, коли ви запускаєте цей Pod, ви можете отримати доступ до кожного потоку логів окремо, запустивши такі команди:
kubectl logs counter count-log-1
Результат буде подібним до:
0: Fri Apr  1 11:42:26 UTC 2022
1: Fri Apr  1 11:42:27 UTC 2022
2: Fri Apr  1 11:42:28 UTC 2022
...
kubectl logs counter count-log-2
Результат буде подібним до:
Fri Apr  1 11:42:29 UTC 2022 INFO 0
Fri Apr  1 11:42:30 UTC 2022 INFO 0
Fri Apr  1 11:42:31 UTC 2022 INFO 0
...
Якщо ви встановили у свій кластер агент на рівні вузла, цей агент автоматично збиратиме ці потоки логів без додаткової конфігурації. За бажанням ви можете налаштувати агент на розбір рядків логів залежно від контейнера-джерела.
Навіть для Podʼів із низьким використанням CPU та памʼяті (порядку кількох мілікорів CPU та кількох мегабайтів памʼяті) запис логів у файл і їх подальша трансляція до stdout можуть подвоїти обсяг сховища, потрібний на вузлі. Якщо у вас є застосунок, який пише в один файл, рекомендується встановити /dev/stdout як місце призначення, а не застосовувати підхід із sidecar-контейнером для трансляції.
Sidecar-контейнери також можна використовувати для ротації файлів логів, які не може ротувати сам застосунок. Прикладом такого підходу є невеликий контейнер, який періодично запускає logrotate. Однак простіше використовувати stdout та stderr безпосередньо й залишити ротацію та політики зберігання kubelet.
Sidecar-контейнер з агентом логування
Якщо агент логування на рівні вузла недостатньо гнучкий для вашої ситуації, ви можете створити sidecar-контейнер з окремим агентом логування, налаштованим спеціально для роботи з вашим застосунком.
Примітка:
Використання агента логування в sidecar-контейнері може призвести до значного споживання ресурсів. Крім того, ви не зможете отримати доступ до цих логів за допомогою kubectl logs, оскільки вони не контролюються kubelet.
Ось два приклади маніфестів, які ви можете використати для реалізації sidecar-контейнера з агентом логування. Перший маніфест містить ConfigMap для налаштування fluentd.
apiVersion:v1kind:ConfigMapmetadata:name:fluentd-configdata:fluentd.conf:| <source>
type tail
format none
path /var/log/1.log
pos_file /var/log/1.log.pos
tag count.format1
</source>
<source>
type tail
format none
path /var/log/2.log
pos_file /var/log/2.log.pos
tag count.format2
</source>
<match **>
type google_cloud
</match>
Примітка:
У конфігураціях з прикладів ви можете замінити fluentd на будь-який агент логування, який читає з будь-якого джерела всередині контейнера застосунку.
Другий маніфест описує Pod із sidecar-контейнером, у якому працює fluentd. Pod монтує том, звідки fluentd може отримати свої конфігураційні дані.
8 - Рекомендації щодо динамічного розподілу ресурсів для адміністраторів кластера
На цій сторінці описано рекомендації щодо налаштування кластера Kubernetes із використанням динамічного розподілу ресурсів (DRA). Ці інструкції призначені для адміністраторів кластерів.
Окремі дозволи для API, повʼязаних з DRA
DRA оркеструється через низку різних API. Використовуйте інструменти авторизації (такі як RBAC або інше рішення), щоб контролювати доступ до потрібних API залежно від ролі вашого користувача.
Загалом доступ до DeviceClasses і ResourceSlices слід надавати лише адміністраторам і драйверам DRA. Операторам кластерів, які розгортатимуть Podʼи із заявками, потрібен доступ до API ResourceClaim і ResourceClaimTemplate; обидва ці API обмежені простором імен.
Розгортання та обслуговування драйверів DRA
Драйвери DRA — це сторонні застосунки, які працюють на кожному вузлі кластера й взаємодіють з апаратним забезпеченням цього вузла та вбудованими компонентами DRA Kubernetes. Процедура встановлення залежить від обраного драйвера, але, ймовірно, він розгортається як DaemonSet на всіх або на вибраних вузлах кластера (за допомогою селекторів вузлів або подібних механізмів).
Використовуйте драйвери з безперебійним оновленням, якщо це можливо
Драйвери DRA реалізують інтерфейс пакунка kubeletplugin. Ваш драйвер може підтримувати безперебійні оновлення завдяки реалізації властивості цього інтерфейсу, яка дозволяє двом версіям одного драйвера DRA співіснувати протягом короткого часу. Це доступно лише для kubelet версії 1.33 і новіших, і ваш драйвер може не підтримувати це для гетерогенних кластерів з підʼєднаними вузлами, на яких працюють старіші версії Kubernetes, — перевірте це в документації вашого драйвера.
Якщо безперебійні оновлення доступні у вашій ситуації, розгляньте можливість їх використання, щоб мінімізувати затримки планування під час оновлення драйвера.
Якщо ви не можете використовувати безперебійні оновлення, під час простою драйвера на час оновлення ви можете помітити, що:
Podʼи не можуть запускатися, якщо заявки, від яких вони залежать, ще не були підготовлені до використання.
Очищення після останнього Podʼа, який використовував заявку, відкладається, доки драйвер знову не стане доступним. Pod не позначається як завершений. Це не дає повторно використовувати ресурси цього Podʼа для інших Podʼів.
Запущені Podʼи продовжують працювати.
Переконайтеся, що драйвер DRA надає пробу життєздатності, і використовуйте її
Ваш драйвер DRA, ймовірно, реалізує gRPC-сокет для перевірок справності відповідно до рекомендацій щодо драйверів DRA. Найпростіший спосіб використати цей gRPC-сокет — налаштувати його як пробу життєздатності для DaemonSet, що розгортає ваш драйвер DRA. Документація вашого драйвера або інструменти розгортання вже можуть це містити, але якщо ви створюєте конфігурацію окремо або запускаєте драйвер DRA не як Pod Kubernetes, переконайтеся, що ваші інструменти оркестрування перезапускають драйвер DRA в разі невдалих перевірок справності цього gRPC-сокета. Це мінімізує випадкові простої драйвера DRA і дасть йому більше можливостей для самовідновлення, зменшуючи затримки планування або час на усунення несправностей.
Під час drain вузла виконуйте drain драйвера DRA якомога пізніше
Драйвер DRA відповідає за скасування підготовки всіх пристроїв, виділених Podʼам, і якщо для драйвера DRA буде виконано drain до видалення Podʼів із заявками, він не зможе завершити очищення. Якщо ви реалізуєте власну логіку drain для вузлів, перед завершенням самого драйвера DRA перевірте, що немає виділених або зарезервованих ResourceClaim чи ResourceClaimTemplates.
Відстежуйте та налаштовуйте компоненти для вищого навантаження, особливо у великомасштабних середовищах
Компонент панелі управління kube-scheduler та внутрішній контролер ResourceClaim, яким керує компонент kube-controller-manager, виконують основну роботу під час планування Podʼів із заявками на основі метаданих, що зберігаються в API DRA. Порівняно з Podʼами, запланованими без DRA, для Podʼів із заявками DRA зростають кількість викликів API-сервера, а також використання памʼяті й CPU цими компонентами. Крім того, локальні компоненти вузла, такі як драйвер DRA та kubelet, використовують API DRA для виділення апаратних запитів під час створення пісочниці Podʼа. Особливо у великомасштабних середовищах, де кластери мають багато вузлів та/або розгортають багато робочих навантажень, які інтенсивно використовують заявки на ресурси, визначені DRA, адміністратор кластера має налаштувати відповідні компоненти з урахуванням збільшеного навантаження.
Неправильне налаштування компонентів може мати прямі або лавиноподібні наслідки, що спричиняють різні симптоми протягом життєвого циклу Podʼа. Якщо параметри QPS та burst компонента kube-scheduler занадто низькі, планувальник може швидко визначити придатний вузол для Podʼа, але витратити більше часу на привʼязку Podʼа до цього вузла. З DRA під час планування Podʼа критично важливі параметри QPS та Burst у конфігурації client-go в kube-controller-manager.
Конкретні значення для налаштування вашого кластера залежать від різних чинників, таких як кількість вузлів/Podʼів, швидкість створення Podʼів, плинність, навіть у середовищах без DRA; докладніше дивіться в README SIG Scalability про пороги масштабованості Kubernetes. У тестах масштабування на кластері з увімкненим DRA зі 100 вузлами, 720 довгоживучими Podʼами (90% насичення) та 80 плинними Podʼами (10% плинності, 10 разів) зі швидкістю створення Jobs 10 QPS значення QPS для kube-controller-manager можна було встановити лише 75, а Burst — 150, щоб досягти таких самих цільових метрик, як для розгортань без DRA. На цій нижній межі спостерігалося, що обмежувач швидкості на стороні клієнта спрацьовував достатньо, щоб захистити API-сервер від вибухового сплеску, але межа була достатньо високою, щоб не вплинути на SLO запуску Podʼів. Хоча це гарна відправна точка, краще зрозуміти, як налаштувати різні компоненти, що найбільше впливають на продуктивність DRA у вашому розгортанні, можна, відстежуючи наведені нижче метрики. Докладніше про всі стабільні метрики Kubernetes дивіться в Довіднику метрик Kubernetes.
Метрики kube-controller-manager
Наведені нижче метрики докладно показують роботу внутрішнього контролера ResourceClaim, яким керує компонент kube-controller-manager.
Швидкість додавання до робочої черги: відстежуйте sum(rate(workqueue_adds_total{name="resource_claim"}[5m])), щоб оцінити, як швидко елементи додаються до контролера ResourceClaim.
Глибина робочої черги: відстежуйте sum(workqueue_depth{endpoint="kube-controller-manager",name="resource_claim"}), щоб виявити будь-які нагромадження в контролері ResourceClaim.
Тривалість обробки в робочій черзі: відстежуйте histogram_quantile(0.99,sum(rate(workqueue_work_duration_seconds_bucket{name="resource_claim"}[5m]))by(le)), щоб зрозуміти швидкість, з якою контролер ResourceClaim обробляє роботу.
Якщо ви спостерігаєте низьку швидкість додавання до робочої черги, високу глибину робочої черги та/або велику тривалість обробки в робочій черзі, це свідчить про те, що контролер працює не оптимально. Розгляньте можливість налаштування таких параметрів, як QPS, burst і конфігурації CPU/памʼяті.
Якщо ви спостерігаєте високу швидкість додавання до робочої черги, високу глибину робочої черги, але прийнятну тривалість обробки, це вказує на те, що контролер обробляє роботу, але паралелізму може бути недостатньо. Паралелізм жорстко закодований у контролері, тому як адміністратор кластера ви можете налаштувати це, зменшивши QPS створення Podʼів, щоб швидкість додавання до робочої черги ResourceClaim стала більш керованою.
Метрики kube-scheduler
Наведені нижче метрики планувальника є високорівневими й агрегують продуктивність усіх запланованих Podʼів, а не лише тих, що використовують DRA. Важливо зазначити, що на наскрізні метрики зрештою впливає продуктивність kube-controller-manager у створенні ResourceClaims з ResourceClaimTemplates у розгортаннях, які інтенсивно використовують ResourceClaimTemplates.
Наскрізна тривалість роботи планувальника: відстежуйте histogram_quantile(0.99,sum(increase(scheduler_pod_scheduling_sli_duration_seconds_bucket[5m]))by(le)).
Коли для Podʼа, привʼязаного до вузла, має бути задоволений ResourceClaim, kubelet викликає методи NodePrepareResources та NodeUnprepareResources драйвера DRA. Ви можете спостерігати цю поведінку з погляду kubelet за допомогою наведених нижче метрик.
Драйвери DRA реалізують інтерфейс пакунка kubeletplugin, який надає власну метрику для базових операцій gRPC NodePrepareResources та NodeUnprepareResources. Ви можете спостерігати цю поведінку з погляду внутрішнього kubeletplugin за допомогою наведених нижче метрик.
Операція DRA kubeletplugin gRPC NodePrepareResources: відстежуйте histogram_quantile(0.99,sum(rate(dra_grpc_operations_duration_seconds_bucket{method_name=~".*NodePrepareResources"}[5m]))by(le)).
Операція DRA kubeletplugin gRPC NodeUnprepareResources: відстежуйте histogram_quantile(0.99,sum(rate(dra_grpc_operations_duration_seconds_bucket{method_name=~".*NodeUnprepareResources"}[5m]))by(le)).
9 - Версія сумісності для компонентів панелі управління Kubernetes
Починаючи з випуску v1.32, ми запровадили для компонентів панелі управління Kubernetes налаштовувані параметри сумісності версій та емуляції, щоб зробити оновлення безпечнішими, надаючи адміністраторам кластерів більше контролю й дрібніші кроки.
Емульована версія
Параметр емуляції задається прапорцем --emulated-version компонентів панелі управління. Він дозволяє компоненту емулювати поведінку (API, можливості тощо) старішої версії Kubernetes.
Під час його використання доступні можливості відповідатимуть емульованій версії:
Будь-які можливості бінарної версії, додані після емульованої версії, будуть недоступні.
Будь-які можливості, вилучені після емульованої версії, будуть доступні.
Це дозволяє бінарному файлу певного випуску Kubernetes емулювати поведінку попередньої версії настільки точно, що сумісність з іншими компонентами системи можна визначати в термінах емульованої версії.
Значення --emulated-version має бути <= binaryVersion. Діапазон підтримуваних емульованих версій дивіться в довідці до прапорця --emulated-version.
10 - Метрики для системних компонентів Kubernetes
Метрики системних компонентів дають змогу краще зрозуміти, що відбувається всередині них. Метрики особливо корисні для побудови dashboards та сповіщень.
Компоненти Kubernetes надають метрики у форматі Prometheus. Цей формат — структурований звичайний текст, який можуть читати як люди, так і машини.
Метрики в Kubernetes
У більшості випадків метрики доступні в точці доступу /metrics HTTP-сервера. Для компонентів, які стандартно не відкривають цю точку доступу, її можна ввімкнути за допомогою прапорця --bind-address.
У промисловому середовищі варто налаштувати Prometheus Server або інший збирач метрик, щоб періодично збирати ці метрики й робити їх доступними в базі даних часових рядів.
Зверніть увагу, що kubelet також надає метрики через точки доступу /metrics/cadvisor, /metrics/resource та /metrics/probes. Ці метрики мають інший життєвий цикл.
Якщо ваш кластер використовує RBAC, для читання метрик потрібна авторизація через користувача, групу або ServiceAccount з ClusterRole, що дозволяє доступ до /metrics. Наприклад:
apiVersion:rbac.authorization.k8s.io/v1kind:ClusterRolemetadata:name:prometheusrules:- nonResourceURLs:- "/metrics"verbs:- get
Альфа-метрики не мають гарантій стабільності. Ці метрики можуть бути змінені або видалені в будь-який момент.
Бета-метрики дотримуються менш суворого контракту API, ніж стабільні. Із бета-метрик не можна вилучати мітки протягом їх життєвого циклу, однак мітки можна додавати, поки метрика перебуває на стадії бета.
Стабільні метрики гарантовано не змінюються. Це означає:
Стабільну метрику без ознаки застарілості не буде видалено чи перейменовано
Тип стабільної метрики не буде змінено
Застарілі метрики заплановано до видалення, але вони все ще доступні для використання. Ці метрики містять анотацію з версією, у якій вони стали застарілими.
Наприклад:
Перед застаріванням
# HELP some_counter this counts things
# TYPE some_counter counter
some_counter 0
Після застарівання
# HELP some_counter (Deprecated since 1.15.0) this counts things
# TYPE some_counter counter
some_counter 0
Приховані метрики більше не публікуються для збирання, але все ще доступні для використання. Застаріла метрика стає прихованою через певний час, залежно від її рівня стабільності:
STABLE метрики стають прихованими щонайменше через 3 випуски або 9 місяців, залежно від того, що довше.
BETA метрики стають прихованими щонайменше через 1 випуск або 4 місяці, залежно від того, що довше.
ALPHA метрики можуть бути приховані або видалені в тому самому випуску, в якому вони стали застарілими.
Щоб використовувати приховану метрику, її потрібно ввімкнути. Докладніше дивіться в розділі Показ прихованих метрик.
Видалені метрики більше не публікуються і не можуть бути використані.
Показ прихованих метрик
Як описано вище, адміністратори можуть увімкнути приховані метрики через прапорець командного рядка конкретного бінарного файлу. Це запасний варіант для адміністраторів, які пропустили міграцію з метрик, що стали застарілими в останньому випуску.
Прапорець show-hidden-metrics-for-version приймає версію, для якої потрібно показати метрики, що стали застарілими в цьому випуску. Версія зазначається як x.y, де x — мажорна версія, y — мінорна версія. Патч-версія не потрібна: хоча метрика може стати застарілою в патч-випуску, політика застарівання метрик працює на рівні мінорних випусків.
Прапорець може приймати лише попередню мінорну версію. Якщо ви хочете показати всі метрики, приховані в попередньому випуску, встановіть прапорець show-hidden-metrics-for-version на попередню версію. Використання надто старої версії не дозволено, оскільки це порушує політику застарівання метрик.
Наприклад, припустімо, що метрика A стала застарілою в 1.29. Версія, в якій метрика A стає прихованою, залежить від її рівня стабільності:
Якщо метрика A є ALPHA, вона може бути прихована в 1.29.
Якщо метрика A є BETA, вона буде прихована не раніше ніж у 1.30. Якщо ви оновлюєтесь до 1.30 і все ще потребуєте A, ви повинні використовувати прапорець командного рядка --show-hidden-metrics-for-version=1.29.
Якщо метрика A є STABLE, вона буде прихована не раніше ніж у 1.32. Якщо ви оновлюєтесь до 1.32 і все ще потребуєте A, ви повинні використовувати прапорець командного рядка --show-hidden-metrics-for-version=1.31.
Метрики компонентів
Метрики kube-controller-manager
Метрики менеджера контролерів дають важливе уявлення про продуктивність і справність менеджера контролерів. До цих метрик належать поширені метрики середовища виконання мови Go, такі як кількість go_routine, та специфічні для контролерів метрики, такі як затримки запитів до etcd або затримки API Cloudprovider (AWS, GCE, OpenStack), які можна використовувати для оцінки справності кластера.
Починаючи з Kubernetes 1.7, для операцій зі сховищем у GCE, AWS, Vsphere та OpenStack доступні докладні метрики Cloudprovider. Ці метрики можна використовувати для моніторингу справності операцій із постійними томами.
Планувальник надає необовʼязкові метрики, які повідомляють про запитані ресурси та бажані обмеження всіх запущених Podʼів. Ці метрики можна використовувати для побудови dashboards планування місткості, оцінки поточних або історичних обмежень планування, швидкого виявлення робочих навантажень, які не можуть бути заплановані через брак ресурсів, і порівняння фактичного використання із запитом Podʼа.
kube-scheduler визначає запити та обмеження ресурсів, налаштовані для кожного Podʼа; коли запит або обмеження не дорівнює нулю, kube-scheduler повідомляє часовий ряд метрик. Часовий ряд має такі мітки:
простір імен
назва Podʼа
вузол, на який заплановано Pod, або порожній рядок, якщо його ще не заплановано
пріоритет
призначений планувальник для цього Podʼа
назва ресурсу (наприклад, cpu)
одиниця ресурсу, якщо відома (наприклад, cores)
Щойно Pod завершує роботу (має restartPolicy зі значенням Never або OnFailure і перебуває у фазі Succeeded або Failed, або його видалено, і всі контейнери перебувають у стані завершення), часовий ряд більше не повідомляється, оскільки тепер планувальник може запланувати запуск інших Podʼів. Ці дві метрики називаються kube_pod_resource_request та kube_pod_resource_limit.
Метрики доступні через HTTP-точку доступу /metrics/resources. Для них потрібна авторизація для точки доступу /metrics/resources, яку зазвичай надає ClusterRole з дієсловом get для URL /metrics/resources, що не є ресурсом.
У Kubernetes 1.21 потрібно використовувати прапорець --show-hidden-metrics-for-version=1.20, щоб показати ці альфа-метрики.
Метрики kubelet Pressure Stall Information (PSI)
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.36
More information about this feature
This is a stable feature in Kubernetes, and has been since version v1.36. It was first available in the v1.33 release. You can no longer disable or opt out of this feature or behavior (it is locked); if you explicitly set a value for the associated feature gate KubeletPSI, Kubernetes ignores it but does not report any error.
Якщо в ядрі ввімкнено PSI (версія 4.20 або новіша), kubelet збирає Pressure Stall Information (PSI) щодо використання CPU, памʼяті та вводу-виводу. Інформація збирається на рівні вузла, Podʼа та контейнера.
Метрики Prometheus: надаються через точку доступу /metrics/cadvisor у вигляді кумулятивних лічильників (totals), що відображають загальний час затримки в секундах. Метрики доступні через цю точку доступу під такими назвами:
Summary API: надається через точку доступу /stats/summary, повертаючи як кумулятивні totals, так і ковзні середні (avg10, avg60, avg300) у форматі JSON. Ці середні значення показують відсоток часу, протягом якого завдання були затримані на ресурсі за відповідні інтервали 10 секунд, 60 секунд і 5 хвилин.
Ці метрики також нативно експортуються через відповідний файл вузла в /proc/pressure/ — cpu, memory та io — у такому форматі:
Як можна інтерпретувати ці метрики разом? Візьмемо, наприклад, такий запит до Summary API: kubectl get --raw "/api/v1/nodes/$(kubectl get nodes -o jsonpath='{.items[0].metadata.name}')/proxy/stats/summary" | jq '.pods[].containers[] | select(.name=="<CONTAINER_NAME>") | {name, cpu: .cpu.psi, memory: .memory.psi, io: .io.psi}'.
Це повертає інформацію у форматі JSON, як показано нижче.
Ось простий сценарій сплеску. Значення avg10 для cpu.some, що дорівнює 0.74, означає, що за останні 10 секунд принаймні одне завдання в цьому контейнері було затримано на CPU протягом 0.74% часу (0.0074 секунди або 74 мілісекунди). Оскільки avg10 (0.74) значно перевищує avg300 (0.21) для того самого ресурсу, це свідчить про недавній сплеск конкуренції за ресурси, а не про тривале вузьке місце. Якщо постійно стежити за метриками й avg300 також зростає, можна діагностувати серйознішу, тривалу проблему!
Крім того, зверніть увагу, що в цьому прикладі cpu.some показує тиск, тоді як cpu.full залишається на рівні 0.00. Це означає, що хоча деякі процеси були затримані в очікуванні часу CPU, контейнер загалом продовжував роботу. Ненульове значення full означало б, що всі завдання, які не простоюють, були затримані одночасно, а це набагато серйозніша проблема. Хоча значення total 35232438 не так зручно читати людині, воно показує кумулятивний час затримки в мікросекундах, що дозволяє виявляти сплески затримки, які інакше можуть не проявитися в середніх значеннях. Такі значення також корисні для систем моніторингу, таких як Prometheus, для точного обчислення темпів зростання за певні часові вікна. І наостанок: високий тиск на I/O разом із низьким тиском на памʼять може означати, що застосунок очікує на пропускну здатність диска, а не страждає від браку доступної оперативної памʼяті. Вузол не перевантажений за памʼяттю, тому варто окремо дослідити споживання диска.
Метрики PSI дають надійніший спосіб моніторингу конкуренції за ресурси в реальному часі на всіх рівнях для кожної cgroup, відкриваючи можливість динамічно обробляти робочі навантаження в усій системі. Докладніше про метрики PSI читайте в Understand PSI Metrics.
Ви можете явно вимкнути метрики за допомогою прапорця командного рядка --disabled-metrics. Це може знадобитися, наприклад, якщо метрика спричиняє проблеми з продуктивністю. Вхідні дані — це список вимкнених метрик (тобто --disabled-metrics=metric1,metric2).
Обмеження кардинальності метрик
Метрики з необмеженими вимірами можуть спричиняти проблеми з памʼяттю в компонентах, які вони інструментують. Щоб обмежити використання ресурсів, ви можете використовувати параметр командного рядка --allow-metric-labels, щоб динамічно налаштувати список дозволених значень міток для метрики.
На стадії альфа цей прапорець може приймати лише серію зіставлень як список дозволених міток метрики. Кожне зіставлення має формат <metric_name>,<label_name>=<allowed_labels>, де <allowed_labels> — розділений комами список допустимих назв міток.
Окрім командного рядка, це можна зробити й у конфігураційному файлі. Шлях до цього файлу можна вказати за допомогою аргументу командного рядка --allow-metric-labels-manifest для компонента. Ось приклад вмісту такого конфігураційного файлу:
Крім того, мета-метрика cardinality_enforcement_unexpected_categorizations_total записує кількість неочікуваних категоризацій під час обмеження кардинальності, тобто щоразу, коли трапляється значення мітки, не дозволене обмеженнями списку дозволених значень.
kube-state-metrics — це агент-надбудова для генерації та надання метрик на рівні кластера.
Стан обʼєктів Kubernetes в API Kubernetes можна надавати у вигляді метрик. Агент-надбудова kube-state-metrics може підʼєднуватися до API-сервера Kubernetes і надавати HTTP-точку доступу з метриками, згенерованими зі стану окремих обʼєктів у кластері. Він надає різну інформацію про стан обʼєктів, таку як мітки й анотації, час запуску та завершення, статус або фазу, у якій зараз перебуває обʼєкт. Наприклад, контейнери, що працюють у Podʼах, створюють метрику kube_pod_container_info. Вона містить як мітки назву контейнера, назву Podʼа, до якого він належить, простір імен, у якому працює Pod, назву образу контейнера, ідентифікатор образу, назву образу зі специфікації контейнера, ідентифікатор запущеного контейнера та ідентифікатор Podʼа.
🛇 Цей елемент посилається на сторонній проєкт або продукт, який не є частиною Kubernetes. Докладніше
Зовнішній компонент, здатний збирати дані з точки доступу kube-state-metrics (наприклад, через Prometheus), тепер можна використовувати для таких сценаріїв.
Приклад: використання метрик з kube-state-metrics для запиту стану кластера
Серії метрик, які генерує kube-state-metrics, допомагають глибше зрозуміти стан кластера, оскільки їх можна використовувати в запитах.
Якщо ви використовуєте Prometheus або інший інструмент із тією самою мовою запитів, наведений нижче запит PromQL повертає кількість Podʼів, які не готові:
count(kube_pod_status_ready{condition="false"}) by (namespace, pod)
Приклад: сповіщення на основі kube-state-metrics
Метрики, які генерує kube-state-metrics, також дозволяють налаштовувати сповіщення про проблеми в кластері.
Якщо ви використовуєте Prometheus або подібний інструмент із тією самою мовою правил сповіщень, наведене нижче сповіщення спрацює, якщо є Podʼи, які перебувають у стані Terminating понад 5 хвилин:
groups:- name:Pod staterules:- alert:PodsBlockedInTerminatingStateexpr:count(kube_pod_deletion_timestamp) by (namespace, pod) * count(kube_pod_status_reason{reason="NodeLost"} == 0) by (namespace, pod) > 0for:5mlabels:severity:pageannotations:summary:Pod {{$labels.namespace}}/{{$labels.pod}} blocked in Terminating state.
12 - Системні логи
Логи системних компонентів фіксують події, що відбуваються в кластері, і це може бути дуже корисно для налагодження. Ви можете налаштувати рівень деталізації логів, щоб бачити більше або менше подробиць. Логи можуть бути як грубозернистими, показуючи лише помилки в компоненті, так і дрібнозернистими, показуючи покрокове трасування подій (наприклад, логи доступу HTTP, зміни стану Podʼів, дії контролерів або рішення планувальника).
Попередження:
На відміну від описаних тут прапорців командного рядка, сам вивід логівне підпадає під гарантії стабільності API Kubernetes: окремі записи логів та їх форматування можуть змінюватися від випуску до випуску!
Klog
klog — це бібліотека логування Kubernetes. klog генерує повідомлення логів для системних компонентів Kubernetes.
Kubernetes поступово спрощує логування у своїх компонентах. Наведені нижче прапорці командного рядка klog застаріли, починаючи з Kubernetes v1.23, і вилучені в Kubernetes v1.26:
--add-dir-header
--alsologtostderr
--log-backtrace-at
--log-dir
--log-file
--log-file-max-size
--logtostderr
--one-output
--skip-headers
--skip-log-headers
--stderrthreshold
Вивід завжди записується у stderr незалежно від формату виводу. Очікується, що перенаправленням виводу займається компонент, який викликає компонент Kubernetes. Це може бути оболонка POSIX або інструмент на кшталт systemd.
У деяких випадках, наприклад у контейнері distroless або системній службі Windows, ці варіанти недоступні. Тоді можна використати бінарний файл kube-log-runner як обгортку навколо компонента Kubernetes для перенаправлення виводу. Попередньо зібраний бінарний файл входить до кількох базових образів Kubernetes під традиційною назвою /go-runner і як kube-log-runner в архівах випусків для сервера та вузлів.
Ця таблиця показує відповідність викликів kube-log-runner перенаправленню в оболонці:
Рядок повідомлення може містити перенесення рядків:
I1025 00:15:15.525108       1 example.go:79] This is a message
which has a line break.
Структуроване логування
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.23
Попередження:
Міграція на структуровані повідомлення логів — поточний процес. У цій версії не всі повідомлення логів структуровані. Під час розбору файлів логів потрібно також обробляти неструктуровані повідомлення логів.
Форматування логів та серіалізація значень можуть змінюватися.
Структуроване логування додає до повідомлень логів єдину структуру, що дає змогу отримувати з них інформацію програмно. Ви можете зберігати та обробляти структуровані логи з меншими зусиллями та витратами. Код, який генерує повідомлення логу, визначає, чи використовує він традиційний неструктурований вивід klog, чи структуроване логування.
Стандартно структуровані повідомлення логів форматуються як текст у форматі, зворотно сумісному з традиційним klog:
I1025 00:15:15.525108 1 controller_utils.go:116] "Pod status updated" pod="kube-system/kubedns" status="ready"
Рядки беруться в лапки. Інші значення форматуються за допомогою %+v, через що повідомлення логів можуть продовжуватися на наступному рядку залежно від даних.
I1025 00:15:15.525108       1 example.go:116] "Example" data="This is text with a line break\nand \"quotation marks\"." someInt=1 someFloat=0.1 someStruct={StringField: First line,
second line.}
Контекстне логування
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.30
Контекстне логування побудоване на основі структурованого логування. Це переважно стосується того, як розробники використовують виклики логування: код, побудований на цій концепції, гнучкіший і підтримує додаткові сценарії використання, описані в KEP про контекстне логування.
Якщо розробники використовують у своїх компонентах додаткові функції, такі як WithValues або WithName, то записи логів міститимуть додаткову інформацію, яку передає у функції код, що їх викликає.
У Kubernetes 1.37 це керується функціональною можливістю ContextualLogging, яку стандартно ввімкнено. Інфраструктуру для цього додано у версії 1.24 без змін у компонентах. Команда component-base/logs/example показує, як використовувати нові виклики логування та як поводиться компонент, що підтримує контекстне логування.
$cd$GOPATH/src/k8s.io/kubernetes/staging/src/k8s.io/component-base/logs/example/cmd/
$ go run . --help
...
--feature-gates mapStringBool A set of key=value pairs that describe feature gates for alpha/experimental features. Options are:
AllAlpha=true|false (ALPHA - default=false)
AllBeta=true|false (BETA - default=false)
ContextualLogging=true|false (BETA - default=true)
$ go run . --feature-gates ContextualLogging=true...
I0222 15:13:31.645988 197901 example.go:54] "runtime" logger="example.myname" foo="bar" duration="1m0s"
I0222 15:13:31.646007 197901 example.go:55] "another runtime" logger="example" foo="bar" duration="1h0m0s" duration="1m0s"
Ключ logger та foo="bar" додано кодом, що викликає функцію, яка записує повідомлення runtime і значення duration="1m0s", без потреби змінювати цю функцію.
Коли контекстне логування вимкнено, WithValues і WithName нічого не роблять, а виклики логування проходять через глобальний логер klog. Тому цієї додаткової інформації більше немає у виводі логів:
$ go run . --feature-gates ContextualLogging=false...
I0222 15:14:40.497333 198174 example.go:54] "runtime" duration="1m0s"
I0222 15:14:40.497346 198174 example.go:55] "another runtime" duration="1h0m0s" duration="1m0s"
Не всі логи гарантовано записуються у форматі JSON (наприклад, під час запуску процесу). Якщо ви плануєте розбирати логи, переконайтеся, що можете обробляти й рядки логів, які не є JSON.
Назви полів та серіалізація JSON можуть змінюватися.
Прапорець --logging-format=json змінює формат логів із власного формату klog на формат JSON. Приклад логу у форматі JSON (відформатований для зручності читання):
{"ts":1580306777.04728,"v":4,"msg":"Pod status updated","pod":{"name":"nginx-1","namespace":"default"},"status":"ready"}
Ключі з особливим значенням:
ts — позначка часу у форматі Unix (обовʼязково, дійсне число)
v — рівень деталізації (лише для інформаційних повідомлень, не для повідомлень про помилки, ціле число)
err — рядок помилки (необовʼязково, рядок)
msg — повідомлення (обовʼязково, рядок)
Перелік компонентів, які наразі підтримують формат JSON:
Прапорець -v керує рівнем деталізації логів. Збільшення значення збільшує кількість подій, що логуються. Зменшення значення зменшує кількість подій, що логуються. Вищі рівні деталізації додають до логів дедалі менш важливі події. На рівні деталізації 0 логуються лише критичні події.
Розташування логів
Є два види системних компонентів: ті, що працюють у контейнері, і ті, що не працюють у контейнері. Наприклад:
Планувальник Kubernetes та kube-proxy працюють у контейнері.
На машинах із systemd kubelet і середовище виконання контейнерів пишуть у journald. В іншому разі вони пишуть у файли .log у теці /var/log. Системні компоненти всередині контейнерів завжди пишуть у файли .log у теці /var/log, оминаючи стандартний механізм логування. Як і для логів контейнерів, вам слід виконувати ротацію логів системних компонентів у теці /var/log. У кластерах Kubernetes, створених сценарієм kube-up.sh, ротацію логів налаштовано за допомогою інструмента logrotate. Інструмент logrotate виконує ротацію логів щодня або коли розмір логу перевищує 100MB.
Запит логів
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.36; (стандартно увімкнено)
More information about this feature
This is a stable feature in Kubernetes, and has been since version 1.36. It was first available in the v1.27 release.
Можливість Log Query допомагає налагоджувати проблеми на вузлах Linux і Windows. Запроваджена в Kubernetes v1.27, вона дозволяє переглядати логи сервісів, що працюють на вузлі. Щоб скористатися цією можливістю, переконайтеся, що для цільового вузла обидва параметри конфігурації kubelet enableSystemLogHandler та enableSystemLogQuery встановлено в true.
У Kubernetes v1.36 ця можливість стала стабільною, і функціональну можливість NodeLogQuery тепер зафіксовано в true, тобто її стандартно ввімкнено, а enableSystemLogHandler залишається єдиним параметром, потрібним для ввімкнення або вимкнення Log Query.
Стандартно enableSystemLogHandler має значення false, і його рекомендується залишати вимкненим, окрім випадків активного налагодження.
Попередження:
Надання дозволів на nodes/proxy (навіть лише дозволу get) також відкриває доступ до потужних API kubelet, які можна використовувати для виконання команд у будь-якому контейнері, що працює на вузлі, тому будьте обережні з керуванням цими дозволами. Докладніше дивіться в розділі Автентифікація/авторизація kubelet.
У Linux передбачається, що логи сервісів доступні через journald. У Windows передбачається, що логи сервісів доступні через провайдера логів застосунків. В обох операційних системах логи також доступні через читання файлів у /var/log/.
Якщо у вас є дозвіл на взаємодію з обʼєктами Node, ви можете спробувати цю можливість на всіх своїх вузлах або лише на їх частині. Ось приклад отримання логів сервісу kubelet із вузла:
# Отримати логи kubelet з вузла під назвою node-1.examplekubectl get --raw "/api/v1/nodes/node-1.example/proxy/logs/?query=kubelet"
Ви також можете отримувати файли, якщо вони розташовані в теці, з якої kubelet дозволяє отримувати логи. Наприклад, можна отримати лог із /var/log на вузлі Linux:
kubectl get --raw "/api/v1/nodes/<назва-вузла>/proxy/logs/?query=/<назва-файлу-логу>"
kubelet використовує евристику для отримання логів. Це допомагає, якщо ви не знаєте, чи певний системний сервіс записує логи до власного логера операційної системи, такого як journald, чи до файлу логу в /var/log/. Евристика спочатку перевіряє власний логер, а якщо він недоступний, намагається отримати перші логи з /var/log/<назва-сервісу> або /var/log/<назва-сервісу>.log чи /var/log/<назва-сервісу>/<назва-сервісу>.log.
Повний перелік параметрів, які можна використовувати:
Параметр
Опис
boot
показує повідомлення з певного завантаження системи
pattern
фільтрує записи логів за вказаним регулярним виразом, сумісним із PERL
query
вказує сервіс(и) або файли, з яких потрібно повернути логи (обовʼязково)
sinceTime
позначка часу RFC3339, починаючи з якої показувати логи (включно)
untilTime
позначка часу RFC3339, до якої показувати логи (включно)
tailLines
вказує, скільки рядків із кінця логу отримати; стандартно отримується весь лог
Приклад складнішого запиту:
# Отримати логи kubelet з вузла під назвою node-1.example, у яких є слово "error"kubectl get --raw "/api/v1/nodes/node-1.example/proxy/logs/?query=kubelet&pattern=error"
Трейси системних компонентів реєструють затримки операцій у кластері та звʼязки між ними.
Компоненти Kubernetes надсилають трейси за допомогою протоколу OpenTelemetry з експортером gRPC, а зібрати їх і спрямувати до бекендів трасування можна за допомогою OpenTelemetry Collector.
Збір трейсів
Компоненти Kubernetes мають вбудовані експортери gRPC для OTLP, які експортують трейси через OpenTelemetry Collector або без нього.
Повний посібник зі збору трейсів і використання колектора дивіться в розділі Початок роботи з OpenTelemetry Collector. Однак є кілька особливостей, специфічних для компонентів Kubernetes.
Стандартно компоненти Kubernetes експортують трейси за допомогою експортера grpc для OTLP на порт IANA OpenTelemetry, 4317. Наприклад, якщо колектор працює як sidecar-контейнер поруч із компонентом Kubernetes, така конфігурація приймача збиратиме відрізки й записуватиме їх у стандартний вивід:
receivers:otlp:protocols:grpc:exporters:# Замініть цей експортер на експортер для вашого бекендуexporters:debug:verbosity:detailedservice:pipelines:traces:receivers:[otlp]exporters:[debug]
Щоб надсилати трейси безпосередньо до бекенду без колектора, вкажіть у полі endpoint файлу конфігурації трасування Kubernetes адресу потрібного бекенду трасування. Цей метод усуває потребу в колекторі та спрощує загальну структуру.
Для налаштування заголовків бекенду трасування, зокрема даних автентифікації, можна використовувати змінну середовища OTEL_EXPORTER_OTLP_HEADERS, дивіться Конфігурація експортера OTLP.
Крім того, для налаштування атрибутів ресурсів трейсів, таких як назва кластера Kubernetes, простір імен, назва Podʼа тощо, також можна використовувати змінну середовища OTEL_RESOURCE_ATTRIBUTES, дивіться Ресурс Kubernetes в OTLP.
Трейси компонентів
Трейси kube-apiserver
kube-apiserver генерує відрізки для вхідних HTTP-запитів, а також для вихідних запитів до вебхуків, etcd та повторно вхідних запитів. Він передає W3C Trace Context з вихідними запитами, але не використовує контекст трейса, доданий до вхідних запитів, оскільки kube-apiserver часто є публічною точкою доступу.
Увімкнення трасування в kube-apiserver
Щоб увімкнути трасування, передайте kube-apiserver файл конфігурації трасування за допомогою --tracing-config-file=<шлях-до-конфігурації>. Ось приклад конфігурації, яка записує відрізки для 1 з 10000 запитів і використовує стандартну точку доступу OpenTelemetry:
This is a stable feature in Kubernetes, and has been since version v1.34. It was first available in the v1.25 release. You can no longer disable or opt out of this feature or behavior (it is locked); if you explicitly set a value for the associated feature gate KubeletTracing, Kubernetes ignores it but does not report any error.
Інтерфейс CRI kubelet та його автентифіковані http-сервери інструментовано для генерації відрізків трейсів. Як і для apiserver, точку доступу та частоту відбору можна налаштувати. Поширення контексту трейсів також налаштовується. Рішення батьківського відрізка щодо відбору завжди враховується. Частота відбору з наданої конфігурації трасування застосовується до відрізків без батьківського. Якщо трасування ввімкнено без налаштованої точки доступу, використовується стандартна адреса приймача OpenTelemetry Collector "localhost:4317".
Увімкнення трасування в kubelet
Щоб увімкнути трасування, застосуйте конфігурацію трасування. Ось приклад фрагмента конфігурації kubelet, що записує відрізки для 1 з 10000 запитів і використовує стандартну точку доступу OpenTelemetry:
Якщо samplingRatePerMillion встановлено на мільйон (1000000), кожен відрізок буде надіслано до експортера.
kubelet у Kubernetes v1.37 збирає відрізки зі збору сміття, процедури синхронізації Podʼів, а також з кожного методу gRPC. kubelet передає контекст трейсів із запитами gRPC, щоб середовища виконання контейнерів з інструментуванням трейсів, такі як CRI-O та containerd, могли повʼязувати свої експортовані відрізки з контекстом трейсів від kubelet. Отримані трейси матимуть звʼязки батько-нащадок між відрізками kubelet і середовища виконання контейнерів, що дає корисний контекст під час налагодження проблем вузла.
Зверніть увагу, що експорт відрізків завжди спричиняє невеликі накладні витрати на мережу та CPU, залежно від загальної конфігурації системи. Якщо в кластері з увімкненим трасуванням виникає така проблема, помʼякшіть її, зменшивши samplingRatePerMillion або повністю вимкнувши трасування через видалення конфігурації.
Стабільність
Інструментування трасування все ще активно розробляється і може змінюватися різними способами. Це стосується назв відрізків, приєднаних атрибутів, інструментованих точок доступу тощо. Поки ця можливість не стане стабільною, гарантій зворотної сумісності для інструментування трасування немає.
Проксі/балансувальник навантаження перед одним або кількома apiserver:
наявність та реалізація різняться від кластера до кластера (наприклад, nginx)
розташований між усіма клієнтами та одним або кількома apiserver
діє як балансувальник навантаження, якщо є кілька apiserver.
Хмарні балансувальники навантаження для зовнішніх Services:
надаються деякими хмарними провайдерами (наприклад, AWS ELB, Google Cloud Load Balancer)
створюються автоматично, коли Service у Kubernetes має тип LoadBalancer
зазвичай підтримують лише UDP/TCP
підтримка SCTP залежить від реалізації балансувальника навантаження хмарного провайдера
реалізація залежить від хмарного провайдера.
Зазвичай користувачам Kubernetes не потрібно турбуватися ні про що, крім перших двох типів. За правильне налаштування решти типів зазвичай відповідає адміністратор кластера.
Запит на перенаправлення
Проксі замінили можливості перенаправлення. Перенаправлення визнано застарілими.
15 - API Priority and Fairness
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.29
Керування поведінкою API-сервера Kubernetes у ситуації перевантаження — ключове завдання адміністраторів кластера. kube-apiserver має певні засоби керування (тобто прапорці командного рядка --max-requests-inflight та --max-mutating-requests-inflight), щоб обмежити обсяг незавершеної роботи, яка приймається, запобігаючи перевантаженню й можливому збою API-сервера через потік вхідних запитів, але цих прапорців недостатньо, щоб найважливіші запити проходили в період високого навантаження.
Можливість API Priority and Fairness (APF) — це альтернатива, яка усуває згадані обмеження max-inflight. APF класифікує та ізолює запити точніше. Вона також запроваджує обмежене чергування, щоб під час дуже коротких сплесків запити не відхилялися. Запити вибираються з черг за технікою справедливого чергування, тому, наприклад, контролер, який погано поводиться, не позбавить ресурсів інші (навіть на тому самому рівні пріоритету).
Ця можливість розроблена так, щоб добре працювати зі стандартними контролерами, які використовують інформери й реагують на збої API-запитів експоненційним back-off, та з іншими клієнтами, що працюють так само.
Увага:
Деякі запити, класифіковані як «тривалі», — наприклад, віддалене виконання команд або читання кінця логів (tail), — не підпадають під фільтр API Priority and Fairness. Це також стосується прапорця --max-requests-inflight без увімкненої можливості API Priority and Fairness. API Priority and Fairness застосовується до запитів watch. Коли API Priority and Fairness вимкнено, запити watch не підпадають під обмеження --max-requests-inflight.
Увімкнення/вимкнення API Priority and Fairness
Можливість API Priority and Fairness керується прапорцем командного рядка і стандартно ввімкнена. Загальне пояснення доступних параметрів командного рядка kube-apiserver та способів їх увімкнення й вимкнення дивіться в розділі Options. Назва параметра командного рядка для APF — "--enable-priority-and-fairness". Ця можливість також використовує групу API із: (a) стабільною версією v1, запровадженою у 1.29 і стандартно ввімкненою, (b) версією v1beta3, стандартно ввімкненою і застарілою у v1.29. Ви можете вимкнути бета-версію групи API v1beta3, додавши такі прапорці командного рядка до виклику kube-apiserver:
kube-apiserver \
--runtime-config=flowcontrol.apiserver.k8s.io/v1beta3=false\
# …і інші прапорці, як завжди
Прапорець командного рядка --enable-priority-and-fairness=false вимкне можливість API Priority and Fairness.
Рекурсивні сценарії сервера
API Priority and Fairness слід використовувати обережно в рекурсивних сценаріях сервера. Це сценарії, у яких сервер A, обробляючи запит, надсилає допоміжний запит на сервер B. Сервер B може навіть зробити ще один допоміжний виклик назад до сервера A. У ситуаціях, коли контроль Priority and Fairness застосовується як до початкового запиту, так і до деяких допоміжних, незалежно від глибини рекурсії, існує небезпека інверсії пріоритетів та/або взаємоблокувань.
Один із прикладів рекурсії — коли kube-apiserver викликає вебхук допуску на сервері B, і під час обробки цього виклику сервер B робить ще один допоміжний запит назад до kube-apiserver. Інший приклад рекурсії — коли обʼєкт APIService вказує kube-apiserver делегувати запити щодо певної групи API власному зовнішньому серверу B (це одне з того, що називають «агрегацією»).
Коли відомо, що початковий запит належить до певного рівня пріоритету, а допоміжні контрольовані запити класифікуються на вищі рівні пріоритету, це одне з можливих рішень. Коли початкові запити можуть належати до будь-якого рівня пріоритету, допоміжні контрольовані запити мають бути звільнені від обмежень Priority and Fairness. Один зі способів зробити це — обʼєкти, які налаштовують класифікацію та обробку, описані нижче. Інший спосіб — повністю вимкнути Priority and Fairness на сервері B за допомогою описаних вище прийомів. Третій спосіб, найпростіший, коли сервер B не є kube-apiserver, — зібрати сервер B із вимкненим у коді Priority and Fairness.
Концепції
Можливість API Priority and Fairness складається з кількох окремих механізмів. Вхідні запити класифікуються за атрибутами запиту за допомогою FlowSchemas і призначаються рівням пріоритету. Рівні пріоритету додають певну ізоляцію завдяки окремим обмеженням паралелізму, тому запити, призначені різним рівням пріоритету, не можуть позбавити ресурсів один одного. У межах рівня пріоритету алгоритм справедливого чергування не дозволяє запитам із різних потоків позбавляти ресурсів один одного й дозволяє ставити запити в чергу, щоб сплески трафіку не спричиняли збої запитів, коли середнє навантаження прийнятно низьке.
Рівні пріоритету
Без увімкненої APF загальний паралелізм в API-сервері обмежується прапорцями kube-apiserver--max-requests-inflight та --max-mutating-requests-inflight. З увімкненою APF обмеження паралелізму, визначені цими прапорцями, сумуються, а потім сума розподіляється між налаштовуваним набором рівнів пріоритету. Кожен вхідний запит призначається одному рівню пріоритету, і кожен рівень пріоритету запускає лише стільки одночасних запитів, скільки дозволяє його власне обмеження.
Наприклад, стандартна конфігурація містить окремі рівні пріоритету для запитів виборів лідера, запитів від вбудованих контролерів і запитів від Podʼів. Це означає, що Pod, який поводиться погано й завалює API-сервер запитами, не може завадити виборам лідера чи діям вбудованих контролерів.
Обмеження паралелізму рівнів пріоритету періодично коригуються, що дозволяє недовикористаним рівням пріоритету тимчасово надавати паралелізм рівням із високим навантаженням. Ці обмеження базуються на номінальних обмеженнях і межах того, скільки паралелізму рівень пріоритету може надати та скільки може позичити; усі вони випливають з обʼєктів конфігурації, згаданих нижче.
Місця, які займає запит
Наведений вище опис керування паралелізмом — це базова модель. Запити мають різну тривалість, але в будь-який момент рахуються однаково під час порівняння з обмеженням паралелізму рівня пріоритету. У базовій моделі кожен запит займає одну одиницю паралелізму. Слово «місце» (seat) означає одну одиницю паралелізму; його навіяло те, як кожен пасажир у поїзді чи літаку займає одне з фіксованої кількості місць.
Але деякі запити займають більше ніж одне місце. Серед них запити list, які, за оцінкою сервера, повернуть велику кількість обʼєктів. Вони виявилися надзвичайно важким навантаженням для сервера. Тому сервер оцінює кількість обʼєктів, які буде повернуто, і вважає, що запит займає кількість місць, пропорційну цій оцінці.
Коригування часу виконання для запитів watch
API Priority and Fairness керує запитами watch, але це передбачає ще кілька відступів від базової поведінки. Перший стосується того, як довго запит watch вважається таким, що займає своє місце. Залежно від параметрів запиту відповідь на запит watch може починатися або не починатися зі сповіщень create для всіх відповідних наявних обʼєктів. API Priority and Fairness вважає, що запит watch звільняє своє місце, щойно цей початковий сплеск сповіщень (якщо він є) закінчився.
Звичайні сповіщення надсилаються одночасним сплеском до всіх відповідних потоків відповідей watch, коли сервер отримує сповіщення про створення, оновлення або видалення обʼєкта. Щоб врахувати цю роботу, API Priority and Fairness вважає, що кожен запит на запис займає місця ще певний час після завершення фактичного запису. Сервер оцінює кількість сповіщень, які буде надіслано, і коригує кількість місць запиту на запис і час їх зайнятості, щоб врахувати цю додаткову роботу.
Чергування
Навіть у межах рівня пріоритету може бути велика кількість різних джерел трафіку. У ситуації перевантаження важливо не дати одному потоку запитів позбавити ресурсів інші (зокрема, у відносно поширеному випадку, коли один клієнт із помилками завалює kube-apiserver запитами, такий клієнт в ідеалі взагалі не повинен помітно впливати на інших клієнтів). Для цього використовується алгоритм справедливого чергування, який обробляє запити, призначені одному рівню пріоритету. Кожен запит призначається потоку, який визначається назвою відповідної FlowSchema та розрізнювачем потоку — це або користувач, який надіслав запит, або простір імен цільового ресурсу, або нічого, — і система намагається надати приблизно однакову вагу запитам у різних потоках одного рівня пріоритету. Щоб різні екземпляри оброблялися окремо, контролери з багатьма екземплярами мають автентифікуватися з різними іменами користувачів.
Після класифікації запиту в потік API Priority and Fairness може призначити запит до черги. Для цього використовується техніка, відома як shuffle sharding, яка досить ефективно використовує черги, щоб ізолювати потоки низької інтенсивності від потоків високої інтенсивності.
Подробиці алгоритму чергування налаштовуються для кожного рівня пріоритету й дозволяють адміністраторам балансувати використання памʼяті, справедливість (властивість, за якої незалежні потоки просуваються, коли загальний трафік перевищує місткість), стійкість до сплесків трафіку та додаткову затримку через чергування.
Звільнені запити
Деякі запити вважаються настільки важливими, що на них не поширюються жодні обмеження цієї можливості. Ці винятки запобігають тому, щоб неправильно налаштоване керування потоком повністю вивело API-сервер з ладу.
Ресурси
API керування потоком використовує два види ресурсів. PriorityLevelConfigurations визначають доступні рівні пріоритету, частку доступного бюджету паралелізму, яку кожен із них може обробити, і дозволяють точно налаштовувати поведінку черг. FlowSchemas використовуються для класифікації окремих вхідних запитів, зіставляючи кожен з однією PriorityLevelConfiguration.
PriorityLevelConfiguration
PriorityLevelConfiguration представляє один рівень пріоритету. Кожна PriorityLevelConfiguration має незалежне обмеження на кількість незавершених запитів та обмеження на кількість запитів у черзі.
Номінальне обмеження паралелізму для PriorityLevelConfiguration задається не абсолютною кількістю місць, а «номінальними частками паралелізму» (nominal concurrency shares). Загальне обмеження паралелізму API-сервера розподіляється між наявними PriorityLevelConfiguration пропорційно цим часткам, що дає кожному рівню його номінальне обмеження в місцях. Це дозволяє адміністратору кластера збільшувати або зменшувати загальний обсяг трафіку до сервера, перезапускаючи kube-apiserver з іншим значенням --max-requests-inflight (або --max-mutating-requests-inflight), і максимально дозволений паралелізм усіх PriorityLevelConfiguration зросте (або зменшиться) на ту саму частку.
Увага:
У версіях до v1beta3 відповідне поле PriorityLevelConfiguration має назву "assured concurrency shares", а не "nominal concurrency shares". Також у випуску Kubernetes 1.25 та раніших періодичних коригувань не було: номінальні/гарантовані обмеження завжди застосовувалися без коригування.
Межі того, скільки паралелізму рівень пріоритету може надати та скільки може позичити, задаються в PriorityLevelConfiguration у відсотках від номінального обмеження рівня. Вони перетворюються на абсолютні кількості місць множенням на номінальне обмеження / 100.0 та округленням. Динамічно кориговане обмеження паралелізму рівня пріоритету має лежати між (a) нижньою межею: його номінальне обмеження мінус місця, які він може надати, та (b) верхньою межею: його номінальне обмеження плюс місця, які він може позичити. Під час кожного коригування динамічні обмеження визначаються так: кожен рівень пріоритету повертає надані місця, на які нещодавно зʼявився попит, а потім усі рівні спільно й справедливо відповідають на нещодавній попит на місця в межах щойно описаних меж.
Увага:
Коли можливість Priority and Fairness увімкнено, загальне обмеження паралелізму сервера дорівнює сумі --max-requests-inflight та --max-mutating-requests-inflight. Різниці між змінювальними та незмінювальними запитами більше немає; якщо ви хочете обробляти їх окремо для певного ресурсу, створіть окремі FlowSchemas, які відповідають змінювальним і незмінювальним дієсловам відповідно.
Коли обсяг вхідних запитів, призначених одній PriorityLevelConfiguration, перевищує її дозволений рівень паралелізму, поле type її специфікації визначає, що станеться із зайвими запитами. Тип Reject означає, що зайвий трафік буде негайно відхилено з помилкою HTTP 429 (Too Many Requests). Тип Queue означає, що запити понад поріг буде поставлено в чергу, а для балансування просування між потоками запитів використовуються техніки shuffle sharding і справедливого чергування.
Конфігурація чергування дозволяє налаштувати алгоритм справедливого чергування для рівня пріоритету. Подробиці алгоритму наведено в пропозиції щодо вдосконалення, а стисло:
Збільшення queues зменшує частоту зіткнень між різними потоками ціною більшого використання памʼяті. Значення 1 фактично вимикає логіку справедливого чергування, але все ще дозволяє ставити запити в чергу.
Збільшення queueLengthLimit дозволяє витримувати більші сплески трафіку без відкидання запитів ціною більшої затримки та використання памʼяті.
Зміна handSize дозволяє налаштувати ймовірність зіткнень між різними потоками та загальний паралелізм, доступний одному потоку в ситуації перевантаження.
Примітка:
Більше значення handSize зменшує ймовірність зіткнення двох окремих потоків (а отже, того, що один позбавить ресурсів інший), але збільшує ймовірність того, що невелика кількість потоків домінуватиме в apiserver. Більше значення handSize також потенційно збільшує затримку, яку може спричинити один потік із високим трафіком. Максимальна кількість запитів у черзі від одного потоку становить handSize * queueLengthLimit.
Нижче наведено таблицю з цікавим набором конфігурацій shuffle sharding, яка для кожної показує ймовірність того, що певну мишу (потік низької інтенсивності) розчавлять слони (потоки високої інтенсивності) для ілюстративного набору кількостей слонів. Цю таблицю обчислює https://play.golang.org/p/Gi0PLgVHiUg.
https://play.golang.org/p/Gi0PLgVHiUg, який обчислює цю таблицю.
Приклади конфігурацій shuffle sharding
HandSize
Черги
1 слон
4 слони
16 слонів
12
32
4.428838398950118e-09
0.11431348830099144
0.9935089607656024
10
32
1.550093439632541e-08
0.0626479840223545
0.9753101519027554
10
64
6.601827268370426e-12
0.00045571320990370776
0.49999929150089345
9
64
3.6310049976037345e-11
0.00045501212304112273
0.4282314876454858
8
64
2.25929199850899e-10
0.0004886697053040446
0.35935114681123076
8
128
6.994461389026097e-13
3.4055790161620863e-06
0.02746173137155063
7
128
1.0579122850901972e-11
6.960839379258192e-06
0.02406157386340147
7
256
7.597695465552631e-14
6.728547142019406e-08
0.0006709661542533682
6
256
2.7134626662687968e-12
2.9516464018476436e-07
0.0008895654642000348
6
512
4.116062922897309e-14
4.982983350480894e-09
2.26025764343413e-05
6
1024
6.337324016514285e-16
8.09060164312957e-11
4.517408062903668e-07
FlowSchema
FlowSchema зіставляє деякі вхідні запити й призначає їх рівню пріоритету. Кожен вхідний запит перевіряється за FlowSchemas, починаючи з тих, що мають найменше числове значення matchingPrecedence, і далі за зростанням. Перший збіг виграє.
Увага:
Для запиту має значення лише перша відповідна FlowSchema. Якщо одному вхідному запиту відповідає кілька FlowSchemas, його буде призначено на основі тієї, що має найвищий matchingPrecedence. Якщо одному запиту відповідає кілька FlowSchemas з однаковим matchingPrecedence, виграє та, що має лексикографічно менший name, але краще не покладатися на це, а подбати про те, щоб жодні дві FlowSchemas не мали однакового matchingPrecedence.
FlowSchema відповідає запиту, якщо відповідає принаймні одне з її rules. Правило відповідає, якщо запиту відповідають принаймні один з його subjectsта принаймні одне з його resourceRules або nonResourceRules (залежно від того, чи вхідний запит стосується ресурсу, чи нересурсного URL).
Для поля name у субʼєктах і полів verbs, apiGroups, resources, namespaces та nonResourceURLs ресурсних і нересурсних правил можна вказати шаблон *, щоб відповідати всім значенням цього поля, фактично прибираючи його з розгляду.
Поле distinguisherMethod.type у FlowSchema визначає, як запити, що відповідають цій схемі, розділятимуться на потоки. Це може бути ByUser, за якого один користувач не зможе позбавити інших користувачів місткості; ByNamespace, за якого запити до ресурсів в одному просторі імен не зможуть позбавити місткості запити до ресурсів в інших просторах імен; або порожнє значення (або distinguisherMethod можна взагалі пропустити), за якого всі запити, що відповідають цій FlowSchema, вважаються частиною одного потоку. Правильний вибір для FlowSchema залежить від ресурсу та вашого конкретного середовища.
Стандартні налаштування
Кожен kube-apiserver підтримує два різновиди обʼєктів конфігурації APF: обовʼязкові та рекомендовані.
Обовʼязкові обʼєкти конфігурації
Чотири обовʼязкові обʼєкти конфігурації відображають фіксовану вбудовану запобіжну поведінку. Це поведінка, яку сервери мають ще до появи цих обʼєктів, а коли ці обʼєкти існують, їх специфікації відображають цю поведінку. Ось ці чотири обовʼязкові обʼєкти.
Обовʼязковий рівень пріоритету exempt використовується для запитів, які взагалі не підлягають керуванню потоком: вони завжди запускаються негайно. Обовʼязкова FlowSchema exempt відносить усі запити з групи system:masters до цього рівня пріоритету. За потреби ви можете визначити інші FlowSchemas, які спрямовують інші запити на цей рівень пріоритету.
Обовʼязковий рівень пріоритету catch-all використовується разом з обовʼязковою FlowSchema catch-all, щоб кожен запит отримав певну класифікацію. Зазвичай не варто покладатися на цю конфігурацію catch-all; натомість за потреби створіть власні FlowSchema і PriorityLevelConfiguration типу catch-all (або використовуйте рекомендований рівень пріоритету global-default, який встановлюється стандартно). Оскільки звичайно він не має використовуватися, обовʼязковий рівень пріоритету catch-all має дуже малу частку паралелізму й не ставить запити в чергу.
Рекомендовані обʼєкти конфігурації
Рекомендовані FlowSchemas і PriorityLevelConfigurations становлять розумну стандартну конфігурацію. За бажання ви можете змінювати їх та/або створювати додаткові обʼєкти конфігурації. Якщо ваш кластер може зазнавати високого навантаження, варто подумати, яка конфігурація працюватиме найкраще.
Рекомендована конфігурація групує запити в шість рівнів пріоритету:
Рівень пріоритету node-high призначений для оновлень справності від вузлів.
Рівень пріоритету system призначений для запитів, не повʼязаних зі справністю, з групи system:nodes, тобто від kubelet, які мають зʼєднуватися з API-сервером, щоб на вузлах можна було планувати робочі навантаження.
Рівень пріоритету leader-election призначений для запитів виборів лідера від вбудованих контролерів (зокрема, запитів до endpoints, configmaps або leases, що надходять від користувачів system:kube-controller-manager чи system:kube-scheduler і ServiceAccount у просторі імен kube-system). Ці запити важливо ізолювати від іншого трафіку, оскільки збої у виборах лідера спричиняють збої та перезапуски відповідних контролерів, а це, у свою чергу, створює дорожчий трафік, коли нові контролери синхронізують свої інформери.
Рівень пріоритету workload-high призначений для інших запитів від вбудованих контролерів.
Рівень пріоритету workload-low призначений для запитів від будь-якого іншого ServiceAccount, що зазвичай охоплює всі запити від контролерів, які працюють у Podʼах.
Рівень пріоритету global-default обробляє весь інший трафік, наприклад, інтерактивні команди kubectl, запущені непривілейованими користувачами.
Рекомендовані FlowSchemas спрямовують запити на наведені вище рівні пріоритету, і тут вони не перелічені.
Підтримка обовʼязкових і рекомендованих обʼєктів конфігурації
Кожен kube-apiserver незалежно підтримує обовʼязкові та рекомендовані обʼєкти конфігурації, виконуючи початкову й періодичну обробку. Тому в ситуації із сумішшю серверів різних версій можливе постійне перезаписування (thrashing), доки різні сервери мають різні уявлення про правильний вміст цих обʼєктів.
Кожен kube-apiserver виконує початковий прохід підтримки обовʼязкових і рекомендованих обʼєктів конфігурації, а потім періодично (раз на хвилину) підтримує ці обʼєкти.
Для обовʼязкових обʼєктів конфігурації підтримка полягає в тому, щоб обʼєкт існував і, якщо існує, мав правильну специфікацію. Сервер не дозволяє створення чи оновлення зі специфікацією, яка не узгоджується із запобіжною поведінкою сервера.
Підтримка рекомендованих обʼєктів конфігурації розрахована на те, що їх специфікації можна перевизначати. Видалення, натомість, не враховується: підтримка відновить обʼєкт. Якщо рекомендований обʼєкт конфігурації вам не потрібен, його слід залишити, але задати специфікацію з мінімальними наслідками. Підтримка рекомендованих обʼєктів також розрахована на автоматичну міграцію під час розгортання нової версії kube-apiserver, хоча, можливо, з постійним перезаписуванням, доки працюють сервери різних версій.
Підтримка рекомендованого обʼєкта конфігурації полягає в його створенні зі специфікацією, рекомендованою сервером, якщо обʼєкт не існує. Якщо ж обʼєкт уже існує, поведінка підтримки залежить від того, хто контролює обʼєкт: kube-apiservers чи користувачі. У першому випадку сервер стежить, щоб специфікація обʼєкта відповідала рекомендованій сервером; у другому специфікація залишається без змін.
Щоб зʼясувати, хто контролює обʼєкт, спочатку шукається анотація з ключем apf.kubernetes.io/autoupdate-spec. Якщо така анотація є і її значення true, обʼєкт контролюють kube-apiservers. Якщо така анотація є і її значення false, обʼєкт контролюють користувачі. Якщо жодна з цих умов не виконується, перевіряється metadata.generation обʼєкта. Якщо воно дорівнює 1, обʼєкт контролюють kube-apiservers. Інакше обʼєкт контролюють користувачі. Ці правила запроваджено у випуску 1.22, а врахування metadata.generation потрібне для міграції з простішої попередньої поведінки. Користувачі, які хочуть контролювати рекомендований обʼєкт конфігурації, мають встановити його анотацію apf.kubernetes.io/autoupdate-spec у false.
Підтримка обовʼязкового або рекомендованого обʼєкта конфігурації також включає забезпечення наявності анотації apf.kubernetes.io/autoupdate-spec, яка точно відображає, чи контролюють обʼєкт kube-apiservers.
Підтримка також включає видалення обʼєктів, які не є ні обовʼязковими, ні рекомендованими, але мають анотацію apf.kubernetes.io/autoupdate-spec=true.
Звільнення перевірок справності від обмежень паралелізму
Рекомендована конфігурація не передбачає особливої обробки запитів перевірки справності до kube-apiservers від їхніх локальних kubelet, які зазвичай використовують захищений порт, але не надають облікових даних. За рекомендованої конфігурації ці запити призначаються FlowSchema global-default і відповідному рівню пріоритету global-default, де інший трафік може їх витіснити.
Якщо ви додасте наведену нижче додаткову FlowSchema, ці запити буде звільнено від обмеження частоти.
Увага:
Ця зміна також дозволяє будь-якому зловмиснику надсилати запити перевірки справності, що відповідають цій FlowSchema, у будь-якому обсязі. Якщо у вас є фільтр вебтрафіку або подібний зовнішній механізм безпеки для захисту API-сервера кластера від загального інтернет-трафіку, ви можете налаштувати правила блокування запитів перевірки справності, що надходять ззовні кластера.
У версіях Kubernetes до v1.20 мітки flow_schema та priority_level мали неузгоджені назви flowSchema та priorityLevel відповідно. Якщо ви використовуєте Kubernetes v1.19 або раніші версії, дивіться документацію для вашої версії.
Коли ви вмикаєте можливість API Priority and Fairness, kube-apiserver експортує додаткові метрики. Їх моніторинг допоможе визначити, чи не обмежує ваша конфігурація неналежним чином важливий трафік, або знайти робочі навантаження, які погано поводяться й можуть шкодити справності системи.
Рівень зрілості BETA
apiserver_flowcontrol_rejected_requests_total — це вектор лічильників (накопичувальний від запуску сервера) відхилених запитів із розбивкою за мітками flow_schema (вказує FlowSchema, що відповідала запиту), priority_level (вказує рівень, якому призначено запит) і reason. Мітка reason має одне з таких значень:
queue-full — у черзі вже забагато запитів.
concurrency-limit — PriorityLevelConfiguration налаштовано відхиляти зайві запити, а не ставити їх у чергу.
time-out — запит усе ще був у черзі, коли сплив граничний час перебування в черзі.
cancelled — запит не заблоковано від очищення (purge locked), і його вилучено з черги.
apiserver_flowcontrol_dispatched_requests_total — це вектор лічильників (накопичувальний від запуску сервера) запитів, які почали виконуватися, з розбивкою за flow_schema та priority_level.
apiserver_flowcontrol_current_inqueue_requests — це вектор gauge із миттєвою кількістю запитів у черзі (що не виконуються) з розбивкою за priority_level та flow_schema.
apiserver_flowcontrol_current_executing_requests — це вектор gauge із миттєвою кількістю виконуваних запитів (що не чекають у черзі) з розбивкою за priority_level та flow_schema.
apiserver_flowcontrol_current_executing_seats — це вектор gauge із миттєвою кількістю зайнятих місць з розбивкою за priority_level та flow_schema.
apiserver_flowcontrol_request_wait_duration_seconds — це вектор гістограм часу перебування запитів у черзі з розбивкою за мітками flow_schema, priority_level та execute. Мітка execute вказує, чи почалося виконання запиту.
Примітка:
Оскільки кожна FlowSchema завжди призначає запити одній PriorityLevelConfiguration, ви можете додати гістограми всіх FlowSchemas одного рівня пріоритету, щоб отримати ефективну гістограму для запитів, призначених цьому рівню пріоритету.
apiserver_flowcontrol_nominal_limit_seats — це вектор gauge із номінальним обмеженням паралелізму кожного рівня пріоритету, обчисленим із загального обмеження паралелізму API-сервера та налаштованих номінальних часток паралелізму рівня пріоритету.
Рівень зрілості ALPHA
apiserver_current_inqueue_requests — це вектор gauge нещодавніх пікових значень кількості запитів у черзі, згрупованих за міткою request_kind, значення якої — mutating або readOnly. Ці пікові значення описують найбільше число, зафіксоване в щойно завершеному односекундному вікні. Вони доповнюють старіший вектор gauge apiserver_current_inflight_requests, який містить пікове значення кількості запитів, що активно обслуговуються, за останнє вікно.
apiserver_current_inqueue_seats — це вектор gauge із сумою за запитами в черзі найбільшої кількості місць, яку займе кожен із них, згрупованою за мітками flow_schema та priority_level.
apiserver_flowcontrol_read_vs_write_current_requests — це вектор гістограм спостережень, зроблених наприкінці кожної наносекунди, кількості запитів із розбивкою за мітками phase (значення waiting та executing) та request_kind (значення mutating та readOnly). Кожне спостережуване значення — це відношення (від 0 до 1) кількості запитів до відповідного обмеження кількості запитів (обмеження обсягу черги для очікування та обмеження паралелізму для виконання).
apiserver_flowcontrol_request_concurrency_in_use — це вектор gauge із миттєвою кількістю зайнятих місць з розбивкою за priority_level та flow_schema.
apiserver_flowcontrol_priority_level_request_utilization — це вектор гістограм спостережень, зроблених наприкінці кожної наносекунди, кількості запитів із розбивкою за мітками phase (значення waiting та executing) та priority_level. Кожне спостережуване значення — це відношення (від 0 до 1) кількості запитів до відповідного обмеження кількості запитів (обмеження обсягу черги для очікування та обмеження паралелізму для виконання).
apiserver_flowcontrol_priority_level_seat_utilization — це вектор гістограм спостережень, зроблених наприкінці кожної наносекунди, використання обмеження паралелізму рівня пріоритету з розбивкою за priority_level. Це використання — частка (кількість зайнятих місць) / (обмеження паралелізму). Ця метрика враховує всі етапи виконання (як звичайний, так і додаткову затримку наприкінці запису для відповідної роботи зі сповіщеннями) усіх запитів, крім WATCH; для них вона враховує лише початковий етап, на якому доставляються сповіщення про наявні обʼєкти. Кожна гістограма у векторі також має мітку phase: executing (для фази очікування обмеження місць немає).
apiserver_flowcontrol_request_queue_length_after_enqueue — це вектор гістограм довжини черг із розбивкою за priority_level та flow_schema, вибірку для якого становлять запити, поставлені в чергу. Кожен запит, що потрапляє в чергу, додає до своєї гістограми один зразок — довжину черги одразу після додавання запиту. Зверніть увагу, що це дає іншу статистику, ніж неупереджене опитування.
Примітка:
Викид у гістограмі тут означає, що, ймовірно, один потік (тобто запити одного користувача або для одного простору імен, залежно від конфігурації) завалює API-сервер запитами й зазнає тротлінгу. Якщо ж гістограма одного рівня пріоритету показує, що всі черги цього рівня довші, ніж на інших рівнях, може бути доцільно збільшити частки паралелізму цієї PriorityLevelConfiguration.
apiserver_flowcontrol_request_concurrency_limit — те саме, що й apiserver_flowcontrol_nominal_limit_seats. До запровадження позичання паралелізму між рівнями пріоритету ця метрика завжди дорівнювала apiserver_flowcontrol_current_limit_seats (якої не існувало як окремої метрики).
apiserver_flowcontrol_lower_limit_seats — це вектор gauge із нижньою межею динамічного обмеження паралелізму кожного рівня пріоритету.
apiserver_flowcontrol_upper_limit_seats — це вектор gauge із верхньою межею динамічного обмеження паралелізму кожного рівня пріоритету.
apiserver_flowcontrol_demand_seats — це вектор гістограм, що підраховує спостереження наприкінці кожної наносекунди відношення (попит на місця) / (номінальне обмеження паралелізму) для кожного рівня пріоритету. Попит на місця рівня пріоритету — це сума за запитами в черзі та запитами в початковій фазі виконання максимальної кількості місць, зайнятих у початковій і кінцевій фазах виконання запиту.
apiserver_flowcontrol_demand_seats_high_watermark — це вектор gauge із максимальним попитом на місця для кожного рівня пріоритету за останній період коригування позичання паралелізму.
apiserver_flowcontrol_demand_seats_average — це вектор gauge із середнім за часом попитом на місця для кожного рівня пріоритету за останній період коригування позичання паралелізму.
apiserver_flowcontrol_demand_seats_stdev — це вектор gauge зі зваженим за часом стандартним відхиленням генеральної сукупності попиту на місця для кожного рівня пріоритету за останній період коригування позичання паралелізму.
apiserver_flowcontrol_demand_seats_smoothed — це вектор gauge зі згладженим обвідним попитом на місця для кожного рівня пріоритету, визначеним під час останнього коригування паралелізму.
apiserver_flowcontrol_target_seats — це вектор gauge із цільовим значенням паралелізму для кожного рівня пріоритету, яке використовується в задачі розподілу позичання.
apiserver_flowcontrol_seat_fair_frac — це gauge із часткою справедливого розподілу, визначеною під час останнього коригування позичання.
apiserver_flowcontrol_current_limit_seats — це вектор gauge із динамічним обмеженням паралелізму для кожного рівня пріоритету, визначеним під час останнього коригування.
apiserver_flowcontrol_request_execution_seconds — це вектор гістограм фактичного часу виконання запитів з розбивкою за flow_schema та priority_level.
apiserver_flowcontrol_watch_count_samples — це вектор гістограм кількості активних запитів WATCH, що стосуються певного запису, з розбивкою за flow_schema та priority_level.
apiserver_flowcontrol_work_estimated_seats — це вектор гістограм оціненої кількості місць (максимум для початкової та кінцевої стадій виконання), повʼязаних із запитами, з розбивкою за flow_schema та priority_level.
apiserver_flowcontrol_request_dispatch_no_accommodation_total — це вектор лічильників кількості подій, які в принципі могли привести до запуску запиту, але не привели через брак доступного паралелізму, з розбивкою за flow_schema та priority_level.
apiserver_flowcontrol_epoch_advance_total — це вектор лічильників кількості спроб перевести лічильник прогресу рівня пріоритету назад, щоб уникнути числового переповнення, згрупований за priority_level та success.
Рекомендації щодо використання API Priority and Fairness
Коли певний рівень пріоритету перевищує дозволений паралелізм, запити можуть зазнавати більшої затримки або відкидатися з помилкою HTTP 429 (Too Many Requests). Щоб запобігти цим побічним ефектам APF, ви можете змінити робоче навантаження або скоригувати налаштування APF так, щоб місць для обслуговування ваших запитів було достатньо.
Щоб виявити, чи відкидаються запити через APF, перевірте такі метрики:
apiserver_flowcontrol_rejected_requests_total — загальна кількість відхилених запитів за FlowSchema та PriorityLevelConfiguration.
apiserver_flowcontrol_current_inqueue_requests — поточна кількість запитів у черзі за FlowSchema та PriorityLevelConfiguration.
apiserver_flowcontrol_request_wait_duration_seconds — затримка, додана до запитів, що очікують у черзі.
apiserver_flowcontrol_priority_level_seat_utilization — використання місць за PriorityLevelConfiguration.
Зміни робочого навантаження
Щоб запити не ставилися в чергу, не отримували додаткової затримки й не відкидалися через APF, ви можете оптимізувати їх так:
Зменшуйте швидкість виконання запитів. Менша кількість запитів за фіксований період означає, що в певний момент часу потрібно менше місць.
Уникайте одночасного надсилання великої кількості дорогих запитів. Запити можна оптимізувати так, щоб вони використовували менше місць або мали меншу затримку й утримували ці місця коротше. Запити list можуть займати більше 1 місця залежно від кількості обʼєктів, отриманих під час запиту. Обмеження кількості обʼєктів, що повертаються в запиті list, наприклад за допомогою поділу на сторінки (pagination), використовуватиме менше місць загалом за коротший період. Крім того, заміна запитів list запитами watch потребуватиме менших загальних часток паралелізму, оскільки запити watch займають лише 1 місце під час початкового сплеску сповіщень. Якщо використовуються потокові списки у версіях 1.27 і новіших, запити watch займатимуть під час початкового сплеску сповіщень стільки ж місць, скільки запит list, оскільки потрібно передати весь стан колекції. Зверніть увагу, що в обох випадках запит watch не утримує місць після цієї початкової фази.
Памʼятайте, що чергування чи відхилення запитів через APF може спричинити як збільшення кількості запитів, так і збільшення затримки наявних запитів. Наприклад, якщо запити, які зазвичай виконуються за 1 с, починають виконуватися за 60 с, APF може почати відхиляти запити, оскільки через цю затримку вони займають місця довше, ніж зазвичай. Якщо APF починає відхиляти запити на кількох рівнях пріоритету без значної зміни робочого навантаження, можливо, проблема в продуктивності панелі управління, а не в робочому навантаженні чи налаштуваннях APF.
Налаштування Priority and Fairness
Ви також можете змінити стандартні обʼєкти FlowSchema та PriorityLevelConfiguration або створити нові обʼєкти цих видів, щоб краще пристосувати їх до вашого робочого навантаження.
Налаштування APF можна змінити, щоб:
Надати більше місць запитам високого пріоритету.
Ізолювати необовʼязкові або дорогі запити, які вичерпали б рівень паралелізму, якби він був спільним з іншими потоками.
Надайте більше місць запитам високого пріоритету
За можливості кількість місць, доступних на всіх рівнях пріоритету конкретного kube-apiserver, можна збільшити, збільшивши значення прапорців max-requests-inflight та max-mutating-requests-inflight. Іншим варіантом є горизонтальне масштабування кількості екземплярів kube-apiserver, що збільшить загальний паралелізм на рівень пріоритету в усьому кластері за умови достатнього балансування навантаження запитів.
Ви можете створити нову FlowSchema, яка посилається на PriorityLevelConfiguration з більшим рівнем паралелізму. Ця PriorityLevelConfiguration може бути наявним або новим рівнем із власним набором номінальних часток паралелізму. Наприклад, можна додати нову FlowSchema, щоб змінити PriorityLevelConfiguration для ваших запитів із global-default на workload-low і збільшити кількість місць, доступних вашому користувачу. Створення нової PriorityLevelConfiguration зменшить кількість місць, призначених наявним рівням. Нагадаємо, що редагування стандартної FlowSchema або PriorityLevelConfiguration потребує встановлення анотації apf.kubernetes.io/autoupdate-spec у false.
Ви також можете збільшити NominalConcurrencyShares для PriorityLevelConfiguration, яка обслуговує ваші запити високого пріоритету. Або, для версій 1.26 і новіших, можна збільшити LendablePercent для конкурентних рівнів пріоритету, щоб цей рівень пріоритету мав більший пул місць, які він може позичати.
Ізолюйте необовʼязкові запити, щоб вони не позбавляли ресурсів інші потоки
Для ізоляції запитів ви можете створити FlowSchema, субʼєкт якої відповідає користувачу, що надсилає ці запити, або FlowSchema, що відповідає змісту запиту (відповідно до resourceRules). Далі цю FlowSchema можна зіставити з PriorityLevelConfiguration з малою часткою місць.
Наприклад, припустімо, що запити list для подій від Podʼів у просторі імен default використовують по 10 місць кожен і виконуються протягом 1 хвилини. Щоб ці дорогі запити не впливали на запити інших Podʼів, які використовують наявну FlowSchema service-accounts, можна застосувати наведену нижче FlowSchema, щоб ізолювати ці виклики list від інших запитів.
Приклад обʼєкта FlowSchema для ізоляції запитів list для подій:
Ця FlowSchema охоплює всі виклики list для подій, виконані стандартним ServiceAccount у просторі імен default. Пріоритет відповідності 8000 менший за значення 9000, яке використовує наявна FlowSchema service-accounts, тому ці виклики list для подій відповідатимуть list-events-default-service-account, а не service-accounts.
Для ізоляції цих запитів використовується PriorityLevelConfiguration catch-all. Рівень пріоритету catch-all має дуже малу частку паралелізму й не ставить запити в чергу.
Ви можете надсилати пропозиції та запити щодо можливостей через SIG API Machinery або канал у Slack, присвячений цій можливості.
16 - Встановлення надбудов
Примітка: Цей розділ містить посилання на проєкти сторонніх розробників, які надають функціонал, необхідний для Kubernetes. Автори проєкту Kubernetes не несуть відповідальності за ці проєкти. Проєкти вказано в алфавітному порядку. Щоб додати проєкт до цього списку, ознайомтеся з посібником з контенту перед надсиланням змін. Докладніше.
Надбудови розширюють функціональність Kubernetes.
На цій сторінці перелічено деякі доступні надбудови з посиланнями на відповідні інструкції зі встановлення. Список не претендує на вичерпність.
Мережа та мережеві політики
ACI забезпечує інтегровану мережу контейнерів і мережеву безпеку з Cisco ACI.
Antrea працює на рівнях 3/4, щоб надавати мережеві сервіси та сервіси безпеки для Kubernetes, використовуючи Open vSwitch як мережеву площину даних. Antrea — це проєкт CNCF рівня Sandbox.
Calico — це провайдер мережі та мережевих політик. Calico підтримує гнучкий набір мережевих параметрів, тож ви можете вибрати найефективніший варіант для своєї ситуації, зокрема мережі без оверлею та оверлейні мережі, з BGP або без нього. Calico використовує той самий рушій для застосування мережевих політик до хостів, Podʼів і (якщо використовуються Istio та Envoy) застосунків на рівні service mesh.
Canal обʼєднує Flannel і Calico, забезпечуючи мережу та мережеві політики.
Cilium — це рішення для мережі, спостережуваності та безпеки з площиною даних на основі eBPF. Cilium надає просту пласку мережу рівня 3 з можливістю охоплення кількох кластерів у режимі нативної маршрутизації або в режимі оверлею/інкапсуляції та може застосовувати мережеві політики на рівнях L3-L7 за допомогою моделі безпеки на основі ідентичності, відокремленої від мережевої адресації. Cilium може замінити kube-proxy; він також пропонує додаткові можливості спостережуваності й безпеки, які вмикаються за бажанням. Cilium — це проєкт CNCF рівня Graduated.
CNI-Genie дозволяє Kubernetes безшовно підʼєднуватися до вибраних втулків CNI, таких як Calico, Canal, Flannel або Weave. CNI-Genie — це проєкт CNCF рівня Sandbox.
Contiv надає налаштовувану мережу (нативний L3 із BGP, оверлей із vxlan, класичний L2 і Cisco-SDN/ACI) для різних випадків використання та багатий фреймворк політик. Проєкт Contiv має повністю відкритий код. Інсталятор пропонує варіанти встановлення як на основі kubeadm, так і без нього.
Contrail, заснований на Tungsten Fabric, — це платформа з відкритим кодом для віртуалізації багатохмарних мереж і керування політиками. Contrail і Tungsten Fabric інтегровані із системами оркестрування, такими як Kubernetes, OpenShift, OpenStack і Mesos, і надають режими ізоляції для віртуальних машин, контейнерів/Podʼів і робочих навантажень на фізичному обладнанні.
Flannel — це провайдер оверлейної мережі, який можна використовувати з Kubernetes.
Gateway API — це проєкт із відкритим кодом, яким керує спільнота SIG Network, що надає виразний, розширюваний і орієнтований на ролі API для моделювання мережевої взаємодії сервісів.
Knitter — це втулок для підтримки кількох мережевих інтерфейсів у Podʼі Kubernetes.
kube-router — це готове рішення з відкритим кодом для мережі Kubernetes, метою якого є простота експлуатації та висока продуктивність. Воно використовує API Kubernetes, BGP і Golang для шляху керування та мережеві примітиви Linux (IPVS, nftables тощо) для шляху даних. Це альтернатива з низькими накладними витратами, яка використовується в k0s і k3s.
Multus — це мультивтулок для підтримки кількох мереж у Kubernetes, який підтримує всі втулки CNI (наприклад, Calico, Cilium, Contiv, Flannel), а також робочі навантаження на основі SRIOV, DPDK, OVS-DPDK і VPP у Kubernetes.
OVN-Kubernetes — це провайдер мережі для Kubernetes на основі OVN (Open Virtual Network), реалізації віртуальної мережі, що вийшла з проєкту Open vSwitch (OVS). OVN-Kubernetes надає реалізацію мережі на основі оверлею для Kubernetes, зокрема реалізацію балансування навантаження та мережевих політик на основі OVS.
Nodus — це втулок контролера CNI на основі OVN для забезпечення ланцюжків сервісних функцій (Service Function Chaining, SFC) у стилі cloud native.
NSX-T Container Plug-in (NCP) забезпечує інтеграцію між VMware NSX-T та оркестраторами контейнерів, такими як Kubernetes, а також інтеграцію між NSX-T та контейнерними платформами CaaS/PaaS, такими як Pivotal Container Service (PKS) та OpenShift.
Nuage — це платформа SDN, яка забезпечує мережу на основі політик між Podʼами Kubernetes і середовищами поза Kubernetes із моніторингом видимості та безпеки.
Romana — це мережеве рішення рівня 3 для мереж Podʼів, яке також підтримує API NetworkPolicy.
Spiderpool — це мережеве рішення базової мережі (underlay) та RDMA для Kubernetes. Spiderpool підтримується на фізичному обладнанні, віртуальних машинах і в публічних хмарних середовищах.
Terway — це набір втулків CNI на основі мережевих продуктів VPC та ECS від AlibabaCloud. Він забезпечує нативну мережу VPC і мережеві політики в середовищах AlibabaCloud.
Weave Net забезпечує мережу та мережеві політики, продовжує працювати з обох боків розділення мережі й не потребує зовнішньої бази даних.
Виявлення сервісів
CoreDNS — це гнучкий, розширюваний DNS-сервер, який можна встановити як внутрішньокластерний DNS для Podʼів.
Візуалізація та керування
Dashboard — це вебінтерфейс dashboard для Kubernetes.
Headlamp — це розширюваний інтерфейс користувача Kubernetes, який можна розгорнути в кластері або використовувати як настільний застосунок.
Інфраструктура
KubeVirt — це надбудова для запуску віртуальних машин у Kubernetes. Зазвичай працює в кластерах на фізичному обладнанні.
Кілька інших надбудов задокументовано в застарілій теці cluster/addons.
Надбудови, що добре підтримуються, мають бути вказані тут. Чекаємо на ваші PR!
17 - Координовані вибори лідера
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.33; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the CoordinatedLeaderElection feature gate for all relevant components in your cluster.
Kubernetes 1.37 містить бета-можливість, яка дозволяє компонентам панелі управління детерміновано обирати лідера через координовані вибори лідера. Це корисно для дотримання обмежень версійної розбіжності Kubernetes під час оновлення кластера. Наразі єдиною вбудованою стратегією вибору є OldestEmulationVersion, яка надає перевагу лідеру з найнижчою версією емуляції, потім за бінарною версією, а потім за позначкою часу створення.
Увімкнення координованих виборів лідера
Переконайтеся, що під час запуску API-сервера ввімкнено функціональну можливість CoordinatedLeaderElection і що ввімкнено групу API coordination.k8s.io/v1beta1.
Це можна зробити, встановивши прапорці --feature-gates="CoordinatedLeaderElection=true" та --runtime-config="coordination.k8s.io/v1beta1=true".
Конфігурація компонентів
За умови, що ви ввімкнули функціональну можливість CoordinatedLeaderElectionта групу API coordination.k8s.io/v1beta1, сумісні компоненти панелі управління автоматично використовують API LeaseCandidate і Lease, щоб обирати лідера за потреби.
У Kubernetes 1.37 два компоненти панелі управління (kube-controller-manager і kube-scheduler) автоматично використовують координовані вибори лідера, коли ввімкнено функціональну можливість і групу API.
Вибір лідера для компонентів Kubernetes
Kubernetes використовує Lease API для виборів лідера серед кількох екземплярів одного компонента панелі управління в кластері високої доступності, таких як kube-controller-manager або kube-scheduler.
Lease діє як легке розподілене блокування, збережене API-сервером Kubernetes. Всі запущені екземпляри компонента спостерігають або періодично читають відповідний обʼєкт Lease, щоб визначити, який екземпляр наразі виконує роль лідера.
ідентичність поточного лідера (наприклад, назва Podʼа або рядок на основі імені хоста).
acquireTime
час, коли було отримано лідерство.
renewTime
час останнього оновлення лідером.
leaseDurationSeconds
період дії Lease (кандидати мають чекати цей час плюс невеликий запас часу, перш ніж намагатися отримати прострочений Lease).
leaseTransitions
лічильник того, скільки разів лідерство переходило до іншого екземпляра.
Ці поля показують, який екземпляр утримує лідерство та як довго це лідерство залишається дійсним.
Коли Lease не існує або його термін дії минув (поточний час > renewTime + leaseDurationSeconds), екземпляри-кандидати намагаються оновити Lease, записавши свою ідентичність. Kubernetes покладається на оптимістичне керування паралелізмом через resourceVersion обʼєкта: через невідповідність версій під час одночасних спроб успішним є лише одне оновлення. Екземпляр, чиє оновлення прийнято, стає лідером.
Kubernetes використовує API LeaseCandidate для керування виборами лідера. Компоненти панелі управління, такі як kube-controller-manager та kube-scheduler, реєструють свою роль кандидата, створюючи обʼєкти LeaseCandidate, які відстежують усі екземпляри, що змагаються за лідерство, і містять метадані, зокрема ідентичність кандидата, бінарну версію та версію емуляції.
Під час виборів кандидати координують свої дії через спільний Lease. Панель управління Kubernetes гарантує, що лише один кандидат успішно отримує Lease і стає лідером, а всі інші залишаються послідовниками. Якщо поточний лідер не оновлює Lease протягом вибраного часу очікування, інші кандидати змагаються за лідерство й обирають нового лідера.
Після обрання лідер періодично оновлює свій Lease, змінюючи поле renewTime (наприклад, виконуючи оновлення кожні leaseDurationSeconds ÷ 2, щоб уникнути конфліктів, коли термін дії Lease ось-ось закінчиться). Поки оновлення відбуваються до закінчення терміну дії Lease, поточний екземпляр-лідер зберігає лідерство. Якщо лідер аварійно завершує роботу, стає недоступним або припиняє оновлювати Lease, термін дії цього Lease минає. Інші справні екземпляри виявляють прострочений Lease і намагаються провести нові вибори.
Цей механізм гарантує, що хоча для стабільності та відновлення може працювати кілька реплік компонента, лише один екземпляр одночасно активно виконує завдання керування, а інші залишаються в режимі очікування, стежать за Lease і готові швидко перейняти роботу в разі потреби.