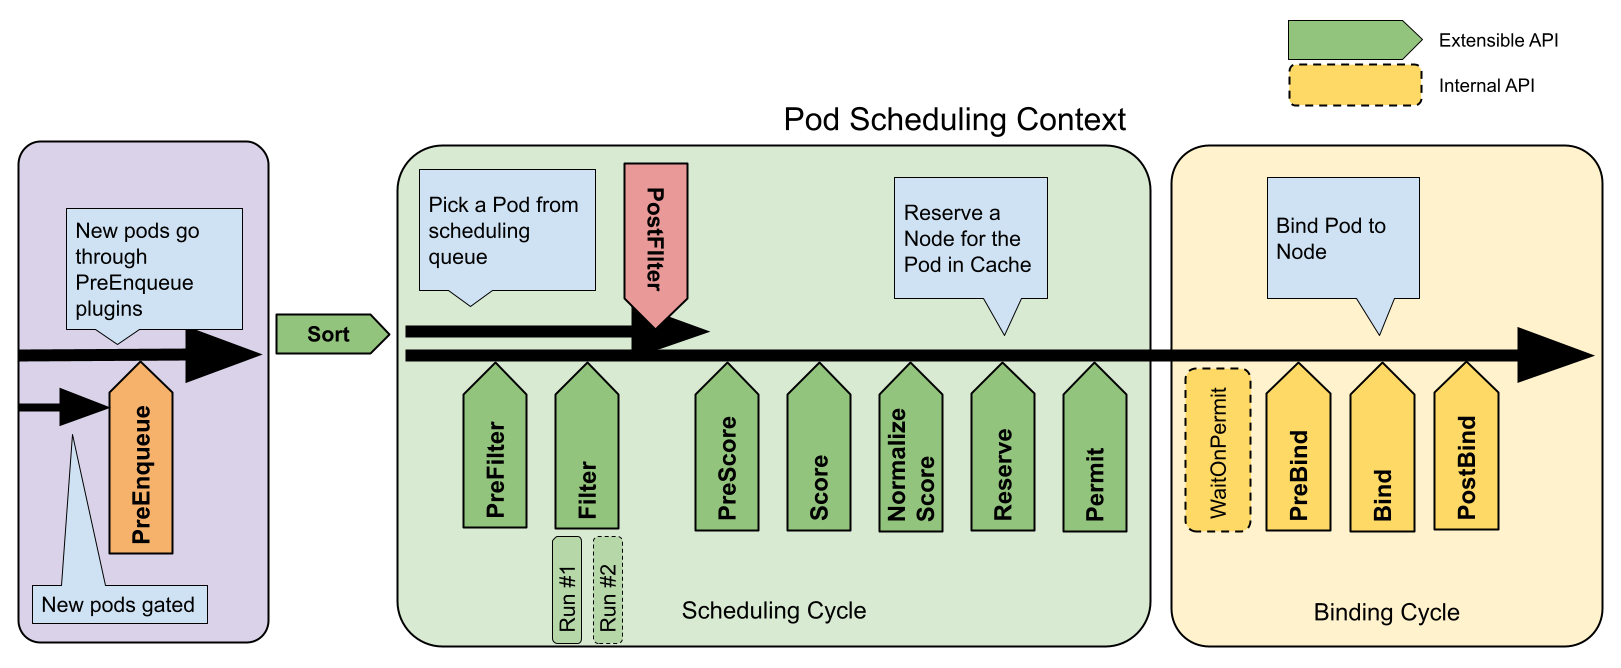
У Kubernetes планування означає забезпечення відповідності Podʼіввузлам, щоб kubelet міг їх запустити. Витіснення — це процес завершення роботи Podʼів з нижчим пріоритетом, щоб Podʼи з вищим пріоритетом могли плануватися на вузлах. Виселення — це процес завершення роботи одного або кількох Podʼів на вузлах.
Порушення роботи Podʼа — це процес, під час якого Podʼи на вузлах припиняють роботу добровільно або примусово.
Добровільне порушення навмисно запускають власники застосунків або адміністратори кластера. Невідворотне порушення є ненавмисним і може бути спричинене неминучими проблемами, такими як вичерпання ресурсів вузлів, або випадковим видаленням.
Kubernetes дозволяє запускати кілька планувальників в одному кластері.
Ця сторінка описує загальні принципи запуску кількох планувальників у кластері, припускаючи, що принаймні один із цих планувальників є стандартним kube-scheduler. Якщо ви запускаєте лише власні або сторонні планувальники, зверніться до їхньої документації.
Стратегії розгортання
Під час запуску кількох планувальників ви повинні вирішити, як вони взаємодіють один з одним та з вузлами кластера. Існує три поширені сценарії розгортання:
Висока доступність (репліки у стані очікування)
Якщо ви хочете запустити єдиний логічний планувальник (такий як kube-scheduler), але забезпечити його доступність у разі збою, ви повинні запустити кілька реплік планувальника та увімкнути вибір лідера (leader election).
Коли вибір лідера увімкнено, лише одна репліка (лідер) є активною та планує Podʼи, тоді як інші залишаються в режимі очікування. Якщо активний лідер зазнає збою, одна з реплік у стані очікування автоматично виграє вибори лідера та переймає роботу з планування.
Якщо ви хочете використовувати різні конфігурації або правила планування для різних робочих навантажень, ви можете налаштувати один екземпляр kube-scheduler з кількома профілями планування або запустити кілька окремих екземплярів kube-scheduler.
Кілька профілів в одному екземплярі: Один процес kube-scheduler може запускати кілька профілів (кожен з унікальною назвою планувальника). Оскільки ці профілі працюють в одному процесі та спільно використовують одну чергу планування та кеш, вони не приймають конфліктних рішень щодо планування. Ви все ще можете використовувати спорідненість вузлів, якщо хочете ізолювати робочі навантаження, спрямовуючи кожен профіль до певного пулу вузлів.
Кілька окремих екземплярів: Якщо ви запускаєте кілька окремих процесів kube-scheduler (розгортання), вони не координуються між собою і можуть приймати конфліктні рішення щодо планування (наприклад, виділяти ресурси вузла понад наявні). Щоб цього уникнути, кожен екземпляр планувальника має націлюватися на неперетинну множину вузлів за допомогою спорідненості вузлів.
Поєднання kube-scheduler з власними планувальниками
Якщо ви запускаєте kube-scheduler разом із власними або сторонніми планувальниками, запускайте їх на різних пулах вузлів, щоб уникнути конфліктів ресурсів. Залежно від того, як спроєктований ваш власний планувальник, він може підтримувати роботу в конфігурації active-active або вимагати власного механізму вибору лідера. Завжди перевіряйте документацію до вашого власного планувальника.
У Kubernetes планування означає забезпечення відповідності Podʼіввузлам, щоб Kubelet міг їх запустити.
Огляд планування
Планувальник відстежує новостворені Podʼи, які не мають призначеного вузла. Для кожного виявленого Podʼа планувальник стає відповідальним за пошук найкращого вузла для його запуску. Планувальник приймає рішення про розміщення Podʼа, враховуючи принципи планування, описані нижче.
Якщо ви хочете зрозуміти, чому Podʼи розміщуються на певному вузлі, або якщо ви плануєте реалізувати власний планувальник, ця сторінка допоможе вам дізнатися більше про планування.
kube-scheduler
kube-scheduler є стандартним планувальником для Kubernetes і працює як частина панелі управління. kube-scheduler розроблено так, що, якщо ви хочете і вам треба, ви можете написати власний компонент планування і використовувати його замість стандартного.
Kube-scheduler вибирає оптимальний вузол для запуску нових або ще не запланованих Podʼів. Оскільки контейнери в Podʼах, і самі Podʼи, можуть мати різні вимоги, планувальник відфільтровує будь-які вузли, які не відповідають конкретним потребам планування Podʼа. Крім того, через API можна вказати вузол для Podʼа під час його створення, але це робиться тільки у виняткових випадках.
У кластері вузли, які відповідають вимогам планування для Podʼа, називаються придатними (feasible) вузлами. Якщо жоден з вузлів не підходить, Pod залишається незапланованим до тих пір, поки планувальник не зможе розмістити його.
Планувальник знаходить придатні вузли для Podʼів, а потім виконує набір функцій для оцінки таких вузлів і вибирає вузол з найвищою оцінкою серед придатних для запуску Podʼа. Потім планувальник повідомляє API-сервер про це рішення в процесі, який називається привʼязкою (binding).
Фактори, які потрібно враховувати під час прийняття рішень про планування, включають індивідуальні та загальні вимоги до ресурсів, обмеження апаратного забезпечення, програмного забезпечення та політик, специфікації спорідненості та антиспорідненості, розташування даних, взаємовплив між робочими навантаженнями та інше.
Вибір вузла в kube-scheduler
kube-scheduler вибирає вузол для Podʼа в два етапи:
Фільтрація.
Оцінювання.
На етапі фільтрації визначається набір вузлів, на яких можна розмістити Pod. Наприклад, фільтр PodFitsResources перевіряє, чи має вузол-кандидат достатньо доступних ресурсів, щоб задовольнити конкретні запити Podʼа на ресурси. Після цього етапу список вузлів містить придатні вузли; часто їх буде більше одного. Якщо список порожній, цей Pod (поки що) неможливо запланувати.
На етапі оцінювання планувальник ранжує вузли, що залишилися, щоб вибрати найбільш придатне розміщення для Podʼа. Планувальник надає кожному вузлу, який залишився після фільтрації, оцінку, базуючись на активних правилах оцінки.
На останньому етапі kube-scheduler призначає Pod вузлу з найвищим рейтингом. Якщо є більше одного вузла з однаковими оцінками, kube-scheduler вибирає один з них випадковим чином.
Є два підтримуваних способи налаштування поведінки фільтрації та оцінювання планувальника:
Політики планування дозволяють налаштувати Предикати для фільтрації та Пріоритети для оцінювання.
Профілі планування дозволяють налаштувати втулки, які реалізують різні етапи планування, включаючи: QueueSort, Filter, Score, Bind, Reserve, Permit та інші. Ви також можете налаштувати kube-scheduler для запуску різних профілів.
Ви можете обмежити Pod так, щоб він міг запускатися лише на конкретних вузлах або віддавав перевагу запуску на певних вузлах. Є кілька способів зробити це, і всі рекомендовані підходи використовують селектори міток для полегшення вибору. Зазвичай вам не потрібно встановлювати жодні обмеження такого роду; планувальник автоматично робить розумне розміщення (наприклад, розподіл Podʼів по вузлах так, щоб не розміщувати Podʼи на вузлі з недостатньою кількістю вільних ресурсів). Однак є обставини, коли ви можете захотіти контролювати, на якому вузлі розгортається Pod, наприклад, щоб переконатися, що Pod потрапляє на вузол з прикріпленим до нього SSD, або щоб розмістити в одній зоні доступності Podʼи двох різних сервісів, які багато взаємодіють.
Ви можете використовувати будь-який з наступних методів для вибору місця, де Kubernetes планує конкретні Podʼи:
Значення цих міток залежить від хмарного провайдера, і їх надійність не гарантується. Наприклад, значення kubernetes.io/hostname може бути таким самим, як назва вузла, у деяких середовищах і відрізнятися в інших середовищах.
Ізоляція/обмеження вузлів
Додавання міток до вузлів дозволяє спрямовувати Podʼи на планування на конкретних вузлах або групах вузлів. Ви можете використовувати цю функціональність, щоб забезпечити, що певні Podʼи працюватимуть тільки на вузлах із певною ізоляцією, безпекою або регуляторними властивостями.
Якщо ви використовуєте мітки для ізоляції вузлів, обирайте ключі міток, які kubelet не може змінювати. Це заважає скомпрометованому вузлу встановлювати ці мітки на себе, щоб планувальник планував робочі навантаження на скомпрометований вузол.
Втулок допуску NodeRestriction перешкоджає kubelet встановлювати або змінювати мітки з префіксом node-restriction.kubernetes.io/.
Щоб скористатися цим префіксом міток для ізоляції вузлів:
Переконайтеся, що ви використовуєте авторизатор вузлів і увімкнули втулок допуску NodeRestriction.
Додайте мітки з префіксом node-restriction.kubernetes.io/ на ваші вузли, і використовуйте ці мітки у ваших селекторах вузлів. Наприклад, example.com.node-restriction.kubernetes.io/fips=true або example.com.node-restriction.kubernetes.io/pci-dss=true.
nodeSelector
nodeSelector є найпростішим рекомендованим способом обмеження вибору вузла. Ви можете додати поле nodeSelector до специфікації вашого Podʼа і вказати мітки вузла, які має мати цільовий вузол. Kubernetes розміщує Pod лише на тих вузлах, які мають всі мітки, які ви вказали.
nodeSelector є найпростішим способом обмежити Podʼи вузлами з певними мітками. Спорідненість та антиспорідненість розширюють типи обмежень, які ви можете визначити. Деякі з переваг спорідненості та антиспорідненості включають:
Мова (анти)спорідненості є більш виразною. nodeSelector вибирає лише вузли з усіма вказаними мітками. (Анти)спорідненість дає вам більший контроль над логікою вибору.
Ви можете вказати, що правило є soft або preferred, щоб планувальник все одно запланував Pod, навіть якщо не може знайти відповідний вузол.
Ви можете обмежити Pod, використовуючи мітки на інших Podʼах, які працюють на вузлі (або в іншому топологічному домені), а не лише мітки вузла, що дозволяє визначати правила для того, які Podʼи можуть бути розміщені разом на вузлі.
Можливість affinity складається з двох типів спорідненості:
Спорідненість вузла працює подібно до поля nodeSelector, але є виразнішою і дозволяє вказувати мʼякі правила.
(Анти)спорідненість між Podʼами дозволяє обмежувати Podʼи відносно міток інших Podʼів.
Спорідненість вузлів
Спорідненість вузлів концептуально подібна до nodeSelector і дозволяє вам обмежувати, на яких вузлах може бути запланований ваш Pod на основі міток вузла. Існують два типи спорідненості вузла:
requiredDuringSchedulingIgnoredDuringExecution: Планувальник не може запланувати Pod, якщо правило не виконується. Це працює подібно до nodeSelector, але з більш виразним синтаксисом.
preferredDuringSchedulingIgnoredDuringExecution: Планувальник намагається знайти вузол, який відповідає правилу. Якщо відповідний вузол недоступний, планувальник все одно планує Pod.
Примітка:
У попередніх типах IgnoredDuringExecution означає, що якщо мітки вузла змінюються після того, як Kubernetes запланував Pod, Pod продовжує працювати.
Ви можете вказати спорідненість вузлів, використовуючи поле .spec.affinity.nodeAffinity в специфікації вашого Podʼа.
Наприклад, розгляньте наступну специфікацію Podʼа:
Вузол повинен мати мітку з ключем topology.kubernetes.io/zone, а значення цієї мітки повинно бути або antarctica-east1, або antarctica-west1.
Вузол бажано має мітку з ключем another-node-label-key, а значення another-node-label-value.
Ви можете використовувати поле operator, щоб вказати логічний оператор, який Kubernetes буде використовувати під час інтерпретації правил. Ви можете використовувати In, NotIn, Exists, DoesNotExist, Gt і Lt.
Прочитайте розділ Оператори, щоб дізнатися більше про те, як вони працюють.
NotIn та DoesNotExist дозволяють визначати поведінку антиспорідненості. Як альтернативу ви можете використовувати taints вузлів для відштовхування Podʼів від конкретних вузлів.
Примітка:
Якщо ви вказуєте як nodeSelector, так і nodeAffinity, обидва вони повинні задовольнятися для того, щоб Pod був запланований на вузол.
Якщо ви вказуєте кілька умов в nodeSelectorTerms, повʼязаних з типами nodeAffinity, то Pod може бути запланований на вузол, якщо одна з вказаних умов може бути задоволеною (умови зʼєднуються логічним OR).
Якщо ви вказуєте кілька виразів в одному полі matchExpressions, повʼязаному з умовою в nodeSelectorTerms, то Pod може бути запланований на вузол лише в тому випадку, якщо всі вирази задовольняються (вирази зʼєднуються логічним AND).
Ви можете вказати weight (вагу) від 1 до 100 для кожного екземпляра спорідненості типу preferredDuringSchedulingIgnoredDuringExecution. Коли планувальник знаходить вузли, які відповідають усім іншим вимогам планування Podʼа, планувальник проходить по кожному правилу preferred, якому задовольняє вузол, і додає значення weight для цього виразу до суми.
Кінцева сума додається до оцінки інших функцій пріоритету для вузла. Вузли з найвищою загальною оцінкою отримують пріоритет, коли планувальник приймає рішення щодо планування Podʼа.
Наприклад, розгляньте наступну специфікацію Podʼа:
Якщо існують два можливих вузли, які відповідають правилу preferredDuringSchedulingIgnoredDuringExecution, один з міткою label-1:key-1, а інший з міткою label-2:key-2, планувальник бере до уваги weight кожного вузла і додає вагу до інших оцінок для цього вузла, і планує Pod на вузол з найвищою кінцевою оцінкою.
Примітка:
Якщо ви хочете, щоб Kubernetes успішно запланував Podʼи в цьому прикладі, вам потрібно мати наявні вузли з міткою kubernetes.io/os=linux.
Спорідненість вузлів для кожного профілю планування
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.20
Під час налаштування кількох профілів планування ви можете повʼязати профіль зі спорідненістю вузлів, що є корисним, якщо профіль застосовується лише до певного набору вузлів. Для цього додайте addedAffinity до поля args втулка NodeAffinity у конфігурації планувальника. Наприклад:
addedAffinity застосовується до всіх Podʼів, які встановлюють .spec.schedulerName в foo-scheduler, на додачу до NodeAffinity, вказаного в PodSpec. Тобто, щоб відповідати Podʼу, вузли мають задовольняти addedAffinity та .spec.NodeAffinity Podʼа.
Оскільки addedAffinity не є видимим для кінцевих користувачів, його поведінка може бути неочікуваною для них. Використовуйте мітки вузлів, які мають чіткий взаємозвʼязок із назвою профілю планувальника.
Примітка:
Контролер DaemonSet, який створює Podʼи для DaemonSet, не підтримує профілі планування. Коли контролер DaemonSet створює Podʼи, стандартний планувальник Kubernetes розміщує ці Podʼи та дотримується будь-яких правил nodeAffinity в контролері DaemonSet.
Спорідненість та антиспорідненість між Podʼами
Спорідненість та антиспорідненість між Podʼами дозволяють обмежити, на яких вузлах ваші Podʼи можуть бути заплановані на основі міток Podʼів, які вже працюють на цьому вузлі, а не міток вузлів.
Типи спорідненості та антиспорідненості між Podʼами
Спорідненість та антиспорідненість між Podʼами мають такий вигляд: «цей Pod повинен (або, у випадку антиспорідненості, не повинен) працювати у X, якщо на цьому X вже працюють один або кілька Podʼів, які задовольняють правило Y», де X є топологічним доменом, таким як вузол, стійка, зона або регіон хмарного провайдера чи щось подібне, а Y — це правило, яке Kubernetes намагається задовольнити.
Ви виражаєте ці правила (Y) як селектори міток з необовʼязковим повʼязаним списком просторів імен. Podʼи є обʼєктами з простором імен в Kubernetes, тому мітки Podʼів також неявно мають простори імен. Будь-які селектори міток для міток Podʼа повинні вказувати простори імен, в яких Kubernetes має переглядати ці мітки.
Ви виражаєте топологічний домен (X), використовуючи topologyKey, який є ключем для мітки вузла, яку система використовує для позначення домену. Для прикладу дивіться у Відомі мітки, анотації та taints.
Примітка:
Спорідненість та антиспорідненість між Podʼами потребують значних обсягів обчислень, що може значно сповільнити планування у великих кластерах. Ми не рекомендуємо використовувати їх у кластерах розміром понад кілька сотень вузлів.
Примітка:
Антиспорідненість Podʼа вимагає, щоб вузли мали узгоджені мітки, іншими словами, кожен вузол в кластері повинен мати відповідну мітку, яка відповідає topologyKey. Якщо деякі або всі вузли не мають вказаної мітки topologyKey, це може призвести до непередбачуваної поведінки.
Подібно до спорідненості вузлів, існують два типи спорідненості та антиспорідненості Podʼа:
requiredDuringSchedulingIgnoredDuringExecution
preferredDuringSchedulingIgnoredDuringExecution
Наприклад, ви можете використовувати спорідненість requiredDuringSchedulingIgnoredDuringExecution,
щоб повідомити планувальнику про те, що потрібно розмістити Podʼи двох сервісів в одній зоні хмарного провайдера, оскільки вони взаємодіють між собою дуже часто. Так само ви можете використовувати антиспорідненість
preferredDuringSchedulingIgnoredDuringExecution, щоб розподілити Podʼи сервісу по різних зонах хмарного провайдера.
Для використання спорідненості між Podʼами використовуйте поле affinity.podAffinity в специфікації Podʼа. Для антиспорідненості між Podʼами використовуйте поле affinity.podAntiAffinity в специфікації Podʼа.
Поведінка планування
Під час планування нового Podʼа планувальник Kubernetes оцінює правила спорідненості/антиспорідненості Podʼа в контексті поточного стану кластера:
Жорсткі обмеження (фільтрація вузлів):
podAffinity.requiredDuringSchedulingIgnoredDuringExecution та podAntiAffinity.requiredDuringSchedulingIgnoredDuringExecution:
Планувальник гарантує, що новий Pod буде призначено вузлам, які задовольняють ці обовʼязкові правила спорідненості та антиспорідненості, на основі наявних Podʼів.
Мʼякі обмеження (оцінювання):
podAffinity.preferredDuringSchedulingIgnoredDuringExecution та podAntiAffinity.preferredDuringSchedulingIgnoredDuringExecution:
Планувальник оцінює вузли на основі того, наскільки добре вони відповідають цим бажаним правилам спорідненості та антиспорідненості, щоб оптимізувати розміщення Podʼів.
Ігноровані поля:
Наявні в Podʼах podAffinity.preferredDuringSchedulingIgnoredDuringExecution:
Ці бажані правила спорідненості не враховуються під час прийняття рішення щодо планування нових Podʼів.
Наявні в Podʼах podAntiAffinity.preferredDuringSchedulingIgnoredDuringExecution:
Аналогічно, під час планування ігноруються бажані правила антиспорідненості наявних Podʼів.
Планування групи Podʼів зі спорідненістю між собою
Якщо поточний Pod, який планується, є першим у серії Podʼів, що мають спорідненість між собою, його можна планувати, якщо він проходить всі інші перевірки спорідненості. Це визначається тим, що не існує іншого Podʼа в кластері, який відповідає простору імен та селектору цього Podʼа, що Pod відповідає власним умовам і обраний вузол відповідає всім запитаним топологіям. Це забезпечує відсутність взаємного блокування навіть у випадку, якщо всі Podʼи мають вказану спорідненість між Podʼами.
У цьому прикладі визначено одне правило спорідненості Podʼа та одне правило антиспорідненості Podʼа. Правило спорідненості Podʼа використовує «hard» requiredDuringSchedulingIgnoredDuringExecution, тоді як правило антиспорідненості використовує «soft» preferredDuringSchedulingIgnoredDuringExecution.
Правило спорідненості вказує, що планувальник може розмістити Pod лише на вузлі, який належить до певної зони, де інші Podʼи мають мітку security=S1. Наприклад, якщо у нас є кластер із призначеною зоною, скажімо, «Zone V», що складається з вузлів з міткою topology.kubernetes.io/zone=V, планувальник може призначити Pod на будь-який вузол у Zone V, якщо принаймні один Pod у Zone V вже має мітку security=S1. І навпаки, якщо в Zone V немає Podʼів з мітками security=S1, планувальник не призначить Pod з прикладу ні на один вузол в цій зоні.
Правило антиспорідненості вказує, що планувальник повинен уникати призначення Podʼа на вузол, якщо цей вузол належить до певної зони, де інші Podʼи мають мітку security=S2. Наприклад, якщо у нас є кластер із призначеною зоною, скажімо, «Zone R», що складається з вузлів з міткою topology.kubernetes.io/zone=R, планувальник повинен уникати призначення Podʼа на будь-який вузол у Zone R, якщо принаймні один Pod у Zone R вже має мітку security=S2. І навпаки, правило антиспорідненості не впливає на планування у Zone R, якщо немає Podʼів з мітками security=S2.
Щоб ближче ознайомитися з прикладами спорідненості та антиспорідненості Podʼів, зверніться до проєктної документації.
В полі operator для спорідненості та антиспорідненості Podʼа можна використовувати значення In, NotIn, Exists та DoesNotExist.
Для отримання додаткової інформації про те, як це працює, перегляньте Оператори.
У принципі, topologyKey може бути будь-яким допустимим ключем мітки з такими винятками з причин продуктивності та безпеки:
Для спорідненості та антиспорідненості Podʼа порожнє поле topologyKey не дозволяється як для requiredDuringSchedulingIgnoredDuringExecution, так і для preferredDuringSchedulingIgnoredDuringExecution.
Для правил антиспорідненості Podʼа requiredDuringSchedulingIgnoredDuringExecution контролер допуску LimitPodHardAntiAffinityTopology обмежує topologyKey до kubernetes.io/hostname. Ви можете змінити або вимкнути контролер допуску, якщо хочете дозволити власні топології.
Крім labelSelector та topologyKey, ви можете за бажанням вказати список просторів імен, з якими labelSelector повинен зіставлятися, використовуючи поле namespaces на тому ж рівні, що й labelSelector та topologyKey. Якщо поле відсутнє або порожнє, namespaces стандартно відповідає простору імен Podʼа, де зʼявляється визначення спорідненості/антиспорідненості.
Селектор простору імен
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.24
Ви також можете вибирати відповідні простори імен за допомогою namespaceSelector, який є запитом міток до набору просторів імен. Умова спорідненості застосовується до просторів імен, вибраних як namespaceSelector, так і полем namespaces. Зверніть увагу, що порожній namespaceSelector ({}) відповідає всім просторам імен, тоді як null або порожній список namespaces і null namespaceSelector відповідають простору імен Podʼа, де визначено правило.
matchLabelKeys
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.33
More information about this feature
This is a stable feature in Kubernetes, and has been since version v1.33. It was first available in the v1.29 release. You can no longer disable or opt out of this feature or behavior (it is locked); if you explicitly set a value for the associated feature gate MatchLabelKeysInPodAffinity, Kubernetes ignores it but does not report any error.
Примітка:
Поле matchLabelKeys перебуває на рівні бета-версії та є стандартно увімкненим в Kubernetes 1.37. Якщо ви бажаєте його вимкнути, вам потрібно зробити це явним чином за допомогою вимкнення функціональної можливості MatchLabelKeysInPodAffinity.
У Kubernetes є необовʼязкове поле matchLabelKeys для спорідненості або антиспорідненості Podʼа. Це поле вказує ключі для міток, які повинні відповідати міткам вхідного Podʼа під час задоволення спорідненості (антиспорідненості) Podʼа.
Ці ключі використовуються для отримання значень з міток Podʼа; ці ключ-значення міток поєднуються (використовуючи AND) з обмеженнями відповідно до поля labelSelector. Обʼєднане фільтрування вибирає набір наявних Podʼів, які будуть враховуватися під час розрахунку спорідненості (антиспорідненості) Podʼа.
Увага:
Не рекомендується використовувати matchLabelKeys з мітками, які можуть оновлюватися безпосередньо на Podʼах. Навіть якщо ви редагуєте мітку Podʼів, вказану у matchLabelKeys, безпосередньо, (тобто не через deployment), kube-apiserver не відобразить оновлення мітки в обʼєднаному labelSelector.
Поширеним випадком є використання matchLabelKeys разом із pod-template-hash (встановленим у Podʼах, керованих як частина Deployment, де значення унікальне для кожної ревізії). Використання pod-template-hash в matchLabelKeys дозволяє вам спрямовувати Podʼи, які належать до тієї ж ревізії, що й вхідний Pod, щоб поетапне оновлення не порушувало спорідненість.
apiVersion:apps/v1kind:Deploymentmetadata:name:application-server...spec:template:spec:affinity:podAffinity:requiredDuringSchedulingIgnoredDuringExecution:- labelSelector:matchExpressions:- key:appoperator:Invalues:- databasetopologyKey:topology.kubernetes.io/zone# Тільки Podʼи з певного розгортання беруться до уваги під час обчислення спорідненості Podʼа.# Якщо ви оновите Deployment, Podʼи-замінники дотримуватимуться своїх власних правил спорідненості# (якщо вони визначені в новому шаблоні Podʼа).matchLabelKeys:- pod-template-hash
mismatchLabelKeys
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.33
More information about this feature
This is a stable feature in Kubernetes, and has been since version v1.33. It was first available in the v1.29 release. You can no longer disable or opt out of this feature or behavior (it is locked); if you explicitly set a value for the associated feature gate MatchLabelKeysInPodAffinity, Kubernetes ignores it but does not report any error.
Примітка:
Поле mismatchLabelKeys перебуває на рівні бета-версії та є стандартно увімкненим в Kubernetes 1.37. Якщо ви бажаєте його вимкнути, вам потрібно зробити це явним чином за допомогою вимкнення функціональної можливості MatchLabelKeysInPodAffinity.
Kubernetes включає необовʼязкове поле mismatchLabelKeys для спорідненості або антиспорідненості Podʼа. Це поле вказує ключі для міток, які не повинні мати збігу з мітками вхідного Podʼа, під час задоволення спорідненості чи антиспорідненості Podʼа.
Увага:
Не рекомендується використовувати mismatchLabelKeys з мітками, які можуть оновлюватися безпосередньо на Podʼах. Навіть якщо ви відредагуєте мітку Podʼів, вказану у mismatchLabelKeys, безпосередньо (тобто не через deployment), kube-apiserver не відобразить оновлення мітки в обʼєднаному labelSelector.
Один з прикладів використання — це забезпечення того, що Podʼи будуть розміщені в топологічному домені (вузол, зона і т. д.), де розміщені лише Podʼи від того ж орендаря або команди. Іншими словами, ви хочете уникнути запуску Podʼів від двох різних орендарів в одному топологічному домені одночасно.
apiVersion:v1kind:Podmetadata:labels:# Припустимо, що всі відповідні Podʼи мають встановлену мітку "tenant"tenant:tenant-a...spec:affinity:podAffinity:requiredDuringSchedulingIgnoredDuringExecution:# переконаємось, що Podʼи, повʼязані з цим орендарем, потрапляють у відповідний пул вузлів- matchLabelKeys:- tenantlabelSelector:{}topologyKey:node-poolpodAntiAffinity:requiredDuringSchedulingIgnoredDuringExecution:# переконаємось, що Podʼи, повʼязані з цим орендарем, не можуть розміщуватися на вузлах,# які використовуються для іншого орендаря- mismatchLabelKeys:- tenant# незалежно від значення мітки "tenant" для цього Podʼа, заборонити# розміщення на вузлах у будь-якому пулі, де працює будь-який Pod# від іншого орендаря.labelSelector:# Ми повинні мати labelSelector, який обирає лише Podʼи з міткою tenant,# інакше цей Pod матиме антиспорідненість до Podʼів з daemonsetʼів, наприклад,# які не повинні мати мітку tenant.matchExpressions:- key:tenantoperator:ExiststopologyKey:node-pool
Ще кілька практичних прикладів
Спорідненість та антиспорідненість між Podʼами можуть бути ще кориснішими, коли вони використовуються з колекціями вищого рівня, такими як ReplicaSets, StatefulSets, Deployments і т. д. Ці правила дозволяють налаштувати спільне розташування набору робочих навантажень у визначеній топології; наприклад, віддаючи перевагу розміщенню двох повʼязаних Podʼів на одному вузлі.
Наприклад: уявіть кластер з трьох вузлів. Ви використовуєте кластер для запуску вебзастосунку, а також кешу в памʼяті (наприклад, Redis). Для цього прикладу також припустімо, що затримка між вебзастосунком і кешем має бути настільки низькою, наскільки це практично можливо. Ви можете використовувати спорідненість та антиспорідненість між Podʼами, щоб розміщувати вебсервери разом із кешем, наскільки це можливо.
У наступному прикладі Deployment для кешу Redis репліки отримують мітку app=store. Правило podAntiAffinity повідомляє планувальникові уникати розміщення кількох реплік з міткою app=store на одному вузлі. Це створює кожен кеш на окремому вузлі.
У наступному прикладі Deployment для вебсерверів створює репліки з міткою app=web-store. Правило спорідненості Podʼа повідомляє планувальнику розмістити кожну репліку на вузлі, де є Pod з міткою app=store. Правило антиспорідненості Podʼа повідомляє планувальнику ніколи не розміщати кілька серверів app=web-store на одному вузлі.
Створення цих двох попередніх Deploymentʼів призводить до наступної структури кластера, де кожен вебсервер розміщений разом із кешем, на трьох окремих вузлах.
node-1
node-2
node-3
webserver-1
webserver-2
webserver-3
cache-1
cache-2
cache-3
Загальний ефект полягає в тому, що кожен екземпляр кешу ймовірно використовується одним клієнтом, який працює на тому ж самому вузлі. Цей підхід спрямований на мінімізацію як перекосу (нерівномірного навантаження), так і затримки.
У вас можуть бути інші причини використання антиспорідненості Podʼа. Дивіться навчальний матеріал із ZooKeeper
для прикладу StatefulSet, налаштованого з антиспорідненістю для забезпечення високої
доступності, використовуючи ту ж саму техніку, що й цей приклад.
nodeName
nodeName є більш прямим способом вибору вузла, ніж спорідненість або nodeSelector. nodeName — це поле в специфікації Podʼа. Якщо поле nodeName не порожнє, планувальник ігнорує Pod, і kubelet на названому вузлі намагається розмістити Pod на цьому вузлі. Використання nodeName переважає використання nodeSelector або правил спорідненості та антиспорідненості.
Деякі з обмежень використання nodeName для вибору вузлів:
Якщо зазначений вузол не існує, Pod не буде запущено, і у деяких випадках його може бути автоматично видалено.
Якщо зазначений вузол не має достатньо ресурсів для розміщення Podʼа, Pod зазнає збою, а його причина вказуватиме чому, наприклад, OutOfmemory або OutOfcpu.
Назви вузлів у хмарних середовищах не завжди передбачувані або стабільні.
Попередження:
nodeName призначений для використання власними планувальниками або у більш складних випадках, де вам потрібно обійти будь-які налаштовані планувальники. Обхід планувальників може призвести до Podʼів зі збоєм, якщо призначені вузли перевантажені. Ви можете використовувати спорідненість вузлів або поле nodeSelector, щоб призначити Pod до певного вузла без обходу планувальників.
Нижче наведено приклад специфікації Podʼа з використанням поля nodeName:
Наведений вище Pod буде запущено лише на вузлі kube-01.
nominatedNodeName
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.35; (стандартно увімкнено)
nominatedNodeName може використовуватись для зовнішніх компонентів, щоб номінувати вузол для Podʼа в очікуванні. Ця номінація працює за принципом best-effort: її може бути проігноровано, якщо планувальник визначить, що Pod не може перейти до номінованого вузла.
Крім того, це поле може бути (пере)записане планувальником:
Якщо планувальник знаходить вузол для номінації через витіснення.
Якщо планувальник вирішує, куди йде Pod, і переміщує його в цикл привʼязки.
Зверніть увагу, що в цьому випадку nominatedNodeName встановлюється лише тоді, коли Pod повинен пройти через точки розширення WaitOnPermit або PreBind.
Ось приклад статусу Podʼа з використанням поля nominatedNodeName:
Ви можете використовувати обмеження топології розміщення для керування тим, як Podʼи розподіляються по вашому кластеру серед доменів відмов, таких як регіони, зони, вузли або будь-які інші топологічні домени, які ви визначаєте. Ви можете це зробити, щоб покращити продуктивність, очікувану доступність або
загальне використання.
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.35; (стандартно увімкнено)
Podʼи успадковують мітки топології (topology.kubernetes.io/zone та topology.kubernetes.io/region) від призначеного їм вузла, якщо такі мітки присутні. Ці мітки можна потім використовувати через Downward API, щоб забезпечити робоче навантаження інформацією про топологію вузлів.
Ось приклад Podʼа, що використовує Downward API для своєї зони та регіону:
Наступні логічні оператори можна використовувати в полі operator для nodeAffinity та podAffinity, згаданих вище.
Оператор
Поведінка
In
Значення мітки присутнє у заданому наборі рядків
NotIn
Значення мітки не міститься у заданому наборі рядків
Exists
Мітка з цим ключем існує на обʼєкті
DoesNotExist
На обʼєкті не існує мітки з цим ключем
Наступні оператори можна використовувати лише з nodeAffinity.
Оператор
Поведінка
Gt
Значення поля буде інтерпретовано як ціле число, і це ціле число, отримане в результаті обробки значення мітки, визначеної цим селектором, буде більшим ніж це ціле число.
Lt
Значення поля буде інтерпретовано як ціле число, і це ціле число, отримане в результаті обробки значення мітки, визначеної цим селектором, буде меншим ніж це ціле число.
Примітка:
Оператори Gt та Lt не працюватимуть з нецілими значеннями. Якщо вказане значення не вдається розібрати як ціле число, Pod не вдасться запланувати. Крім того, Gt та Lt не доступні для podAffinity.
Коли ви запускаєте Pod на вузлі, сам Pod потребує певної кількості системних ресурсів. Ці ресурси додаються до ресурсів, необхідних для запуску контейнерів всередині Podʼа. У Kubernetes накладні витрати Podʼа (Pod Overhead) — це спосіб обліку ресурсів, які використовуються інфраструктурою Podʼа, понад запити та обмеження контейнерів.
У Kubernetes накладні витрати Podʼа встановлюються під час допуску відповідно до накладних витрат, повʼязаних із RuntimeClass Podʼа.
Накладні витрати Podʼа враховуються на додачу до суми запитів ресурсів контейнерів під час планування Podʼа. Так само kubelet включатиме накладні витрати Podʼа під час визначення розміру cgroup Podʼа і під час ранжування Podʼів для виселення.
Налаштування накладних витрат Podʼа
Вам потрібно переконатися, що використовується RuntimeClass, який визначає поле overhead.
Приклад використання
Для роботи з накладними витратами Podʼів вам потрібен RuntimeClass, який визначає поле overhead. Наприклад, ви можете використати таке визначення RuntimeClass із середовищем виконання контейнерів з віртуалізацією (у цьому прикладі Kata Containers у поєднанні з монітором віртуальної машини Firecracker), яке використовує приблизно 120MiB на Pod для віртуальної машини та гостьової ОС:
# Вам потрібно змінити цей приклад, щоб назва та накладні витрати ресурсів на Pod# відповідали тим, що додає середовище виконання контейнерів у вашому кластері.apiVersion:node.k8s.io/v1kind:RuntimeClassmetadata:name:kata-fchandler:kata-fcoverhead:podFixed:memory:"120Mi"cpu:"250m"
Робочі навантаження, створені із зазначенням обробника RuntimeClass kata-fc, враховуватимуть накладні витрати памʼяті та CPU в обчисленнях квот ресурсів, під час планування на вузли, а також під час визначення розміру cgroup Podʼа.
Якщо у визначенні Podʼа вказані лише limits, kubelet виведе requests з цих обмежень і встановить їх такими ж, як і визначені limits.
Під час допуску контролер допуску RuntimeClass оновлює PodSpec робочого навантаження, щоб додати overhead, описаний у RuntimeClass. Якщо в PodSpec це поле вже визначено, Pod буде відхилено. У наведеному прикладі, оскільки вказано лише назву RuntimeClass, контролер допуску змінює Pod, додаючи overhead.
Після того, як контролер допуску RuntimeClass вніс зміни, ви можете перевірити оновлене значення накладних витрат Podʼа:
kubectl get pod test-pod -o jsonpath='{.spec.overhead}'
Вивід:
map[cpu:250m memory:120Mi]
Якщо визначено ResourceQuota, то враховується сума запитів контейнерів, а також поле overhead.
Коли kube-scheduler вирішує, на якому вузлі слід запускати новий Pod, він бере до уваги overhead цього Podʼа, а також суму запитів контейнерів для цього Podʼа. Для цього прикладу планувальник додає запити та overhead, а потім шукає вузол, на якому є 2,25 CPU та 320 MiB вільної памʼяті.
Після того, як Pod заплановано на вузол, kubelet на цьому вузлі створює нову cgroup для Podʼа. Саме в цьому Podʼі базове середовище виконання контейнерів створюватиме контейнери.
Якщо для кожного контейнера визначено обмеження ресурсу (Guaranteed QoS або Burstable QoS з визначеними обмеженнями), то kubelet встановлює верхнє обмеження для cgroup Podʼа, повʼязаної з цим ресурсом (cpu.cfs_quota_us для CPU та memory.limit_in_bytes для памʼяті). Це верхнє обмеження базується на сумі обмежень контейнерів плюс поле overhead, визначене в PodSpec.
Для CPU, якщо Pod має Guaranteed або Burstable QoS, то kubelet встановлює cpu.shares на основі суми запитів контейнерів плюс поле overhead, визначене в PodSpec.
Повертаючись до нашого прикладу, перевірте запити контейнерів для робочого навантаження:
kubectl get pod test-pod -o jsonpath='{.spec.containers[*].resources.limits}'
Загальні запити контейнерів становлять 2000m CPU та 200MiB памʼяті:
Вивід показує запити для 2250m CPU та 320MiB памʼяті. Запити включають накладні витрати Podʼа:
  Namespace    Name       CPU Requests  CPU Limits   Memory Requests  Memory Limits  AGE
  ---------    ----       ------------  ----------   ---------------  -------------  ---
  default      test-pod   2250m (56%)   2250m (56%)  320Mi (1%)       320Mi (1%)     36m
Перевірка обмежень cgroup Podʼа
Перевірте cgroup памʼяті Podʼа на вузлі, де працює робоче навантаження. У наступному прикладі використовується crictl на вузлі, який надає інтерфейс командного рядка для сумісних із CRI середовищ виконання контейнерів. Це складний приклад, що демонструє поведінку накладних витрат Podʼа, і не очікується, що користувачам потрібно буде безпосередньо перевіряти cgroups на вузлі.
Спочатку на конкретному вузлі визначте ідентифікатор Podʼа:
# Виконайте це на вузлі, де заплановано PodPOD_ID="$(sudo crictl pods --name test-pod -q)"
З цього можна визначити шлях cgroup Podʼа:
# Виконайте це на вузлі, де заплановано Podsudo crictl inspectp -o=json $POD_ID| grep cgroupsPath
Отриманий шлях cgroup включає контейнер pause Podʼа. Cgroup рівня Podʼа розташована на одну теку вище.
У цьому конкретному випадку шлях cgroup Podʼа — kubepods/podd7f4b509-cf94-4951-9417-d1087c92a5b2. Перевірте налаштування памʼяті cgroup рівня Podʼа:
# Виконайте це на вузлі, де заплановано Pod.# Також змініть назву cgroup, щоб вона відповідала cgroup, виділеній для вашого Podʼа. cat /sys/fs/cgroup/memory/kubepods/podd7f4b509-cf94-4951-9417-d1087c92a5b2/memory.limit_in_bytes
Це 320 MiB, як і очікувалося:
335544320
Спостережуваність
Деякі метрики kube_pod_overhead_* доступні у kube-state-metrics для ідентифікації використання накладних витрат Podʼа та спостереження за стабільністю робочих навантажень, які працюють з визначеними накладними витратами.
Podʼи вважалися готовими до планування відразу після створення. Планувальник Kubernetes виконує всі необхідні дії для знаходження вузлів для розміщення всіх Podʼів, що очікують. Однак на практиці деякі Podʼи можуть перебувати в стані «бракує необхідних ресурсів» («miss-essential-resources») протягом тривалого періоду. Ці Podʼи фактично створюють непотрібне навантаження на планувальник (і на залежні від нього інтегратори, такі як Cluster AutoScaler).
Шляхом вказання/видалення поля .spec.schedulingGates для Podʼа ви можете контролювати, коли Pod готовий до розгляду для планування.
Налаштування schedulingGates Podʼа
Поле schedulingGates містить список рядків, і кожний рядок сприймається як критерій, який повинен бути задоволений перед тим, як Pod буде вважатися придатним для планування. Це поле можна ініціалізувати лише під час створення Podʼа (клієнтом або шляхом зміни під час допуску). Після створення кожен schedulingGate можна видалити у довільному порядку, але додавання нового шлюзу планування заборонено.
stateDiagram-v2

    s1: Pod створено
    s2: Очікування планування Podʼа
    s3: Pod готовий до планування
    s4: Pod виконується
    if: шлюзи планування порожні?
    [*] --> s1
    s1 --> if
    s2 --> if: шлюз
планування
видалено
    if --> s2: ні
    if --> s3: так
    s3 --> s4
    s4 --> [*]

classDef k8s fill:#326ce5,stroke:#fff,stroke-width:4px,color:#fff;
class s1,s2,s3,s4,if k8s
Схема. schedulingGates Podʼа
Приклад використання
Щоб позначити Pod як не готовий до планування, ви можете створити його з одним або кількома шлюзами планування так:
Щоб повідомити планувальнику, що цей Pod готовий до планування, ви можете повністю видалити його schedulingGates шляхом повторного застосування зміненого маніфеста:
Ви можете перевірити, чи очищено schedulingGates, виконавши:
kubectl get pod test-pod -o jsonpath='{.spec.schedulingGates}'
Очікується, що вивід буде порожнім. І ви можете перевірити його останній стан, запустивши:
kubectl get pod test-pod -o wide
Враховуючи те, що test-pod не запитує жодних ресурсів CPU/памʼяті, очікується, що стан цього Podʼа перейде з попереднього SchedulingGated в Running:
NAME       READY   STATUS    RESTARTS   AGE   IP         NODE
test-pod   1/1     Running   0          15s   10.0.0.4   node-2
Спостережуваність
Метрика scheduler_pending_pods має нову мітку "gated", щоб відрізняти, чи були спроби запланувати Pod, але він був визначений як непридатний для планування, чи він явно позначений як не готовий для планування. Ви можете використовувати scheduler_pending_pods{queue="gated"} для перевірки результату метрики.
Змінювані директиви планування Podʼа
Ви можете змінювати директиви планування Podʼа, коли вони мають шлюзи планування, з певними обмеженнями. У загальних рисах, ви можете лише робити директиви планування Podʼа жорсткішими. Іншими словами, оновлені директиви призведуть до можливості розміщення Podʼів тільки на підмножині вузлів, з якими вони раніше мали збіг. Конкретніше, правила для оновлення директив планування Podʼа такі:
Для .spec.nodeSelector дозволяються лише додавання. Якщо відсутнє, його можна встановити.
Для spec.affinity.nodeAffinity, якщо nil, тоді дозволяється встановлення будь-чого.
Якщо NodeSelectorTerms був порожнім, дозволено встановлення. Якщо не порожній, тоді дозволяються лише додавання NodeSelectorRequirements до matchExpressions або fieldExpressions, а зміни наявних matchExpressions і fieldExpressions не будуть дозволені. Це тому, що умови в .requiredDuringSchedulingIgnoredDuringExecution.NodeSelectorTerms обʼєднуються через OR, тоді як вирази в nodeSelectorTerms[].matchExpressions та nodeSelectorTerms[].fieldExpressions обʼєднуються через AND.
Для .preferredDuringSchedulingIgnoredDuringExecution всі оновлення дозволені. Це повʼязано з тим, що бажані умови не є авторитетними, і тому контролери політики не перевіряють ці умови.
Ви можете використовувати обмеження топології розміщення для контролю того, як Podʼи розподіляються по вашому кластеру серед доменів відмов, таких як регіони, зони, вузли та інші визначені користувачем топологічні домени. Це може допомогти забезпечити високу доступність, а також ефективне використання ресурсів.
Ви можете встановити обмеження на рівні кластера як стандартні або налаштувати обмеження топології розміщення для окремих робочих навантажень.
Мотивація
Уявіть, що у вас є кластер, у якому до двадцяти вузлів, і ви хочете запустити робоче навантаження, яке автоматично масштабує кількість реплік, які використовує. Це може бути лише два Podʼи або аж пʼятнадцять. Коли є лише два Podʼи, ви б воліли, щоб обидва ці Podʼи не працювали на одному вузлі: ви ризикуєте, що відмова одного вузла зробить ваше робоче навантаження недоступним.
Крім цього базового використання, є кілька прикладів розширеного використання, які дають вашим робочим навантаженням змогу отримувати переваги у високій доступності та використанні кластера.
Під час масштабування та запуску більшої кількості Podʼів важливою стає інша проблема. Уявіть, що у вас є три вузли, на кожному з яких працює по пʼять Podʼів. Вузли мають достатню місткість для запуску такої кількості реплік; проте клієнти, які взаємодіють із цим робочим навантаженням, розподілені по трьох різних центрах обробки даних (або інфраструктурних зонах). Тепер вас менше турбує відмова одного вузла, але ви помічаєте, що затримка вища, ніж вам хотілося б, і ви платите за мережеві витрати, повʼязані з передаванням мережевого трафіку між різними зонами.
Ви вирішуєте, що за нормальної роботи ви б воліли мати приблизно однакову кількість реплік, запланованих у кожну інфраструктурну зону, і хотіли б, щоб кластер самозцілювався в разі виникнення проблеми.
Обмеження топології розміщення Podʼів пропонують вам декларативний спосіб це налаштувати.
Поле topologySpreadConstraints
У API Pod є поле spec.topologySpreadConstraints. Використання цього поля виглядає так:
---apiVersion:v1kind:Podmetadata:name:example-podspec:# Налаштувати обмеження топології розміщенняtopologySpreadConstraints:- maxSkew:<ціле число>minDomains:<ціле число># необовʼязковоtopologyKey:<рядок>whenUnsatisfiable:<рядок>labelSelector:<обʼєкт>matchLabelKeys:<список># необовʼязково; бета з v1.27nodeAffinityPolicy:[Honor|Ignore]# необовʼязково; бета з v1.26nodeTaintsPolicy:[Honor|Ignore]# необовʼязково; бета з v1.26### інші поля Pod тут
Примітка:
Для заданої пари значень topologyKey та whenUnsatisfiable може бути лише один topologySpreadConstraint. Наприклад, якщо ви визначили topologySpreadConstraint, що використовує topologyKey "kubernetes.io/hostname" і значення whenUnsatisfiable "DoNotSchedule", ви можете додати інший topologySpreadConstraint для topologyKey "kubernetes.io/hostname" лише в тому випадку, якщо використаєте інше значення whenUnsatisfiable.
Додаткову інформацію про це поле можна отримати, виконавши команду kubectl explain Pod.spec.topologySpreadConstraints або звернувшись до розділу планування довідки API для Pod.
Визначення обмеження топології розміщення
Ви можете визначити один або кілька записів topologySpreadConstraints, щоб вказати kube-scheduler, як розмістити кожний вхідний Pod відносно наявних Podʼів у вашому кластері. Ці поля такі:
maxSkew описує ступінь нерівномірності розподілу Podʼів. Ви повинні вказати це поле, а його значення має бути більшим за нуль. Його семантика відрізняється залежно від значення whenUnsatisfiable:
якщо ви виберете whenUnsatisfiable: DoNotSchedule, то maxSkew визначає максимально допустиму різницю між кількістю відповідних Podʼів у цільовій топології та глобальним мінімумом (мінімальною кількістю відповідних Podʼів у прийнятному домені або нулем, якщо кількість прийнятних доменів менша за MinDomains). Наприклад, якщо у вас є 3 зони, де кількість відповідних Podʼів становить 2, 2 та 1, а maxSkew встановлено на 1, то глобальний мінімум дорівнює 1.
якщо ви виберете whenUnsatisfiable: ScheduleAnyway, планувальник надає вищий пріоритет топологіям, які допомогли б зменшити перекіс.
minDomains вказує мінімальну кількість прийнятних доменів. Це поле є необовʼязковим. Домен — це певний екземпляр топології. Прийнятний домен — це домен, вузли якого відповідають селектору вузлів.
Примітка:
До Kubernetes v1.30 поле minDomains було доступне лише за умови, що функціональну можливість MinDomainsInPodTopologySpread увімкнено (стандартно увімкнена починаючи з v1.28). У старіших кластерах Kubernetes її може бути явно вимкнено, або поле може бути недоступним.
Значення minDomains має бути більшим за 0, якщо його вказано. Ви можете вказати minDomains лише разом із whenUnsatisfiable: DoNotSchedule.
Коли кількість прийнятних доменів з відповідними ключами топології менша за minDomains, під час розміщення Podʼів за топологією глобальний мінімум вважається рівним 0, а потім виконується обчислення skew. Глобальний мінімум — це мінімальна кількість відповідних Podʼів у прийнятному домені або нуль, якщо кількість прийнятних доменів менша за minDomains.
Коли кількість прийнятних доменів з відповідними ключами топології дорівнює minDomains або більша за нього, це значення не впливає на планування.
Якщо ви не вказуєте minDomains, обмеження поводиться так, ніби minDomains дорівнює 1.
topologyKey — ключ міток вузла. Вузли, які мають мітку з цим ключем та однаковими значеннями, вважаються такими, що належать до однієї топології. Кожен екземпляр топології (іншими словами, пара <ключ, значення>) називається доменом. Планувальник намагатиметься розмістити збалансовану кількість Podʼів у кожному домені. Також ми визначаємо прийнятний домен як домен, вузли якого відповідають вимогам nodeAffinityPolicy та nodeTaintsPolicy.
whenUnsatisfiable вказує, що робити з Podʼом, якщо він не задовольняє обмеження топології розміщення:
DoNotSchedule (стандартно) вказує планувальнику не планувати його.
ScheduleAnyway вказує планувальнику все одно його планувати, надаючи пріоритет вузлам, що мінімізують перекіс.
labelSelector використовується для пошуку відповідних Podʼів. Podʼи, які відповідають цьому селектору міток, враховуються для визначення кількості Podʼів у відповідному топологічному домені. Докладніше дивіться в розділі Селектори міток.
matchLabelKeys — це список ключів міток Podʼа для вибору групи Podʼів, для яких буде обчислено перекіс розподілу. Під час створення Podʼа kube-apiserver використовує ці ключі для пошуку значень у мітках вхідного Podʼа, і ці мітки ключ-значення буде обʼєднано з наявним labelSelector. Один і той самий ключ не може бути одночасно в matchLabelKeys і в labelSelector. matchLabelKeys не можна встановити, якщо не встановлено labelSelector. Ключі, яких немає в мітках Podʼа, буде проігноровано. Значення null або порожній список означає відповідність лише labelSelector.
Увага:
Не рекомендується використовувати matchLabelKeys з мітками, які можуть бути оновлені безпосередньо в Podʼах. Навіть якщо ви безпосередньо редагуєте мітку Podʼа, вказану в matchLabelKeys (тобто ви редагуєте Pod, а не Deployment), kube-apiserver не відображає оновлення мітки в обʼєднаному labelSelector.
З matchLabelKeys вам не потрібно оновлювати pod.spec між різними ревізіями. Контролеру/оператору достатньо встановити різні значення для того самого ключа мітки для різних ревізій. Наприклад, якщо ви налаштовуєте Deployment, ви можете використовувати мітку з ключем pod-template-hash, яка автоматично додається контролером Deployment, щоб розрізняти різні ревізії в одному Deployment.
Поле matchLabelKeys є полем рівня бета і стандартно увімкнене у 1.27. Ви можете вимкнути його, вимкнувши функціональну можливість MatchLabelKeysInPodTopologySpread.
До v1.34 matchLabelKeys оброблявся неявно. Починаючи з v1.34, мітки ключ-значення, що відповідають matchLabelKeys, явно обʼєднуються з labelSelector. Ви можете вимкнути це й повернутися до попередньої поведінки, вимкнувши функціональну можливість MatchLabelKeysInPodTopologySpreadSelectorMerge у kube-apiserver.
nodeAffinityPolicy вказує, як ми будемо обробляти nodeAffinity/nodeSelector Podʼа під час обчислення перекосу топології розміщення Podʼів. Варіанти:
Honor: до розрахунків включаються лише вузли, які відповідають nodeAffinity/nodeSelector.
Ignore: nodeAffinity/nodeSelector ігноруються. До розрахунків включаються всі вузли.
Якщо це значення є null, поведінка еквівалентна політиці Honor.
Примітка:
Поле nodeAffinityPolicy було полем рівня бета з v1.26 і стало загальнодоступним (GA) у v1.33. У бета-версії воно стандартно увімкнене, і ви можете вимкнути його, вимкнувши функціональну можливість NodeInclusionPolicyInPodTopologySpread.
nodeTaintsPolicy вказує, як ми будемо обробляти taints вузлів під час обчислення перекосу топології розміщення Podʼів. Варіанти:
Honor: включаються вузли без taints, а також вузли з taints, для яких вхідний Pod має toleration.
Ignore: taints вузла ігноруються. Включаються всі вузли.
Якщо це значення є null, поведінка еквівалентна політиці Ignore.
Примітка:
Поле nodeTaintsPolicy було полем рівня бета з v1.26 і стало загальнодоступним (GA) у v1.33. У бета-версії воно стандартно увімкнене, і ви можете вимкнути його, вимкнувши функціональну можливість NodeInclusionPolicyInPodTopologySpread.
Коли Pod визначає більше одного topologySpreadConstraint, ці обмеження поєднуються за допомогою логічної операції AND: kube-scheduler шукає для вхідного Podʼа вузол, який задовольняє всі налаштовані обмеження.
Мітки вузлів
Обмеження топології розміщення ґрунтуються на мітках вузлів, які визначають топологічні домени кожного вузла. Наприклад, вузол може мати такі мітки:
region:us-east-1zone:us-east-1a
Примітка:
Для стислості в цьому прикладі не використовуються відомі ключі міток topology.kubernetes.io/zone та topology.kubernetes.io/region. Однак рекомендується використовувати саме ці зареєстровані ключі міток, а не приватні (некваліфіковані) ключі міток region та zone, які використовуються тут.
Ви не можете робити надійних припущень щодо значення приватного ключа мітки в різних контекстах.
Припустимо, у вас є кластер із 4 вузлами з такими мітками:
NAME    STATUS   ROLES    AGE     VERSION   LABELS
node1   Ready    <none>   4m26s   v1.16.0   node=node1,zone=zoneA
node2   Ready    <none>   3m58s   v1.16.0   node=node2,zone=zoneA
node3   Ready    <none>   3m17s   v1.16.0   node=node3,zone=zoneB
node4   Ready    <none>   2m43s   v1.16.0   node=node4,zone=zoneB
Тоді кластер логічно виглядає так:
graph TB
    subgraph "zoneB"
        n3(Node3)
        n4(Node4)
    end
    subgraph "zoneA"
        n1(Node1)
        n2(Node2)
    end

    classDef plain fill:#ddd,stroke:#fff,stroke-width:4px,color:#000;
    classDef k8s fill:#326ce5,stroke:#fff,stroke-width:4px,color:#fff;
    classDef cluster fill:#fff,stroke:#bbb,stroke-width:2px,color:#326ce5;
    class n1,n2,n3,n4 k8s;
    class zoneA,zoneB cluster;
Узгодженість
Вам слід встановити однакові обмеження топології розміщення Podʼів для всіх Podʼів у групі.
Зазвичай, якщо ви використовуєте контролер робочого навантаження, такий як Deployment, шаблон Podʼа подбає про це за вас. Якщо ви змішуєте різні обмеження розподілу, Kubernetes дотримується визначення цього поля в API; однак поведінка з більшою ймовірністю стане заплутаною, а усунення несправностей буде менш простим.
Вам потрібен механізм, що забезпечує узгоджені мітки на всіх вузлах топологічного домену (наприклад, регіону хмарного провайдера). Щоб вам не доводилося додавати мітки до вузлів вручну, більшість кластерів автоматично заповнюють відомі мітки, такі як kubernetes.io/hostname. Перевірте, чи підтримує це ваш кластер.
Приклади обмежень топології розміщення
Приклад: одне обмеження топології розміщення
Припустимо, у вас є кластер із 4 вузлами, де 3 Podʼи з міткою foo: bar розташовані на вузлах node1, node2 та node3 відповідно:
graph BT
    subgraph "zoneB"
        p3(Pod) --> n3(Node3)
        n4(Node4)
    end
    subgraph "zoneA"
        p1(Pod) --> n1(Node1)
        p2(Pod) --> n2(Node2)
    end

    classDef plain fill:#ddd,stroke:#fff,stroke-width:4px,color:#000;
    classDef k8s fill:#326ce5,stroke:#fff,stroke-width:4px,color:#fff;
    classDef cluster fill:#fff,stroke:#bbb,stroke-width:2px,color:#326ce5;
    class n1,n2,n3,n4,p1,p2,p3 k8s;
    class zoneA,zoneB cluster;
Якщо ви хочете, щоб вхідний Pod був рівномірно розподілений разом із наявними Podʼами по зонах, ви можете використати маніфест, схожий на такий:
У цьому маніфесті topologyKey: zone означає, що рівномірний розподіл буде застосовуватися лише до вузлів, які мають мітку zone: <будь-яке значення> (вузли, які не мають мітки zone, буде пропущено). Поле whenUnsatisfiable: DoNotSchedule вказує планувальнику залишити вхідний Pod в очікуванні, якщо планувальник не може знайти спосіб задовольнити обмеження.
Якщо планувальник розмістить цей вхідний Pod у зоні A, розподіл Podʼів стане [3, 1]. Це означає, що фактичний перекіс становить 2 (обчислюється як 3 - 1), що порушує maxSkew: 1. Щоб задовольнити обмеження та умови цього прикладу, вхідний Pod може бути розміщений лише на вузлі в зоні B:
graph BT
    subgraph "zoneB"
        p3(Pod) --> n3(Node3)
        p4(mypod) --> n4(Node4)
    end
    subgraph "zoneA"
        p1(Pod) --> n1(Node1)
        p2(Pod) --> n2(Node2)
    end

    classDef plain fill:#ddd,stroke:#fff,stroke-width:4px,color:#000;
    classDef k8s fill:#326ce5,stroke:#fff,stroke-width:4px,color:#fff;
    classDef cluster fill:#fff,stroke:#bbb,stroke-width:2px,color:#326ce5;
    class n1,n2,n3,n4,p1,p2,p3 k8s;
    class p4 plain;
    class zoneA,zoneB cluster;
або
graph BT
    subgraph "zoneB"
        p3(Pod) --> n3(Node3)
        p4(mypod) --> n3
        n4(Node4)
    end
    subgraph "zoneA"
        p1(Pod) --> n1(Node1)
        p2(Pod) --> n2(Node2)
    end

    classDef plain fill:#ddd,stroke:#fff,stroke-width:4px,color:#000;
    classDef k8s fill:#326ce5,stroke:#fff,stroke-width:4px,color:#fff;
    classDef cluster fill:#fff,stroke:#bbb,stroke-width:2px,color:#326ce5;
    class n1,n2,n3,n4,p1,p2,p3 k8s;
    class p4 plain;
    class zoneA,zoneB cluster;
Ви можете змінити специфікацію Podʼа, щоб вона відповідала різним вимогам:
Змініть maxSkew на більше значення, наприклад 2, щоб вхідний Pod також можна було розмістити в зоні A.
Змініть topologyKey на node, щоб рівномірно розподілити Podʼи по вузлах, а не по зонах. У наведеному вище прикладі, якщо maxSkew залишиться 1, вхідний Pod може бути розміщений лише на вузлі node4.
Змініть whenUnsatisfiable: DoNotSchedule на whenUnsatisfiable: ScheduleAnyway, щоб вхідний Pod завжди був придатним для планування (за умови, що вимоги інших API планування задоволено). Однак перевага надається розміщенню в топологічному домені, який має менше відповідних Podʼів. (Памʼятайте, що ця перевага нормалізується разом з іншими внутрішніми пріоритетами планування, такими як коефіцієнт використання ресурсів.)
Приклад: кілька обмежень топології розміщення
Цей приклад базується на попередньому. Припустимо, у вас є кластер із 4 вузлами, де 3 наявні Podʼи з міткою foo: bar розташовані на вузлах node1, node2 і node3 відповідно:
graph BT
    subgraph "zoneB"
        p3(Pod) --> n3(Node3)
        n4(Node4)
    end
    subgraph "zoneA"
        p1(Pod) --> n1(Node1)
        p2(Pod) --> n2(Node2)
    end

    classDef plain fill:#ddd,stroke:#fff,stroke-width:4px,color:#000;
    classDef k8s fill:#326ce5,stroke:#fff,stroke-width:4px,color:#fff;
    classDef cluster fill:#fff,stroke:#bbb,stroke-width:2px,color:#326ce5;
    class n1,n2,n3,n4,p1,p2,p3 k8s;
    class p4 plain;
    class zoneA,zoneB cluster;
Ви можете поєднати два обмеження топології розміщення, щоб контролювати розподіл Podʼів як за вузлами, так і за зонами:
У цьому випадку, щоб відповідати першому обмеженню, вхідний Pod може бути розміщений лише на вузлах у зоні B; тоді як згідно з другим обмеженням вхідний Pod може бути запланований лише на вузол node4. Планувальник розглядає лише варіанти, які задовольняють усі визначені обмеження, тому єдиним допустимим розміщенням є вузол node4.
Приклад: конфліктні обмеження топології розміщення
Кілька обмежень можуть призвести до конфліктів. Припустимо, у вас є кластер із 3 вузлами у 2 зонах:
graph BT
    subgraph "zoneB"
        p4(Pod) --> n3(Node3)
        p5(Pod) --> n3
    end
    subgraph "zoneA"
        p1(Pod) --> n1(Node1)
        p2(Pod) --> n1
        p3(Pod) --> n2(Node2)
    end

    classDef plain fill:#ddd,stroke:#fff,stroke-width:4px,color:#000;
    classDef k8s fill:#326ce5,stroke:#fff,stroke-width:4px,color:#fff;
    classDef cluster fill:#fff,stroke:#bbb,stroke-width:2px,color:#326ce5;
    class n1,n2,n3,n4,p1,p2,p3,p4,p5 k8s;
    class zoneA,zoneB cluster;
Якщо ви застосуєте two-constraints.yaml (маніфест із попереднього прикладу) до цього кластера, ви побачите, що Pod mypod залишається у стані Pending. Це відбувається тому, що для задоволення першого обмеження Pod mypod може бути розміщений лише в зоні B; тоді як згідно з другим обмеженням Pod mypod може бути запланований лише на вузол node2. Перетин двох обмежень дає порожню множину, і планувальник не може розмістити Pod.
Щоб вийти з цієї ситуації, ви можете або збільшити значення maxSkew, або змінити одне з обмежень, щоб воно використовувало whenUnsatisfiable: ScheduleAnyway. Залежно від обставин, ви також можете вирішити видалити наявний Pod вручну — наприклад, якщо ви зʼясовуєте, чому розгортання виправлення помилки не просувається.
Взаємодія зі спорідненістю вузлів та селекторами вузлів
Планувальник пропустить вузли, що не відповідають, в обчисленнях перекосу, якщо у вхідного Podʼа визначено spec.nodeSelector або spec.affinity.nodeAffinity.
Приклад: обмеження топології розміщення зі спорідненістю вузлів
Припустимо, у вас є кластер із 5 вузлами, розташованими в зонах від A до C:
graph BT
    subgraph "zoneB"
        p3(Pod) --> n3(Node3)
        n4(Node4)
    end
    subgraph "zoneA"
        p1(Pod) --> n1(Node1)
        p2(Pod) --> n2(Node2)
    end

classDef plain fill:#ddd,stroke:#fff,stroke-width:4px,color:#000;
classDef k8s fill:#326ce5,stroke:#fff,stroke-width:4px,color:#fff;
classDef cluster fill:#fff,stroke:#bbb,stroke-width:2px,color:#326ce5;
class n1,n2,n3,n4,p1,p2,p3 k8s;
class p4 plain;
class zoneA,zoneB cluster;
graph BT
    subgraph "zoneC"
        n5(Node5)
    end

classDef plain fill:#ddd,stroke:#fff,stroke-width:4px,color:#000;
classDef k8s fill:#326ce5,stroke:#fff,stroke-width:4px,color:#fff;
classDef cluster fill:#fff,stroke:#bbb,stroke-width:2px,color:#326ce5;
class n5 k8s;
class zoneC cluster;
і ви знаєте, що зону C потрібно виключити. У цьому випадку ви можете скласти маніфест, як наведено нижче, щоб Pod mypod був розміщений у зоні B, а не в зоні C. Так само Kubernetes враховує і spec.nodeSelector.
Тут є кілька неявних домовленостей, на які варто звернути увагу:
Відповідними кандидатами можуть бути лише ті Podʼи, що перебувають у тому самому просторі імен, що й вхідний Pod.
Планувальник розглядає лише ті вузли, у яких одночасно присутні всі topologySpreadConstraints[*].topologyKey. Вузли, у яких відсутній будь-який з цих topologyKeys, пропускаються. Це означає, що:
будь-які Podʼи, розташовані на цих пропущених вузлах, не впливають на обчислення maxSkew — у наведеному вище прикладі, припустимо, що вузол node1 не має мітки "zone", тоді 2 Podʼи буде проігноровано, тому вхідний Pod буде заплановано в зону A.
вхідний Pod не має шансів бути запланованим на такі вузли — у наведеному вище прикладі, припустимо, що вузол node5 має мітку з помилкоюzone-typo: zoneC (і не має встановленої мітки zone). Після приєднання вузла node5 до кластера його буде пропущено, і Podʼи цього робочого навантаження не плануватимуться на нього.
Враховуйте, що станеться, якщо topologySpreadConstraints[*].labelSelector вхідного Podʼа не відповідає його власним міткам. У наведеному вище прикладі, якщо ви видалите мітки вхідного Podʼа, його все ще можна розмістити на вузлах у зоні B, оскільки обмеження все ще виконуються. Проте після цього розміщення ступінь незбалансованості кластера залишається без змін — зона A все ще має 2 Podʼи з міткою foo: bar, а зона B має 1 Pod з міткою foo: bar. Якщо це не те, що ви очікуєте, оновіть topologySpreadConstraints[*].labelSelector робочого навантаження, щоб він відповідав міткам у шаблоні Podʼа.
Стандартні обмеження на рівні кластера
Для кластера можна встановити стандартні обмеження топології розміщення. Стандартні обмеження топології розміщення застосовуються до Podʼа тоді й лише тоді, коли:
Він не визначає жодних обмежень у своєму .spec.topologySpreadConstraints.
Він належить до Service, ReplicaSet, StatefulSet або ReplicationController.
Стандартні обмеження можна встановити як частину аргументів втулка PodTopologySpread у профілі планування. Обмеження задаються за допомогою того самого API, що описаний вище, за винятком того, що labelSelector має бути порожнім. Селектори обчислюються на основі Services, ReplicaSets, StatefulSets або ReplicationControllers, до яких належить Pod.
Якщо ви не налаштовуєте жодних стандартних обмежень на рівні кластера для топології розміщення Podʼів, то kube-scheduler діє так, ніби ви вказали такі стандартні обмеження топології:
Також застарілий втулок SelectorSpread, який забезпечує еквівалентну поведінку, стандартно вимкнений.
Примітка:
Втулок PodTopologySpread не оцінює вузли, які не мають ключів топології, вказаних в обмеженнях розподілу. Це може призвести до іншої стандартної поведінки порівняно із застарілим втулком SelectorSpread, коли використовуються стандартні обмеження топології.
Якщо ви не очікуєте, що на ваших вузлах будуть встановлені обидві мітки kubernetes.io/hostname та topology.kubernetes.io/zone, визначте власні обмеження замість використання стандартних обмежень Kubernetes.
Якщо ви не хочете використовувати стандартні обмеження топології розміщення Podʼів для вашого кластера, ви можете вимкнути їх, встановивши defaultingType у List і залишивши порожнім defaultConstraints у конфігурації втулка PodTopologySpread:
притягує Podʼи; ви можете спробувати упакувати будь-яку кількість Podʼів у відповідні топологічні домени.
podAntiAffinity
відштовхує Podʼи. Якщо ви встановите режим requiredDuringSchedulingIgnoredDuringExecution, то в один топологічний домен може бути запланований лише один Pod; якщо ви виберете preferredDuringSchedulingIgnoredDuringExecution, то втратите можливість примусово забезпечити дотримання обмеження.
Для точнішого контролю ви можете вказати обмеження топології розміщення, щоб розподіляти Podʼи по різних топологічних доменах — для досягнення високої доступності або економії коштів. Це також може допомогти під час поетапного оновлення робочих навантажень і плавного масштабування реплік.
Докладнішу інформацію див. у розділі Motivation пропозиції щодо вдосконалення про обмеження топології розміщення Podʼів.
Відомі обмеження
Немає гарантії, що обмеження залишаться задоволеними під час видалення Podʼів. Наприклад, зменшення масштабу Deployment може призвести до нерівномірного розподілу Podʼів.
Ви можете використовувати інструмент, такий як Descheduler, для перебалансування розподілу Podʼів.
Відповідні Podʼи на вузлах із taints враховуються. Див. Issue 80921.
Планувальник не має попереднього знання про всі зони або інші топологічні домени кластера. Вони визначаються на основі наявних вузлів у кластері. Це може призвести до проблем у кластерах з автомасштабуванням, коли пул вузлів (або група вузлів) масштабується до нуля вузлів, а ви очікуєте масштабування кластера, оскільки в цьому випадку ці топологічні домени не будуть враховуватися, поки в них не зʼявиться хоча б один вузол.
Ви можете обійти це, використовуючи автомасштабувальник вузлів, який враховує обмеження топології розміщення Podʼів і знає про загальний набір топологічних доменів.
Podʼи, які не відповідають власному labelSelector, створюють «Podʼи-привиди» (ghost pods). Якщо мітки Podʼа не відповідають labelSelector у його обмеженні топології розміщення, Pod не враховує себе в обчисленнях розподілу. Це означає:
Кілька таких Podʼів можуть просто накопичуватися в одній топології (доки не буде створено або видалено відповідні Podʼи), оскільки планування цих Podʼів не змінює результат обчислення розподілу.
Обмеження розподілу працює не так, як передбачалося, і, найімовірніше, не відповідає вашим очікуванням.
Переконайтеся, що мітки вашого Podʼа відповідають labelSelector у ваших обмеженнях розподілу. Зазвичай Pod має відповідати селектору власного обмеження топології розміщення.
Що далі
У статті блогу Introducing PodTopologySpread докладно пояснюється maxSkew, а також розглядаються деякі приклади розширеного використання.
Спорідненість вузлів (node affinity) — це властивість Podʼів, яка притягує їх до набору вузлів (або як перевага, або як жорстка вимога). Taints є протилежністю — вони дозволяють вузлу відштовхувати набір Podʼів.
Tolerations застосовуються до Podʼів. Tolerations дозволяють планувальнику планувати Podʼи на вузли з відповідними taints. Tolerations дозволяють планування, але не гарантують його: планувальник також оцінює інші параметри в межах своєї роботи.
Taints та tolerations працюють разом, щоб Podʼи не планувалися на непридатні вузли. На вузол накладається один або кілька taints; це означає, що вузол не повинен приймати жодних Podʼів, які не толерують ці taints.
Концепції
Ви додаєте taint до вузла за допомогою kubectl taint. Наприклад,
kubectl taint nodes node1 key1=value1:NoSchedule
додає taint до вузла node1. Taint має ключ key1, значення value1 і ефект taint NoSchedule. Це означає, що жодний Pod не зможе розміститись на node1, якщо він не має відповідної toleration.
Щоб видалити taint, доданий командою вище, можна виконати:
kubectl taint nodes node1 key1=value1:NoSchedule-
Ви вказуєте toleration для Podʼа в PodSpec. Обидві наступні tolerations «відповідають» taint, створеному за допомогою команди kubectl taint вище, тому Pod з будь-якою з них зможе розміститись на node1:
Стандартний планувальник Kubernetes бере до уваги taints та tolerations під час вибору вузла для запуску певного Podʼа. Проте, якщо ви вручну вказуєте .spec.nodeName для Podʼа, ця дія оминає планувальник; Pod тоді привʼязується до вузла, на який ви його призначили, навіть якщо на вибраному вами вузлі є taints типу NoSchedule. Якщо це трапиться і на вузлі також встановлено taint типу NoExecute, kubelet виселить Pod, якщо не встановлено відповідну toleration.
Ось приклад Podʼа, у якого визначено деякі tolerations:
Toleration «відповідає» taint, якщо ключі однакові та ефекти однакові, і:
operator — Exists (у цьому випадку не слід вказувати value), або
operator — Equal, а значення мають бути рівні.
Примітка:
Є два спеціальних випадки:
Якщо key порожній, то operator має бути Exists, що відповідає всім ключам і значенням. Зверніть увагу, що effect все одно має збігатися.
Порожній effect відповідає всім ефектам з ключем key1.
У наведеному вище прикладі використовувався effectNoSchedule. Також можна використовувати effectPreferNoSchedule.
Дозволені значення для поля effect:
NoExecute
Це впливає на Podʼи, які вже запущені на вузлі, таким чином:
Podʼи, які не толерують taint, негайно виселяються
Podʼи, які толерують taint, не вказуючи tolerationSeconds в їхній специфікації toleration, залишаються привʼязаними назавжди
Podʼи, які толерують taint із вказаним tolerationSeconds, залишаються привʼязаними протягом зазначеного часу. Після закінчення цього часу контролер життєвого циклу вузла виселяє Podʼи з вузла.
NoSchedule
На вузол із taint не буде заплановано нові Podʼи, якщо вони не мають відповідної toleration. Podʼи, які вже працюють на вузлі, не виселяються.
PreferNoSchedule
PreferNoSchedule — це «preference» або «soft» варіант NoSchedule. Панель управління спробує уникнути розміщення на вузлі Podʼа, який не толерує taint, але це не гарантовано.
На один вузол можна накласти кілька taints, а на один Pod — кілька tolerations. Kubernetes обробляє кілька taints і tolerations подібно до фільтра: спочатку беруться всі taints вузла, потім ігноруються ті, для яких Pod має відповідну toleration; решта неігнорованих taints мають зазначені ефекти на Pod. Зокрема,
якщо є принаймні один неігнорований taint з ефектом NoSchedule, тоді Kubernetes не буде планувати Pod на цей вузол
якщо немає неігнорованих taints з ефектом NoSchedule, але є принаймні один неігнорований taint з ефектом PreferNoSchedule, тоді Kubernetes спробує не планувати Pod на цей вузол
якщо є принаймні один неігнорований taint з ефектом NoExecute, тоді Pod буде виселено з вузла (якщо він вже працює на вузлі), і він не буде плануватися на вузол (якщо він ще не працює на вузлі).
Наприклад, уявіть, що ви накладаєте taint на вузол таким чином
У цьому випадку Pod не зможе плануватися на вузол, оскільки відсутня toleration, яка відповідає третьому taint. Але він зможе продовжувати працювати, якщо він вже працює на вузлі, коли до нього додається taint, оскільки третій taint — єдиний з трьох, який не толерується Podʼом.
Зазвичай, якщо до вузла додається taint з ефектом NoExecute, то будь-які Podʼи, які не толерують taint, будуть негайно виселені, а Podʼи, які толерують taint, ніколи не будуть виселені. Однак toleration з ефектом NoExecute може вказувати необовʼязкове поле tolerationSeconds, яке визначає, як довго Pod буде привʼязаний до вузла після додавання taint. Наприклад,
означає, що якщо цей Pod працює і до вузла додається відповідний taint, то Pod залишиться привʼязаним до вузла протягом 3600 секунд, а потім буде виселений. Якщо taint видаляється до цього часу, то Pod не буде виселений.
Оператори числового порівняння
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.35; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the TaintTolerationComparisonOperators feature gate for all relevant components in your cluster.
Окрім Equal та Exists, ви можете використовувати числові оператори порівняння (Gt та Lt) для зіставлення taints із цілими значеннями. Це корисно для планування на основі порогових значень, наприклад для зіставлення вузлів за рівнем надійності або рівнем SLA.
Gt спрацьовує, коли значення taint більше за значення toleration.
Lt спрацьовує, коли значення taint менше за значення toleration.
Для числових операторів значення toleration та taint повинні бути дійсними цілими числами. Якщо одне зі значень не може бути розібране як ціле число, toleration не збігається.
Примітка:
Коли ви створюєте Pod, який використовує оператори tolerations Gt або Lt, API-сервер перевіряє, чи є значення toleration дійсними цілими числами. Значення taint на вузлах не перевіряються під час реєстрації вузлів. Якщо вузол має нечислове значення taint (наприклад, servicelevel.organization.example/agreed-service-level=high:NoSchedule), Podʼи з числовими операторами порівняння не відповідатимуть цьому taint і не зможуть плануватися на цьому вузлі.
Наприклад, якщо на вузли накладено taint зі значенням, що представляє угоду про рівень обслуговування (SLA):
Ця toleration відповідає taint на node1, оскільки 950 > 900 (значення taint більше за значення toleration для оператора Gt). Аналогічно, ви можете використовувати оператор Lt для зіставлення taints, де значення taint менше за значення toleration:
Під час використання числових операторів порівняння:
Значення toleration та taint повинні бути дійсними 64-бітними цілими числами зі знаком (нульові цифри на початку (наприклад, "0550") не допускаються).
Якщо значення не може бути розібране як ціле число, toleration не збігається.
Числові оператори працюють з усіма ефектами taint: NoSchedule, PreferNoSchedule та NoExecute.
Для PreferNoSchedule з числовими операторами: якщо toleration Podʼа не задовольняє числове порівняння (наприклад, значення taint < значення toleration під час використання Gt), планувальник надає вузлу нижчий пріоритет, але все одно може планувати там, якщо немає кращих варіантів.
Попередження:
Перед вимкненням функціональної можливості TaintTolerationComparisonOperators:
Ви повинні ідентифікувати всі робочі навантаження, що використовують оператори Gt або Lt, щоб уникнути гарячих циклів контролера.
Оновіть усі шаблони контролерів робочих навантажень, щоб замість них використовувати оператори Equal або Exists.
Видаліть усі Podʼи в стані очікування, які використовують оператори Gt або Lt.
Стежте за метрикою apiserver_request_total, щоб виявити сплески помилок перевірки.
Приклади використання
Taints та tolerations є гнучким способом спрямовувати Podʼи геть від вузлів або виселяти Podʼи, які не повинні працювати. Деякі з варіантів використання:
Виділені вузли: Якщо ви хочете виділити певний набір вузлів для виключного використання конкретним набором користувачів, ви можете додати taint на ці вузли (наприклад, kubectl taint nodes nodename dedicated=groupName:NoSchedule) і потім додати відповідну toleration до їхніх Podʼів (це найпростіше зробити за допомогою власного контролера допуску). Podʼам із tolerations буде дозволено використовувати вузли з taints (виділені), а також будь-які інші вузли в кластері. Якщо ви хочете виділити вузли для них та забезпечити, щоб вони використовували лише виділені вузли, то вам слід додатково додати мітку, аналогічну taint, до того ж набору вузлів (наприклад, dedicated=groupName), і контролер допуску повинен додатково додати спорідненість вузлів, щоб вимагати, щоб Podʼи могли плануватися лише на вузли з міткою dedicated=groupName.
Вузли зі спеціальним обладнанням: У кластері, де невелика підмножина вузлів має спеціалізоване обладнання (наприклад, GPU), бажано утримувати Podʼи, які не потребують спеціалізованого обладнання, поза цими вузлами, щоб залишити місце для Podʼів, що надійдуть пізніше й дійсно потребують спеціалізованого обладнання. Це можна зробити, накладаючи taints на вузли зі спеціалізованим обладнанням (наприклад, kubectl taint nodes nodename special=true:NoSchedule або kubectl taint nodes nodename special=true:PreferNoSchedule) і додаючи відповідну toleration до Podʼів, які використовують спеціалізоване обладнання. Як і у випадку з виділеними вузлами, найпростіше застосовувати tolerations за допомогою власного контролера допуску. Наприклад, рекомендується використовувати Розширені ресурси
для представлення спеціального обладнання, накладати на вузли зі спеціальним обладнанням taint з назвою розширеного ресурсу і запускати контролер допуску ExtendedResourceToleration. Тепер, оскільки на вузлах є taints, жоден Pod без toleration не буде плануватися на них. Але коли ви надсилаєте Pod, який запитує розширений ресурс, контролер допуску ExtendedResourceToleration автоматично додасть правильну toleration до Podʼа і цей Pod буде плануватися на вузли зі спеціальним обладнанням. Це забезпечить, що ці вузли зі спеціальним обладнанням виділені для Podʼів, які запитують таке обладнання, і вам не потрібно вручну додавати tolerations до ваших Podʼів.
Виселення на основі taint: Поведінка виселення, що налаштовується для кожного Podʼа, коли є проблеми з вузлом, яка описана в наступному розділі.
Виселення на основі taint
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.18
Контролер вузлів автоматично накладає taint на вузол, коли виконуються певні умови. Вбудованими є такі taints:
node.kubernetes.io/not-ready: Вузол не готовий. Це відповідає тому, що NodeCondition Ready має значення "False".
node.kubernetes.io/unreachable: Вузол недоступний для контролера вузлів. Це відповідає тому, що NodeCondition Ready має значення "Unknown".
node.kubernetes.io/memory-pressure: На вузлі є тиск на памʼять.
node.kubernetes.io/disk-pressure: На вузлі є тиск на диск.
node.kubernetes.io/pid-pressure: На вузлі є тиск на PID.
node.kubernetes.io/network-unavailable: Мережа вузла недоступна.
node.kubernetes.io/unschedulable: Вузол непридатний для планування.
node.cloudprovider.kubernetes.io/uninitialized: Коли kubelet запускається із «зовнішнім» хмарним провайдером, цей taint накладається на вузол, щоб позначити його як непридатний до використання. Після того як контролер з cloud-controller-manager ініціалізує цей вузол, kubelet видаляє цей taint.
Якщо вузол потрібно очистити, контролер вузлів або kubelet додає відповідні taints з ефектом NoExecute. Цей ефект стандартно додається для taints node.kubernetes.io/not-ready та node.kubernetes.io/unreachable. Якщо стан несправності повертається до норми, kubelet або контролер вузлів можуть видалити відповідні taints.
У деяких випадках, коли вузол недоступний, API-сервер не може спілкуватися з kubelet на вузлі. Рішення про видалення Podʼів не може бути передане до kubelet, доки звʼязок з API-сервером не буде відновлено. Протягом цього часу Podʼи, які заплановані для видалення, можуть продовжувати працювати на розділеному вузлі.
Примітка:
Панель управління обмежує швидкість додавання нових taints на вузли. Це обмеження швидкості керує кількістю виселень, які спричиняються, коли одночасно недоступно багато вузлів (наприклад, якщо відбувається збій мережі).
Ви можете вказати tolerationSeconds для Podʼа, щоб визначити, як довго цей Pod залишається привʼязаним до несправного вузла або вузла, який не відповідає.
Наприклад, ви можете довго зберігати застосунок з великою кількістю локального стану, привʼязаного до вузла, у разі розділу мережі, сподіваючись, що розділ відновиться, і, таким чином, можна уникнути виселення Podʼа. Toleration, яку ви встановили для цього Podʼа, може виглядати так:
Kubernetes автоматично додає toleration для node.kubernetes.io/not-ready та node.kubernetes.io/unreachable з tolerationSeconds=300, якщо тільки ви або контролер не встановили ці tolerations явно.
Ці автоматично додані tolerations означають, що Podʼи залишаються привʼязаними до вузлів протягом 5 хвилин після виявлення однієї з цих проблем.
Podʼи DaemonSet створюються з tolerations NoExecute для таких taints без tolerationSeconds:
node.kubernetes.io/unreachable
node.kubernetes.io/not-ready
Це забезпечує, що Podʼи DaemonSet ніколи не будуть виселені через ці проблеми.
Примітка:
Контролер вузлів відповідав за додавання taints до вузлів і виселення Podʼів. Але після 1.29 реалізація виселення на основі taint була переміщена з контролера вузлів в окремий і незалежний компонент під назвою taint-eviction-controller. Користувачі можуть за бажанням вимкнути виселення на основі taint, встановивши --controllers=-taint-eviction-controller в kube-controller-manager.
Накладання taints на вузли за станами
Панель управління, використовуючи контролер вузла, автоматично створює taints з ефектом NoSchedule для станів вузла.
Планувальник перевіряє taints, а не стани вузла, коли він приймає рішення про планування. Це забезпечує те, що стани вузла не впливають безпосередньо на планування. Наприклад, якщо стан вузла DiskPressure активний, панель управління додає taint node.kubernetes.io/disk-pressure і не планує нові Podʼи на уражений вузол. Якщо стан вузла MemoryPressure активний, панель управління додає taint node.kubernetes.io/memory-pressure.
Ви можете ігнорувати стани вузла для новостворених Podʼів, додавши відповідні tolerations Podʼів. Панель управління також додає toleration node.kubernetes.io/memory-pressure на Podʼи, які мають клас якості обслуговування інший, ніж BestEffort. Це тому, що Kubernetes вважає Podʼи у класах QoS Guaranteed або Burstable (навіть Podʼи без встановленого запиту на памʼять) здатними впоратися з тиском на памʼять, тоді як нові Podʼи BestEffort не плануються на уражений вузол.
Контролер DaemonSet автоматично додає наступні tolerations NoSchedule для всіх демонів, щоб запобігти порушенню роботи DaemonSets.
node.kubernetes.io/memory-pressure
node.kubernetes.io/disk-pressure
node.kubernetes.io/pid-pressure (1.14 або пізніше)
node.kubernetes.io/unschedulable (1.10 або пізніше)
node.kubernetes.io/network-unavailable (тільки для мережі хоста)
Додавання цих tolerations забезпечує сумісність з попередніми версіями. Ви також можете додавати довільні tolerations до DaemonSets.
Taints та tolerations пристроїв
Замість того, щоб накладати taints на цілі вузли, адміністратори можуть також накладати taints на окремі пристрої, коли кластер використовує динамічне виділення ресурсів для керування спеціальним обладнанням. Перевага полягає у тому, що taint можна спрямувати саме на те обладнання, яке є несправним або потребує обслуговування. Tolerations також підтримуються, і їх можна вказувати під час запиту пристроїв. Як і taints, вони застосовуються до всіх Podʼів, які спільно використовують один і той самий виділений пристрій.
Фреймворк планування — це архітектура на основі втулків для планувальника Kubernetes. Вона складається з набору API «втулків», які компілюються безпосередньо в планувальник. Ці API дозволяють реалізувати більшість можливостей планування у вигляді втулків, зберігаючи при цьому «ядро» планування легким та зручним у підтримці. Для отримання більш технічної інформації про дизайн фреймворку зверніться до проєктної пропозиції фреймворку планування.
Робочий процес фреймворку
Фреймворк планування визначає кілька точок розширення. Втулки планувальника реєструються для виклику в одній або кількох таких точках розширення. Деякі з цих втулків можуть змінювати рішення щодо планування, а деякі є суто інформаційними.
Кожна спроба запланувати один Pod розділяється на дві фази: цикл планування та цикл привʼязки.
Цикл планування та цикл привʼязки
Цикл планування вибирає вузол для Podʼа, а цикл привʼязки застосовує це рішення до кластера. Разом цикл планування та цикл привʼязки називаються «контекстом планування».
Цикли планування виконуються послідовно, тоді як цикли привʼязки можуть виконуватися паралельно.
Цикл планування або привʼязки може бути перерваний, якщо виявлено, що Pod непридатний для планування, або якщо відбувається внутрішня помилка. Pod буде повернуто у чергу і спроба буде повторена.
Інтерфейси
Наступне зображення показує контекст планування Podʼа та інтерфейси, які надає фреймворк планування.
Один втулок може реалізовувати кілька інтерфейсів для виконання складніших завдань або завдань зі збереженням стану.
Деякі інтерфейси відповідають точкам розширення планувальника, які можна налаштувати через конфігурацію планувальника.
Точки розширення фреймворку планування
PreEnqueue
Ці втулки викликаються перед додаванням Podʼів до внутрішньої активної черги, де Podʼи відзначаються як готові до планування.
Тільки коли всі втулки PreEnqueue повертають Success, Pod допускається до активної черги. В іншому випадку він поміщається у внутрішній список непридатних для планування Podʼів і не отримує стан Unschedulable.
Для отримання докладнішої інформації про те, як працюють внутрішні черги планувальника, прочитайте Черга планування в kube-scheduler.
EnqueueExtension
EnqueueExtension — це інтерфейс, де втулок може контролювати, чи потрібно повторно спробувати планування Podʼів, відхилених цим втулком, на основі змін у кластері. Втулки, які реалізують PreEnqueue, PreFilter, Filter, Reserve або Permit, повинні реалізувати цей інтерфейс.
QueueingHint
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.34; (стандартно увімкнено)
More information about this feature
This is a stable feature in Kubernetes, and has been since version 1.34. It was first available in the v1.28 release.
QueueingHint — це функція зворотного виклику для вирішення того, чи можна повторно поставити Pod до активної черги або черги backoff. Вона виконується кожного разу, коли в кластері відбувається певний вид події або зміна. Коли QueueingHint виявляє, що подія може зробити Pod придатним для планування, Pod поміщається в активну чергу або чергу backoff, щоб планувальник повторно спробував запланувати Pod.
QueueSort
Ці втулки використовуються для сортування Podʼів у черзі планування. Втулок сортування черги, по суті, надає функцію Less(Pod1, Pod2). Одночасно може бути увімкнений лише один втулок сортування черги.
PreFilter
Ці втулки використовуються для попередньої обробки інформації про Pod або для перевірки певних умов, яким мають відповідати кластер або Pod. Якщо втулок PreFilter повертає помилку, цикл планування переривається.
Filter
Ці втулки використовуються для відфільтрування вузлів, на яких не можна запустити Pod. Для кожного вузла планувальник буде викликати втулки фільтрації в налаштованому порядку. Якщо будь-який втулок фільтра позначає вузол як непридатний, для цього вузла не буде викликано інші втулки. Оцінка вузлів може відбуватися паралельно.
PostFilter
Ці втулки викликаються після фази фільтрації, але лише тоді, коли не було знайдено жодного придатного вузла для Podʼа. Втулки викликаються в налаштованому порядку. Якщо будь-який втулок postFilter позначає вузол як Schedulable, інші втулки не будуть викликані. Типовою реалізацією PostFilter є витіснення, яка намагається зробити Pod придатним для планування, витісняючи інші Podʼи.
PreScore
Ці втулки використовуються для виконання «попередньої оцінки», яка генерує спільний стан для використання втулками Score. Якщо втулок попередньої оцінки повертає помилку, цикл планування переривається.
Score
Ці втулки використовуються для ранжування вузлів, які пройшли фазу фільтрації. Планувальник викликає кожен втулок оцінювання для кожного вузла. Існує чіткий діапазон цілих чисел, який представляє мінімальні та максимальні оцінки. Після фази NormalizeScore планувальник поєднує оцінки вузла з усіх втулків згідно з налаштованими вагами втулків.
Оцінка місткості
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.37; (стандартно увімкнено)
У версії 1.32 для підтримки сховищ зі статичним наданням використовувалася функціональна можливість VolumeCapacityPriority. Починаючи з версії 1.33, нова функціональна можливість StorageCapacityScoring замінює стару VolumeCapacityPriority з додатковою підтримкою сховищ з динамічним наданням. Коли StorageCapacityScoring увімкнено, втулок VolumeBinding у kube-scheduler розширено, щоб оцінювати вузли на основі місткості сховища на кожному з них. Ця можливість застосовується до томів CSI, які підтримують місткість сховища, включно з локальним сховищем, яке підтримується драйвером CSI.
NormalizeScore
Ці втулки використовуються для модифікації оцінок перед тим, як планувальник обчислить кінцеве ранжування вузлів. Втулок, який реєструється для цієї точки розширення, буде викликаний з результатами Score від того ж втулка. Це робиться один раз для кожного втулка на один цикл планування.
Наприклад, припустимо, що втулок BlinkingLightScorer ранжує вузли на основі того, скільки лампочок, що блимають, в них є.
Однак максимальна кількість лампочок, що блимають, може бути невеликою порівняно з NodeScoreMax. Щоб виправити це, BlinkingLightScorer також повинен реєструватися для цієї точки розширення.
Якщо будь-який втулок NormalizeScore повертає помилку, цикл планування припиняється.
Примітка:
Втулки, які бажають виконати «pre-reserve», повинні використовувати точку розширення NormalizeScore.
Reserve
Втулок, який реалізує інтерфейс Reserve, має два методи, а саме Reserve та Unreserve, які підтримують дві інформаційні фази планування, які називаються Reserve та Unreserve, відповідно. Втулки, які підтримують стан часу виконання (так звані «втулки зі станом»), повинні використовувати ці фази, щоб отримувати від планувальника сповіщення про те, що ресурси на вузлі резервуються або звільняються для вказаного Podʼа.
Фаза резервування (Reserve) відбувається перед тим, як планувальник фактично привʼязує Pod до призначеного вузла. Вона існує для запобігання станам гонитви, поки планувальник чекає на успішну привʼязку. Метод Reserve кожного втулка Reserve може бути успішним або невдалим; якщо один виклик методу Reserve не вдасться, наступні втулки не виконуються, і фаза резервування вважається невдалою. Якщо метод Reserve всіх втулків успішний, фаза резервування вважається успішною, виконується решта циклу планування та циклу привʼязки.
Фаза скасування резервування (Unreserve) спрацьовує, якщо фаза резервування або пізніша фаза виявиться невдалою. У такому випадку метод Unreserveвсіх втулків резервування буде виконано в порядку, зворотному до викликів методів Reserve. Ця фаза існує для очищення стану, повʼязаного з зарезервованим Podʼом.
Увага:
Реалізація методу Unreserve у втулках Reserve повинна бути ідемпотентною і не може зазнавати невдачі.
Permit
Втулки Permit викликаються в кінці циклу планування для кожного Podʼа, щоб запобігти або затримати привʼязку до вузла-кандидата. Втулок дозволу може робити одну з трьох речей:
approve Якщо всі втулки Permit схвалюють Pod, він відправляється для привʼязки.
deny Якщо будь-який втулок Permit відхиляє Pod, він повертається до черги планування. Це спричинить запуск фази Unreserve у втулках Reserve.
wait (із тайм-аутом) Якщо втулок Permit повертає «wait», тоді Pod залишається у внутрішньому списку Podʼів, що «очікують», і цикл привʼязки цього Podʼа починається, але безпосередньо блокується, поки він не буде схвалений. Якщо виникає тайм-аут, wait стає deny і Pod повертається до черги планування, спричиняючи запуск фази Unreserve у втулках Reserve.
Примітка:
Хоча будь-який втулок може мати доступ до списку Podʼів, що «очікують», та схвалювати їх (див. FrameworkHandle), ми очікуємо, що лише втулки Permit схвалюватимуть привʼязку зарезервованих Podʼів, які перебувають у стані «очікування». Після схвалення Podʼа він відправляється до фази PreBind.
PreBind
Ці втулки використовуються для виконання будь-яких необхідних операцій перед привʼязкою Podʼа. Наприклад, втулок PreBind може надавати мережевий том і монтувати його на цільовому вузлі перед тим, як дозволити Podʼу запускатися там.
Якщо будь-який втулок PreBind повертає помилку, Pod відхиляється і повертається до черги планування.
Bind
Ці втулки використовуються для привʼязки Podʼа до вузла. Втулки Bind не будуть викликані, поки всі втулки PreBind не завершаться. Кожен втулок привʼязки викликається в налаштованому порядку. Втулок привʼязки може вибрати, чи обробляти вказаний Pod. Якщо втулок привʼязки обирає Pod для опрацювання, решта втулків привʼязки пропускаються.
PostBind
Це інформаційний інтерфейс. Втулки PostBind викликаються після успішної привʼязки Podʼа. Це кінець циклу привʼязки, і його можна використати для очищення повʼязаних ресурсів.
API втулків
API втулків складається з двох кроків. По-перше, втулки повинні зареєструватися та отримати налаштування, а потім вони використовують інтерфейси точок розширення. Інтерфейси точок розширення мають такий вигляд.
Ви можете увімкнути або вимкнути втулки у конфігурації планувальника. Якщо ви використовуєте Kubernetes v1.18 або пізнішу версію, більшість втулків планування використовуються та є стандартно увімкненими.
Окрім стандартних втулків, ви також можете реалізувати власні втулки планування та налаштувати їх разом зі стандартними втулками. Ви можете дізнатися більше на scheduler-plugins.
Якщо ви використовуєте Kubernetes v1.18 або пізнішу версію, ви можете налаштувати набір втулків як профіль планувальника, а потім визначити кілька профілів для різних видів робочих навантажень. Дізнайтеся більше про кілька профілів.
9 - Групове планування
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the GenericWorkload feature gate for all relevant components in your cluster.
Групове планування забезпечує, щоб група Podʼів була запланована з дотриманням принципу «все або нічого». Якщо кластер не може вмістити всю групу (або визначену мінімальну кількість Podʼів, вказану в minCount), жоден з Podʼів не привʼязується до вузла.
Примітка:
Хоча під час початкового розміщення планувальник ніколи не допускає кількості Podʼів, меншої за налаштований параметр minCount, фактична кількість запланованих Podʼів під час виконання може опуститися нижче цього порогу, якщо запущені Podʼи згодом будуть видалені або виселені, або якщо вимога щодо minCount збільшиться. У такому випадку планувальник розміщуватиме додаткові Podʼи лише тоді, коли сумарна кількість уже запланованих Podʼів та нових незапланованих Podʼів, розміщення яких стало можливим, досягне або перевищить значення minCount.
Ця можливість залежить від PodGroup API. Переконайтесь, що увімкнено функціональну можливість GenericWorkload та групу APIscheduling.k8s.io/v1beta1 у кластері.
Як це працює
Коли втулок GangScheduling увімкнено, планувальник змінює життєвий цикл Podʼів, що належать до PodGroup, для якого встановлено політику планування типу gang. Для кожного PodGroup цей процес відбувається за такими кроками:
Планувальник утримує Podʼи у фазі PreEnqueue, доки:
Вказаний обʼєкт PodGroup існує.
Кількість Podʼів, створених для PodGroup (як уже запланованих, так і незапланованих), принаймні дорівнює minCount.
PodGroup не потрапляє до активної черги планування, доки не будуть виконані обидві умови.
Після досягнення кворуму планувальник намагається знайти розміщення для всіх незапланованих Podʼів у групі. Він використовує цикл планування PodGroup, щоб прийняти одне, атомарне рішення щодо планування. Втулок GangScheduling реалізує точку розширення PlacementFeasible, яка викликається для кожного оцінюваного Podʼа під час циклу. Це використовується, щоб визначити, чи виконується обмеження minCount, шляхом порівняння кількості успішно розміщених Podʼів (включно з тими, що вже були заплановані в попередніх циклах) зі значенням minCount.
Якщо планувальник знаходить дійсні розміщення щонайменше для minCount Podʼів, він дозволяє цим успішно розміщеним Podʼам привʼязатися до призначених їм вузлів. Якщо він не може знайти достатньо розміщень для задоволення вимоги minCount, жоден з Podʼів не планується. Натомість вони переміщуються до черги непридатних для планування Podʼів, щоб чекати на звільнення ресурсів кластера, що дозволяє тим часом планувати інші робочі навантаження.
Ієрархічне групове планування з CompositePodGroups
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the CompositePodGroup feature gate for all relevant components in your cluster.
Коли увімкнено функціональну можливість CompositePodGroup та групу APIscheduling.k8s.io/v1alpha3, групове планування поширює свою підтримку на CompositePodGroups.
На відміну від PodGroups, які групують Podʼи, CompositePodGroups групують дочірні групи разом — або PodGroups, або інші CompositePodGroups. CompositePodGroup визначає політику планування, яка застосовується до його дочірніх груп під час планування:
політика gang з полем minGroupCount, яке вказує мінімальну кількість дочірніх груп (або обʼєктів CompositePodGroup, або PodGroup), які повинні бути заплановані разом як єдиний атомарний блок.
політика basic, яка вказує, що дочірні групи можна планувати незалежно.
Політика gang корисна для багатокомпонентних робочих навантажень, які потребують планування «все або нічого» для кількох дочірніх груп, забезпечуючи, що мінімальна кількість дочірніх груп планується разом. Прикладом робочого навантаження з такими потребами є репліковане навчання AI.
Політика basic може використовуватися для робочих навантажень, що складаються з кількох груп Podʼів, кожну з яких можна планувати як незалежну групу, наприклад, для робочих навантажень інференсу AI.
Ієрархічний кворум
Втулок GangScheduling затримує потрапляння кореневого обʼєкта CompositePodGroup до активної черги планування на етапі PreEnqueue доти, доки він не задовольнить вимоги ієрархічного кворуму. Цей кворум оцінюється знизу вгору — від кінцевих обʼєктів PodGroup аж до кореневого обʼєкта CompositePodGroup:
Кінцевий PodGroupзадовольняє кворум тоді і лише тоді, коли обʼєкт PodGroup існує та може потенційно задовольнити критерії своєї політики планування:
Для політики gang: принаймні minCount його складових Podʼів було створено.
Для політики basic: принаймні один з його складових Podʼів було створено.
CompositePodGroupзадовольняє кворум тоді і лише тоді, коли обʼєкт CompositePodGroup існує та може потенційно задовольнити критерії своєї політики планування:
Для політики gang: принаймні minGroupCount його безпосередніх дочірніх груп задовольняють кворум.
Для політики basic: принаймні одна з його безпосередніх дочірніх груп задовольняє кворум.
Загальний ієрархічний кворум задовольняється тоді і лише тоді, коли кореневий CompositePodGroup задовольняє кворум.
Зрештою, кореневий CompositePodGroup допускається до активної черги планування тоді і лише тоді, коли він задовольняє ієрархічний кворум та існує щонайменше один Pod, що очікує на планування та належить до одного з його нащадків PodGroups.
Здійсненність розміщення
Метод PlacementFeasible втулка GangScheduling підтримує оцінювання як для PodGroups, так і для CompositePodGroups. Він викликається циклом планування до початку оцінювання дочірніх груп та після оцінювання кожної дочірньої групи CompositePodGroup.
З урахуванням кількості дочірніх груп, які були успішно заплановані, та дочірніх груп, які ще не були оцінені в поточному циклі планування, PlacementFeasible визначає, чи обмеження політики групи все ще може бути досягнуте, дозволяючи циклу планування достроково припинити оцінювання CompositePodGroup, якщо його основна політика планування вже не може бути задоволена.
kube-scheduler — стандартний планувальник для Kubernetes. Він відповідає за розміщення Podʼів на вузлах кластера.
Вузли кластера, які відповідають вимогам планування Podʼа, називаються придатними (feasible) вузлами для Podʼа. Планувальник знаходить придатні вузли для Podʼа, а потім виконує набір функцій для оцінки цих вузлів, вибираючи вузол з найвищою оцінкою серед придатних для запуску Podʼа. Потім планувальник повідомляє API-сервер про це рішення в процесі, що називається привʼязкою (Binding).
На цій сторінці пояснюються оптимізації налаштування продуктивності, які є актуальними для великих кластерів Kubernetes.
У великих кластерах ви можете налаштувати роботу планувальника, збалансовуючи результати планування між часом відгуку (нові Podʼи розміщуються швидко) та точністю (планувальник рідко приймає погані рішення про розміщення).
Це налаштування задається через параметр kube-scheduler percentageOfNodesToScore. Цей параметр KubeSchedulerConfiguration визначає поріг для планування вузлів у вашому кластері.
Налаштування порога
Опція percentageOfNodesToScore приймає цілі числові значення від 0 до 100. Значення 0 є спеціальним числом, яке позначає, що kube-scheduler повинен використовувати вбудоване стандартне значення. Якщо ви встановлюєте percentageOfNodesToScore більше 100, kube-scheduler діє так, ніби ви встановили значення 100.
Щоб змінити значення, відредагуйте файл конфігурації kube-scheduler і перезапустіть планувальник. У багатьох випадках файл конфігурації можна знайти за шляхом /etc/kubernetes/config/kube-scheduler.yaml.
Після внесення цих змін ви можете виконати
kubectl get pods -n kube-system | grep kube-scheduler
щоб перевірити, що компонент kube-scheduler працює належним чином.
Поріг оцінки вузлів
Для поліпшення продуктивності планування kube-scheduler може припинити пошук придатних вузлів, як тільки він знайде їх достатню кількість. У великих кластерах це заощаджує час порівняно з підходом, який би враховував кожен вузол.
Ви вказуєте поріг для того, яка кількість вузлів є достатньою, як цілий відсоток від усіх вузлів у вашому кластері. Kube-scheduler перетворює це в ціле число вузлів. Під час планування, якщо kube-scheduler визначив достатню кількість придатних вузлів, щоб перевищити налаштований відсоток, він припиняє пошук додаткових придатних вузлів і переходить до фази оцінки.
Якщо ви не вказуєте поріг, Kubernetes розраховує значення за допомогою лінійної формули, яка дає 50% для кластера зі 100 вузлами та 10% для кластера з 5000 вузлів. Нижня межа для автоматичного значення — 5%.
Це означає, що kube-scheduler завжди оцінює принаймні 5% вашого кластера, незалежно від розміру кластера, якщо ви явно не встановили percentageOfNodesToScore менше ніж 5.
Якщо ви хочете, щоб планувальник оцінював всі вузли у вашому кластері, встановіть percentageOfNodesToScore на 100.
Приклад
Нижче наведено приклад конфігурації, яка встановлює percentageOfNodesToScore на 50%.
percentageOfNodesToScore повинен бути значенням від 1 до 100, а стандартне значення розраховується на основі розміру кластера. Також існує жорстко задане мінімальне значення в 100 вузлів.
Примітка:
У кластерах з менш ніж 100 придатними вузлами планувальник все ще перевіряє всі вузли, тому що недостатньо придатних вузлів для того, щоб рано зупинити пошук планувальника.
У малому кластері, якщо ви встановите низьке значення для percentageOfNodesToScore, ваші зміни майже не матимуть ефекту або не матимуть його зовсім, зі схожої причини.
Якщо у вашому кластері кілька сотень вузлів або менше, залиште цю опцію конфігурації у стандартному значенні. Внесення змін навряд чи суттєво покращить продуктивність планувальника.
Важливою деталлю, яку слід врахувати під час встановлення цього значення, є те, що коли на придатність перевіряється менша кількість вузлів кластера, деякі вузли не надсилаються на оцінку для цього Podʼа. В результаті вузол, який міг би отримати вищу оцінку для запуску цього Podʼа, може навіть не потрапити до фази оцінки. Це призведе до менш ідеального розміщення Podʼа.
Вам слід уникати встановлення percentageOfNodesToScore дуже низьким, щоб kube-scheduler не приймав часто погані рішення щодо розміщення Podʼа. Уникайте встановлення відсотка нижче 10%, якщо тільки пропускна здатність планувальника не є критичною для вашого застосунку та оцінка вузлів не є важливою. Іншими словами, ви віддаєте перевагу запуску Podʼа на будь-якому вузлі, який буде придатним.
Як планувальник проходиться по вузлах
Цей розділ призначений для тих, хто бажає зрозуміти внутрішні деталі цієї можливості.
Щоб всі вузли кластера мали рівні можливості бути враховані для запуску Podʼів, планувальник проходиться по вузлах по колу. Ви можете уявити, що вузли розташовані в масиві. Планувальник починає з початку масиву вузлів і перевіряє придатність вузлів, поки не знайде достатню кількість вузлів, як вказано у percentageOfNodesToScore. Для наступного Podʼа планувальник продовжує з точки в масиві вузлів, де він зупинився під час перевірки придатності вузлів для попереднього Podʼа.
Якщо вузли розташовані в кількох зонах, планувальник проходиться по вузлах у різних зонах, щоб вузли з різних зон враховувалися під час перевірок придатності. Наприклад, розгляньте шість вузлів у двох зонах:
Zone 1: Node 1, Node 2, Node 3, Node 4
Zone 2: Node 5, Node 6
Планувальник оцінює придатність вузлів у такому порядку:
Node 1, Node 5, Node 2, Node 6, Node 3, Node 4
Після проходження всіх вузлів він повертається до вузла 1.
Увімкнення опортуністичної пакетної обробки
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.35; (стандартно увімкнено)
Під час планування великих робочих навантажень Podʼи часто мають еквівалентні обмеження планування та вимагають від планувальника виконання одних і тих же операцій знову і знову. Можливість Opportunistic Batching дозволяє планувальнику повторно використовувати результати фільтрації та оцінювання між циклами планування, що значно прискорює процес планування.
Завдяки повторній оцінці планувальник може продовжувати пакетну обробку в такій ситуації. Коли наступний Pod все ще може розміститися на раніше обраному вузлі, планувальник оновлює оцінку цього вузла та повертає його до кешованого списку кандидатів. Якщо повторна оцінка не вдається, планувальник повертається до наявної поведінки та очищає кеш.
Загалом ця можливість працює так:
Планувальник планує pod-1 і кешує результат планування.
Планувальник планує pod-2, 3, ... з кешованими результатами.
Термін дії кешу спливає через 0,5 секунди. Планувальник планує наступний Pod, який створює новий кеш.
Podʼи з еквівалентними обмеженнями планування мають надходити до циклу планування один за одним. Коли планувальник планує Pod з іншими обмеженнями, кеш не використовується, а замінюється новим.
Ми застосовуємо це пакетне планування до конкретних Podʼів, які:
Не мають спорідненості/антиспорідненості між Podʼами
Не мають обмежень топології розміщення
Не мають DRA (тобто не мають жодних ResourceClaims)
Не запитують розширені ресурси, які підтримуються DRA
Також, щоб увімкнути цю можливість, конфігурація планувальника повинна:
Встановити IgnorePreferredTermsOfExistingPodsInterPodAffinityArgs на true, щоб зробити пакетну обробку більш ефективною
Зверніть увагу, що в таких випадках:
Наявні Podʼи використовують обмеження спорідненості Podʼів, які відповідають будь-яким міткам запланованих Podʼів, можливість може не принести користі.
Використовуються власні втулки, які повинні реалізовувати точку розширення Signature.
Очікується, що обмеження та умови будуть змінюватися в майбутніх версіях.
11 - Витіснення з урахуванням робочого навантаження
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the GenericWorkload feature gate for all relevant components in your cluster.
У v1.36 логіка витіснення з урахуванням робочого навантаження вмикалася функціональною можливістю WorkloadAwarePreemption. Цю функціональну можливість було обʼєднано з функціональною можливістю GenericWorkload у v1.37.
Витіснення з урахуванням робочого навантаження (Workload-aware preemption) вводить механізм витіснення, спеціально розроблений для PodGroups. Коли PodGroup не може бути запланований, планувальник використовує логіку витіснення, яка намагається зробити можливим планування цього PodGroup. Цей підхід використовується виключно під час планування PodGroup і замінює стандартний механізм витіснення для Podʼів із цього PodGroup.
Коли ця можливість увімкнена, планувальник розглядає PodGroup як єдиний блок витіснення, а не оцінює окремі Podʼи з PodGroup окремо. Щоб звільнити місце для Podʼів групи, що очікують, він шукає жертви по всьому кластеру і знає, як обробляти та витісняти інші PodGroups як жертви відповідно до їхніх режимів порушення.
Процес витіснення з урахуванням робочого навантаження дотримується тих самих принципів, що й стандартне витіснення, з кількома відмінностями:
Домен по всьому кластеру: Замість оцінки витіснення вузол за вузлом, планувальник оцінює весь кластер як єдиний домен. Він обирає набір жертв на кількох вузлах, які можна видалити, щоб звільнити достатньо місця для планування PodGroup-витіснювача.
Ієрархія важливості жертв: Планувальник визначає, які одиниці витіснення (окремі Podʼи або PodGroups) є більш критичними і повинні бути захищені від витіснення, використовуючи сувору ієрархію:
Пріоритет: Одиниці з вищим пріоритетом завжди важливіші.
Тип робочого навантаження: PodGroups вважаються важливішими за окремі Podʼи з тим самим пріоритетом.
Розмір групи (PodGroups): Якщо обидві одиниці є PodGroups, той, що має більше членів (більший розмір), вважається важливішим.
Час запуску: Одиниці, які були запущені раніше, є важливішими.
Пріоритет і режим порушення групи Podʼів: Планувальник враховує конкретний пріоритет і режим порушення PodGroup для оцінки того, чи можна витісняти його Podʼи під час подій витіснення і як саме.
Міркування щодо продуктивності та оптимальності: З міркувань продуктивності витіснення з урахуванням робочого навантаження спочатку симулює видалення всіх потенційних жертв і виконує планування один раз. Потім воно намагається помилувати якомога більше жертв для обраного розміщення. Цей компроміс означає, що може існувати альтернативне розміщення, яке спричиняє менше витіснень, але воно не вибирається планувальником через міркування продуктивності.
Примітка:
Під час планування одного Podʼа застосовується стандартне витіснення Podʼів. У v1.36, коли планувальник виконує стандартне витіснення для одного Podʼа і намагається витіснити Pod, що належить до PodGroup, він не враховує поля priority або disruptionMode цього PodGroup. Це обмеження більше не застосовується у v1.37.
Алгоритм помилування
Під час виконання витіснення з урахуванням робочого навантаження планувальник запускає симуляцію, у якій він видаляє потенційних жертв витіснення та виконує алгоритм планування групи Podʼів. Потім він намагається помилувати якомога більше жертв для такого розміщення. Для цього планувальник повторно використовує CycleStates з планування групи Podʼів. Для кожної з потенційних жертв, відсортованих за їх важливістю, планувальник:
Додає Podʼи-жертви назад до їхніх вузлів та CycleStates Podʼів-витіснювачів.
Для кожного Podʼа в PodGroup (у тому ж порядку, що й в алгоритмі планування):
Запускає втулки Filter для Podʼа на його запропонованому вузлі
Додає Pod до його запропонованого вузла
Запускає втулки Reserve для Podʼа на його запропонованому вузлі
Якщо для кожного Podʼа фільтрація проходить успішно, Podʼи-жертви залишаються на своїх вузлах.
Якщо фільтрація не вдається принаймні для одного Podʼа, Podʼи-жертви видаляються з CycleStates та вузла.
В обох випадках планувальник видаляє Podʼи-витіснювачі з їхніх вузлів і викликає їх Unreserve, щоб наступна спроба помилування могла перевірити планування PodGroup. Потім планувальник переходить до іншої потенційної жертви, доки всі жертви не будуть оброблені.
Витіснення для CompositePodGroups
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the CompositePodGroup feature gate for all relevant components in your cluster.
Коли функціональну можливість CompositePodGroup та групу APIscheduling.k8s.io/v1alpha3 увімкнено, витіснення з урахуванням робочого навантаження також забезпечує підтримку CompositePodGroups.
Базовий механізм витіснення такий самий, як і для PodGroups — якщо планувальнику потрібно звільнити місткість, щоб розмістити кореневий CompositePodGroup, він оцінює витіснення для всієї ієрархії груп, а не для окремих Podʼів.
CompositePodGroups також можуть бути обрані як жертви витіснення. Процес вибору жертв скориговано, щоб враховувати CompositePodGroups наступним чином:
Ієрархія важливості жертв:
CompositePodGroups вважаються важливішими за окремі PodGroups з тим самим пріоритетом.
Для двох CompositePodGroups з однаковим пріоритетом важливішим вважається той, що має більше членів (більший розмір).
Режим порушення: Подібно до PodGroups, CompositePodGroups вказують режим порушення, який визначає, як слід обробляти їхні дочірні групи під час витіснення.
Окрім витіснення з урахуванням робочого навантаження, CompositePodGroups можуть бути обрані як жертви витіснення стандартним витісненням Podʼів під час циклу планування Podʼів, поряд із PodGroups та Podʼами. Стандартне витіснення Podʼів поділяє логіку ієрархії важливості жертв із витісненням з урахуванням робочого навантаження та враховує поле disruptionModeCompositePodGroups.
Ця стаття стосується пакування ресурсів у контексті планування одного Podʼа. Для пакування ресурсів під час планування груп Podʼів, будь ласка, прочитайте статтю про планування з урахуванням топології.
У втулку плануванняNodeResourcesFit kube-scheduler є дві стратегії оцінювання, які підтримують пакування ресурсів: MostAllocated та RequestedToCapacityRatio.
Увімкнення пакування ресурсів за допомогою стратегії MostAllocated
Стратегія MostAllocated оцінює вузли на основі використання ресурсів, віддаючи перевагу тим, у яких виділення вище. Для кожного типу ресурсів ви можете встановити вагу, щоб змінити його вплив на оцінку вузла.
Щоб встановити стратегію MostAllocated для втулка NodeResourcesFit, використовуйте конфігурацію планувальника, подібну до наступної:
За допомогою цієї конфігурації вузли оцінюються за зваженим середнім використанням усіх чотирьох ресурсів. Оскільки intel.com/foo та intel.com/bar мають вагу 3 порівняно з 1 для CPU та памʼяті, використання цих розширених ресурсів має втричі більший вплив на кінцеву оцінку вузла. Планувальник обирає вузол з найвищою оцінкою, прагнучи розміщувати Podʼи на вузлах з високим використанням ресурсів. Це допомагає підготуватися до зменшення кількості найменш використовуваних вузлів.
Щоб дізнатися більше про інші параметри та їх стандартну конфігурацію, див. документацію API для NodeResourcesFitArgs.
Увімкнення пакування ресурсів за допомогою стратегії RequestedToCapacityRatio
Стратегія RequestedToCapacityRatio дозволяє користувачам вказати ресурси разом з вагами для кожного ресурсу для оцінювання вузлів на основі відношення запиту до місткості. Це дозволяє користувачам пакувати розширені ресурси, використовуючи відповідні параметри для покращення використання дефіцитних ресурсів у великих кластерах. Вона віддає перевагу вузлам згідно з налаштованою функцією виділених ресурсів. Поведінкою RequestedToCapacityRatio в функції оцінювання NodeResourcesFit можна керувати за допомогою поля scoringStrategy. У межах поля scoringStrategy ви можете налаштувати два параметри: requestedToCapacityRatio та resources. Параметр shape в requestedToCapacityRatio дозволяє користувачу налаштувати функцію як least requested або most requested на основі значень utilization та score. Параметр resources охоплює як name ресурсу, що враховується під час оцінювання, так і відповідну weight, яка визначає вагу кожного ресурсу.
Нижче наведено приклад конфігурації, яка встановлює поведінку пакування для розширених ресурсів intel.com/foo та intel.com/bar за допомогою поля requestedToCapacityRatio.
В цьому прикладі лише розширені ресурси intel.com/foo та intel.com/bar зазначені в resources. Тому втулок NodeResourcesFit оцінює вузли виключно на основі використання цих двох ресурсів; CPU та памʼять не впливають на оцінку від цього втулка. Оскільки налаштована shape присвоює вищу оцінку зі збільшенням використання (score: 0 за utilization: 0, зростаючи до score: 10 за utilization: 100), планувальник віддає перевагу вузлам, де більше цих розширених ресурсів вже використовується, пакуючи запити на них на якомога меншу кількість вузлів.
Щоб включити CPU та памʼять у цю стратегію оцінювання, додайте їх до списку resources. Зверніть увагу, що всі ресурси в списку використовують одну й ту ж функцію shape, тому це застосує ту саму криву пакування до цих ресурсів.
Посилання на файл KubeSchedulerConfiguration з прапорцем kube-scheduler --config=/path/to/config/file передасть конфігурацію планувальнику.
Щоб дізнатися більше про інші параметри та їх стандартну конфігурацію, див. документацію API для NodeResourcesFitArgs.
Налаштування функції оцінювання
Параметр shape використовується для визначення поведінки функції RequestedToCapacityRatio.
Вищезазначені аргументи надають вузлу score 0, якщо utilization дорівнює 0%, та 10 для utilization 100%, що дозволяє пакування ресурсів. Щоб увімкнути least requested, значення оцінки потрібно обернути таким чином.
Параметр weight є необовʼязковим та встановлюється в 1, якщо його не вказано. Також weight не може бути відʼємним.
Оцінка вузла для розподілу місткості
Цей розділ призначений для тих, хто бажає зрозуміти внутрішні деталі цієї можливості. Нижче наведено приклад того, як обчислюється оцінка вузла для заданого набору значень.
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the GenericWorkload feature gate for all relevant components in your cluster.
Стандартний планувальник Kubernetes оцінює Podʼи послідовно. Коли кілька робочих навантажень, таких як завдання машинного навчання, подаються одночасно, ця послідовна оцінка може призвести до взаємних блокувань ресурсів. Наприклад, кожне з двох конкуруючих робочих навантажень може запланувати підмножину своїх Podʼів, споживаючи місткість кластера, але не залишаючи жодному з них достатньо ресурсів для повного запуску.
Цикл планування PodGroup оцінює групу Podʼів як єдине ціле. Планувальник намагається знайти розміщення для всіх Podʼів у групі одночасно. Якщо він не може знайти достатньо ресурсів для задоволення вимог усієї групи, жоден з Podʼів не буде привʼязаний до вузла.
Крім того, розгляд групи як єдиного цілого створює фундаментальну архітектуру, яка спрощує реалізацію інших можливостей планування на основі груп.
Ця можливість залежить від Workload API. Переконайтеся, що у кластері увімкнено групу APIscheduling.k8s.io/v1beta1.
Цикл планування PodGroup
Щоб підтримати планування групи Podʼів разом, kube-scheduler використовує цикл планування PodGroup. Замість обробки Podʼів окремо та утримання їх на етапі WaitOnPermit, планувальник оцінює всю групу Podʼів, що очікують і належать до конкретного PodGroup, колективно. Замість виконання окремих циклів планування для кожного Podʼа він оцінює здійсненність для всієї групи, а потім переходить безпосередньо до фази привʼязки.
Коли планувальник виявляє Pod, що належить до PodGroup, він повʼязує цей Pod із цим PodGroup, а не додає його безпосередньо до черги планування. PodGroup не потрапляє до черги планування, доки планувальник не виявить як обʼєкт PodGroup, так і принаймні один Pod, що належить до нього. Коли планувальник вибирає PodGroup, він отримує всі виявлені незаплановані Podʼи в цій групі. Потім він сортує їх детерміновано за пріоритетом та часом, коли вони були вперше виявлені планувальником, і ініціює цикл планування PodGroup таким чином:
Знімок стану кластера: Коли планувальник починає оцінювати PodGroup, він робить один знімок стану кластера, який зберігається протягом усього циклу. Це забезпечує консистентність оцінки для всієї групи та запобігає станам гонитви з іншими подіями.
Пошук здійсненних розміщень: Планувальник запускає алгоритм планування PodGroup, щоб знайти дійсні розміщення на вузлах для Podʼів у групі.
Атомарне рішення: Залежно від результату алгоритму, рішення про планування застосовується атомарно для всього PodGroup.
Success: Якщо планувальник знаходить достатньо ресурсів та дійсні розміщення для Podʼів (наприклад, задовольняючи обмеження minCount для групового планування), ці Podʼи переходять безпосередньо до циклу привʼязки до обраних вузлів. Будь-які залишкові непридатні для планування Podʼи в групі повторно ставляться безпосередньо в активну чергу планування без backoff, зберігаючи свою попередню мітку часу, щоб вони були негайно переоцінені для спроби витіснення.
Крім того, якщо до PodGroup додаються нові Podʼи, після того як інші вже були заплановані, цикл оцінює нові Podʼи, враховуючи вже наявні.
Failure: Якщо планувальник не може знайти достатньо ресурсів, щоб PodGroup став здійсненним (наприклад, не вдається задовольнити обмеження minCount), весь PodGroup вважається непридатним для планування.
Планувальник намагається зробити PodGroup придатним для планування, запускаючи точку розширення PodGroupPostFilter. Точка розширення PodGroupPostFilter втулка DefaultPreemption виконує витіснення з урахуванням робочого навантаження. Якщо будь-який втулок, що реалізує точку розширення PodGroupPostFilter, повертає Success, жодні інші втулки для точки розширення PodGroupPostFilter не виконуються.
Навіть коли втулок PodGroupPostFilter повертає Success, жоден Pod не привʼязується до вузла; натомість усі повертаються до черги планування в надії, що дії, виконані PodGroupPostFilter, зроблять PodGroup придатним для планування в наступному циклі. Застосовується стандартна логіка backoff планування, що дозволяє повторити спробу пізніше.
Використовуючи цей підхід з одним циклом, планувальник уникає неефективних вузьких місць, коли частково заплановані групи резервують ресурси кластера, чекаючи невизначено довго, поки решта їх групи не зможе розміститися.
Алгоритм планування PodGroup
Стандартний алгоритм планування PodGroup значною мірою покладається на базовий алгоритм планування на основі Podʼів. Він послідовно обробляє всі Podʼи і для кожного з них виконує таке:
Знаходить придатний вузол за допомогою стандартних фаз фільтрації та оцінки для кожного Podʼа.
Якщо Pod підходить, він тимчасово призначається та резервується на обраному вузлі до завершення роботи алгоритму планування.
Якщо Pod не підходить, планувальник не запускає точку розширення PostFilter. Натомість він покладається на точку розширення PodGroupPostFilter, яка виконується для всього PodGroup.
Перевіряє, чи відповідають придатні для планування Podʼи критеріям планування групи (наприклад, minCount для групового планування), викликаючи точку розширення PlacementFeasible після оцінки кожного Podʼа в групі на основі сукупних результатів планування. Якщо для будь-якого Podʼа повертається статус Success, PodGroup вважається здійсненним. Якщо алгоритм обробляє всі Podʼи без досягнення статусу Success або якщо під час цього циклу не заплановано жодного Podʼа, PodGroup вважається непридатним для планування.
Алгоритм планування розміщення
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.36; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the TopologyAwareWorkloadScheduling feature gate for all relevant components in your cluster.
Алгоритм планування розміщення є альтернативним алгоритмом планування PodGroup, який використовує втулки планування для знаходження оптимального розміщення для розглянутого PodGroup. Користувачі можуть адаптувати алгоритм до своїх конкретних потреб, використовуючи та налаштовуючи втулки.
Алгоритм проходить три основні фази для цього PodGroup:
Фаза 1: Генерація кандидатів на розміщення
Генерує кандидатів на розміщення (підмножини вузлів, які теоретично можуть бути придатними для призначення PodGroup), наприклад, на основі обмежень планування PodGroup (які можуть бути визначені в обʼєкті PodGroup).
Ця фаза виконується в точці розширення PlacementGeneratePlugin.
Фаза 2: Фільтрація на рівні Podʼів і перевірка здійсненності
Перевіряє кожне запропоноване розміщення, запускаючи стандартний алгоритм планування PodGroup, щоб визначити, чи можна розмістити необхідну кількість Podʼів з PodGroup. Якщо це можливо, розміщення позначається як здійсненне.
Фаза 3: Оцінка та вибір розміщення
Оцінює всі здійсненні розміщення, щоб вибрати оптимальний домен для PodGroup.
Ця фаза виконується в точці розширення PlacementScorePlugin.
Обмеження
Алгоритм планування PodGroup покладається на специфічне сортування Podʼів і може не знайти дійсне розміщення, яке могло б бути виявлене під час обробки Podʼів групи в іншому порядку. Зокрема:
Для базових однорідних груп Podʼів (тобто тих, де всі Podʼи мають однакові вимоги до планування і не мають взаємозалежностей між Podʼами, таких як спорідненість, антиспорідненість або обмеження топології розміщення), очікується, що алгоритм знайде розміщення, якщо воно існує.
Для різнорідних груп Podʼів знаходження відповідного розміщення не гарантується.
Для груп Podʼів із взаємозалежностями між Podʼами знаходження відповідного розміщення не гарантується.
На додаток до вищезазначеного, у випадках, що включають взаємозалежності всередині групи (наприклад, коли можливість планування одного Podʼа залежить від іншого члена групи через спорідненість між Podʼами), цей алгоритм може не знайти розміщення незалежно від стану кластера через його детермінований порядок обробки.
Для забезпечення послідовної роботи протягом усього циклу алгоритм вимагає, щоб усі Podʼи, що належать до одного PodGroup, мали однакове поле .spec.schedulerName. Ця вимога перевіряється перед початком циклу, і PodGroup відхиляється, якщо ця умова не виконується.
Ієрархічне планування з CompositePodGroups
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the CompositePodGroup feature gate for all relevant components in your cluster.
Коли функціональну можливість CompositePodGroup та групу APIscheduling.k8s.io/v1alpha3 увімкнено, планувальник розширює цикл планування PodGroup для підтримки багаторівневих ієрархій груп.
В ієрархічному робочому навантаженні Podʼи належать до кінцевих обʼєктів PodGroup, які, своєю чергою, вказують батьківські ресурси CompositePodGroup аж до кореневого CompositePodGroup. Планувальник оцінює всю ієрархію груп як єдину, уніфіковану одиницю планування.
Виконання циклу ієрархічного планування
Після спостереження кореневого CompositePodGroup планувальник розміщує його в черзі планування, доки існує принаймні один Pod, що очікує та належить до ієрархії груп цього кореня.
Щойно кореневий CompositePodGroup задовольняє ієрархічний кворум, він потрапляє в активну чергу планування, з якої його може витягнути цикл планування. Цикл планування для CompositePodGroups виглядає так:
Уніфікований знімок кластера та перевірка: Планувальник робить знімок ресурсів кластера, щоб відобразити останній спостережений стан кластера. Він перевіряє, що форма ієрархії груп, витягнутої з черги, збігається зі знімком ієрархії, та перевіряє узгодженість конфігурації ієрархії (таку як однакові .spec.schedulerName та пріоритет серед Podʼів-членів).
Якщо форма ієрархії змінилася одночасно або не пройшла перевірку, цикл зупиняється та повторно ставить кореневий CompositePodGroup у чергу.
Генерація кандидатів на розміщення зверху вниз: На кожному рівні ієрархії, перед оцінкою дочірніх груп, планувальник викликає втулки PlacementGeneratePlugin, щоб згенерувати кандидатів на розміщення (підмножини вузлів) для групи, що оцінюється.
Кандидати на розміщення для дочірнього CompositePodGroup або кінцевого PodGroup генеруються виключно з підмножини вузлів, що належать до поточного оцінюваного розміщення батьківської групи. Для кореневого CompositePodGroup кандидати на розміщення генеруються по всіх доступних вузлах кластера.
Рекурсивна симуляція піддерева та перевірка здійсненності: Планувальник оцінює кожного кандидата на розміщення для CompositePodGroup, тимчасово припускаючи це розміщення у знімку кластера та рекурсивно плануючи його дочірні групи:
Рекурсивний обхід: Планувальник обходить дочірні групи в попередньо відсортованому порядку, викликаючи себе рекурсивно від CompositePodGroup вниз до кінцевих обʼєктів PodGroup. Для кожного кінцевого PodGroup планувальник запускає алгоритм планування розміщення, обмежений кандидатом на розміщення батьківської групи, щоб зробити попередні призначення Podʼів у памʼяті.
Перевірки здійсненності: Після оцінки кожної дочірньої групи планувальник викликає втулки PlacementFeasible, щоб визначити, чи може політика планування батьківської групи все ще бути виконана:
Якщо обмеження політики залишаються досяжними (або вже задоволені), планувальник продовжує оцінювати наступні сусідні групи.
Якщо обмеження політики більше не можуть бути задоволені, планувальник негайно перериває оцінку цього CompositePodGroup та скасовує всі попередні призначення Podʼів у памʼяті, зроблені для цієї групи.
Відкат симуляції: Після симуляції кандидата на розміщення (незалежно від успіху чи невдачі) планувальник скасовує попередні резервування вузлів, зроблені під час цієї симуляції, перед оцінкою наступного кандидата на розміщення.
Оцінка розміщення та фіксація піддерева: Після того, як усі кандидати на розміщення для CompositePodGroup були оцінені:
Оцінка: Якщо один або кілька кандидатів на розміщення є здійсненними, планувальник викликає втулки PlacementScorePlugin, щоб оцінити всіх здійсненних кандидатів на розміщення. Втулки оцінки оцінюють обʼєднані запропоновані призначення Podʼів по всіх дочірніх кінцевих обʼєктах PodGroup у піддереві та вибирають розміщення з найвищою загальною оцінкою.
Фіксація: Після вибору виграшного розміщення планувальник фіксує (припускає) попередні призначення Podʼів, що відповідають цьому оптимальному розміщенню, у памʼяті. Це гарантує, що наступні оцінки сусідніх груп або оцінки на рівні батьківської групи спостерігають узгоджені, оптимальні рішення планування для цього піддерева.
Якщо серед усіх згенерованих кандидатів не знайдено жодного здійсненного розміщення, весь CompositePodGroup вважається непридатним для планування.
Атомарна привʼязка: Якщо рекурсивна оцінка на кореневому рівні успішна та принаймні один Pod був успішно запланований, планувальник фіксує призначення Podʼів, переходячи до циклу привʼязки.
В іншому випадку весь CompositePodGroup вважається непридатним для планування.
Обмеження
Подібно до того, як алгоритм планування PodGroup покладається на специфічне сортування Podʼів, ієрархічний алгоритм планування покладається на специфічне сортування дочірніх груп у кожній ієрархії CompositePodGroup. В результаті він може не знайти дійсне розміщення, яке могло б бути виявлене під час обробки дочірніх груп в іншому порядку.
Крім того, оскільки планувальник оцінює ієрархії груп за допомогою жадібного підходу:
Знаходження дійсного розміщення не гарантується у всіх випадках, навіть якщо воно існує в кластері.
Навіть коли планувальник успішно знаходить дійсне розміщення для ієрархії CompositePodGroup, це розміщення не гарантовано є оптимальним по всьому кластеру.
Стани PodGroup
Після завершення циклу планування PodGroup планувальник оновлює стани в status.conditions PodGroup:
PodGroupInitiallyScheduled: повідомляє, чи був PodGroup успішно запланований вперше.
PodGroupInitiallyScheduled
Коли цикл планування успішний, стан встановлюється в True з причиною Scheduled. Для PodGroup з політикою gang це означає, що було розміщено принаймні minCount Podʼів.
Коли планування не вдається, стан встановлюється в False з однією з таких причин:
Unschedulable — групу не вдалося розмістити через обмеження ресурсів, правила спорідненості або антиспорідненості, або недостатню місткість для групи.
SchedulerError — планування не вдалося через внутрішню помилку планувальника (наприклад, під час розбору обмежень планування, таких як nodeAffinity).
Після того, як стан встановлено в True, він ніколи не змінюється.
Ви можете перевірити стани за допомогою:
kubectl get podgroup <name> -o jsonpath='{.status.conditions}'
Стани CompositePodGroup
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the CompositePodGroup feature gate for all relevant components in your cluster.
14 - Планування робочих навантажень з урахуванням топології
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.36; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the TopologyAwareWorkloadScheduling feature gate for all relevant components in your cluster.
Планування з урахуванням топології (Topology-Aware Scheduling, TAS) є алгоритмом планування розміщення, який дозволяє знайти оптимальне розміщення для розглянутого PodGroup, гарантуючи, що всі Podʼи будуть розміщені разом у межах одного топологічного домену. Користувачі можуть налаштувати TAS відповідно до своїх конкретних потреб, змінюючи конфігурацію втулків TAS.
Фреймворк планування: налаштування втулків TAS
Планувальник включає нові та розширені вбудовані втулки, які реалізують точки розширення TAS:
TopologyPlacement: Реалізує інтерфейс PlacementGeneratePlugin. Він генерує кандидатів на розміщення, групуючи вузли на основі різних значень запитуваного ключа key топології (визначеного в PodGroup).
NodeResourcesFit: Розширено для реалізації інтерфейсу PlacementScorePlugin. Використовуючи подібну логіку до стандартного пакування Podʼів, він оцінює розміщення на основі коефіцієнта використання ресурсів на всіх вузлах у розміщенні. Використовується стратегія MostAllocated для максимізації використання ресурсів у розміщенні, а також успадковуються ваги ресурсів із стандартних налаштувань втулка pod-by-pod.
PodGroupPodsCount: Реалізує інтерфейс PlacementScorePlugin. Він оцінює кандидатів на розміщення на основі загальної кількості Podʼів у PodGroup, які можна успішно запланувати.
Налаштування ваг втулків та ваг ресурсів пакування
Стандартно втулки NodeResourcesFit та PodGroupPodsCount налаштовані з однаковими вагами (обидві стандартно мають вагу 1), щоб підтримувати хороший баланс між логікою пакування Podʼів та плануванням максимальної кількості Podʼів.
Ви можете змінити ці ваги або ваги ресурсів у стратегії пакування у вашій конфігурації KubeSchedulerConfiguration. Ось приклад фрагмента, який показує, як змінити ваги для обох втулків і як перевизначити ваги ресурсів для NodeResourcesFit. Остання зміна буде застосована як до алгоритмів планування pod-by-pod, так і до алгоритмів оцінки розміщення:
apiVersion:kubescheduler.config.k8s.io/v1kind:KubeSchedulerConfigurationprofiles:- schedulerName:default-schedulerplugins:placementScore:enabled:# 1) Зміна стандартних ваг втулків оцінки розміщення- name:NodeResourcesFitweight:2- name:PodGroupPodsCountweight:5pluginConfig:- name:NodeResourcesFitargs:# 2) Зміна ваг ресурсів для обох алгоритмів оцінки pod-by-pod та розміщенняscoringStrategy:# Тип буде враховуватися лише під час планування pod-by-pod. Оцінка розміщення завжди# використовує стратегію MostAllocatedtype:LeastAllocated# Ваги ресурсів будуть використовуватися як в алгоритмах планування pod-by-pod, так і в алгоритмах оцінки розміщенняresources:- name:cpuweight:2- name:memoryweight:3
Багаторівневі розміщення топології
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the CompositePodGroup feature gate for all relevant components in your cluster.
Коли функціональну можливість CompositePodGroup та групу APIscheduling.k8s.io/v1alpha3 увімкнено, втулки планування з урахуванням топології розширюють свою підтримку на багаторівневі ієрархії CompositePodGroup. Ці втулки викликаються для CompositePodGroups під час ієрархічного планування.
Генерація кандидатів на розміщення
Для робочих навантажень, визначених з ієрархією CompositePodGroup, втулок TopologyPlacement генерує кандидатів на розміщення зверху вниз по ієрархії груп шляхом послідовного поділу:
Для кореневого CompositePodGroup втулок TopologyPlacement генерує кандидатів на розміщення по всіх доступних вузлах кластера, групуючи вузли на основі різних значень запитуваного ключа key топології.
Для дочірнього CompositePodGroup або кінцевого PodGroup втулок TopologyPlacement генерує кандидатів на розміщення, обмежених розміщенням, прийнятим батьківською групою. Він поділяє набір вузлів із розміщення батьківської групи, групуючи ці вузли на основі запитуваного ключа key топології дочірньої групи.
Примітка:
Якщо обмеження топології не вказано, втулок TopologyPlacement генерує одного кандидата на розміщення, еквівалентного розміщенню батьківської групи.
Аналогічно, якщо коренева група не вказує жодного обмеження топології, втулок генерує одного кандидата на розміщення, що відповідає всім доступним вузлам у кластері. Це також справедливо для однорівневих робочих навантажень, що використовують API PodGroup, де обмеження топології не вказано.
Оцінка розміщення
Під час оцінки кандидата на розміщення для CompositePodGroup втулки оцінки застосовують логіку, подібну до однорівневого випадку PodGroup:
PodGroupPodsCount: Оцінює кандидатів на розміщення на основі загальної кількості Podʼів (як уже запланованих, так і щойно прийнятих) по всіх дочірніх кінцевих PodGroups цього CompositePodGroup. Кандидати на розміщення, здатні вмістити більшу загальну кількість Podʼів по підієрархії, отримують вищі оцінки.
NodeResourcesFit: Агрегує запити ресурсів усіх запропонованих Podʼів по всіх дочірніх PodGroups цього CompositePodGroup та оцінює використання ресурсів по всіх вузлах у межах домену кандидата на розміщення.
Podʼи можуть мати пріоритет. Пріоритет вказує на важливість Podʼа порівняно з іншими Podʼами. Якщо Pod не може бути запланований, планувальник намагається витіснити (виселити) Podʼи з нижчим пріоритетом, щоб зробити можливим планування Podʼа в очікуванні.
Попередження:
У кластері, де не всі користувачі є довіреними, зловмисник може створити Podʼи з найвищими можливими пріоритетами, що призведе до виселення інших Podʼів або неможливості їх планування. Адміністратор може використовувати ResourceQuota, щоб запобігти користувачам створювати Podʼи з високими пріоритетами.
Створіть Podʼи з параметром priorityClassName, встановленим на один з доданих PriorityClasses. Звісно, вам не потрібно створювати Podʼи безпосередньо; зазвичай ви додаєте priorityClassName до шаблону Podʼа обʼєкта колекції, такого як Deployment.
Продовжуйте читати для отримання додаткової інформації про ці кроки.
PriorityClass
PriorityClass є обʼєктом, що не належить до простору імен, і визначає зіставлення назви класу пріоритету з цілим значенням пріоритету. Назва вказується в полі name метаданих обʼєкта PriorityClass. Значення вказується в обовʼязковому полі value. Чим вище значення, тим вищий пріоритет. Назва обʼєкта PriorityClass повинна бути дійсною назвою піддомену DNS, і вона не може мати префікс system-.
Обʼєкт PriorityClass може мати будь-яке 32-розрядне ціле значення, яке менше або дорівнює 1 мільярду. Це означає, що діапазон значень для обʼєкта PriorityClass становить від -2147483648 до 1000000000 включно. Більші числа зарезервовані для вбудованих PriorityClass, які представляють критичні системні Podʼи. Адміністратор кластера повинен створити один обʼєкт PriorityClass для кожного потрібного йому зіставлення.
Примітка:
Kubernetes вже поставляється з двома PriorityClasses: system-cluster-critical та system-node-critical. Ці спільні класи використовуються для забезпечення того, що критичні компоненти завжди плануються першими. Для Kubernetes v1.37 їхні значення пріоритету становлять 2000000000 для system-cluster-critical і 2000001000 для system-node-critical.
PriorityClass також має два необовʼязкові поля: globalDefault та description. Поле globalDefault вказує, що значення цього PriorityClass повинно використовуватися для Podʼів без priorityClassName. У системі може існувати лише один PriorityClass з globalDefault, встановленим в true. Якщо немає PriorityClass із встановленим globalDefault, пріоритет Podʼів без priorityClassName дорівнює нулю.
Поле description є довільним рядком. Воно призначене для сповіщення користувачів кластера про те, коли вони повинні використовувати цей PriorityClass.
Примітки щодо PodPriority та наявних кластерів
Якщо ви оновлюєте наявний кластер без цієї можливості, пріоритет ваших наявних Podʼів фактично дорівнює нулю.
Додавання PriorityClass з globalDefault, встановленим в true, не змінює пріоритети наявних Podʼів. Значення такого PriorityClass використовується тільки для Podʼів, створених після додавання PriorityClass.
Якщо ви видаляєте PriorityClass, наявні Podʼи, які використовують назву видаленого PriorityClass, залишаються незмінними, але ви не можете створювати більше Podʼів, які використовують назву видаленого PriorityClass.
Приклад PriorityClass
apiVersion:scheduling.k8s.io/v1kind:PriorityClassmetadata:name:high-priorityvalue:1000000globalDefault:falsedescription:"This priority class should be used for XYZ service pods only."
PriorityClass без витіснення
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.24
Podʼи з preemptionPolicy: Never будуть розміщені в черзі планування перед Podʼами з нижчим пріоритетом, але вони не можуть витісняти інші Podʼи. Pod без витіснення, який очікує на планування, залишиться в черзі планування, доки не буде достатньо вільних ресурсів і його можна буде запланувати. Podʼи без витіснення, як і інші Podʼи, підлягають backoff планувальника. Це означає, що якщо планувальник спробує запланувати ці Podʼи, і вони не можуть бути заплановані, повторні спроби будуть рідшими, що дозволяє іншим Podʼам з нижчим пріоритетом бути запланованими перед ними.
Podʼи без витіснення все ще можуть бути витіснені іншими Podʼами з високим пріоритетом.
Стандартне значення preemptionPolicy — PreemptLowerPriority, що дозволяє Podʼам цього PriorityClass витісняти Podʼи з нижчим пріоритетом (це наявна стандартна поведінка). Якщо preemptionPolicy встановлено в Never, Podʼи в цьому PriorityClass не витіснятимуть інші Podʼи.
Прикладом використання є робочі навантаження науки про дані. Користувач може надіслати завдання, якому він хоче дати пріоритет перед іншими робочими навантаженнями, але не бажає втрачати наявну роботу, витісняючи запущені Podʼи. Завдання з високим пріоритетом із preemptionPolicy: Never буде заплановано перед іншими Podʼами в черзі, щойно достатньо ресурсів кластера «природним чином» звільниться.
Приклад PriorityClass без витіснення
apiVersion:scheduling.k8s.io/v1kind:PriorityClassmetadata:name:high-priority-nonpreemptingvalue:1000000preemptionPolicy:NeverglobalDefault:falsedescription:"This priority class will not cause other pods to be preempted."
Пріоритет Podʼа
Після того, як у вас є один або кілька PriorityClasses, ви можете створювати Podʼи, які вказують одну з назв цих PriorityClasses у своїх специфікаціях. Контролер допуску пріоритетів використовує поле priorityClassName і заповнює ціле значення пріоритету. Якщо клас пріоритету не знайдено, Pod відхиляється.
Наведений нижче YAML — це приклад конфігурації Podʼа, який використовує PriorityClass, створений у попередньому прикладі. Контролер допуску пріоритетів перевіряє специфікацію та визначає пріоритет Podʼа як 1000000.
Коли пріоритет Podʼа увімкнено, планувальник впорядковує Podʼи в очікуванні за їх пріоритетом, і Pod в очікуванні розташовується в черзі планування попереду інших Podʼів в очікуванні з нижчим пріоритетом. В результаті Pod з вищим пріоритетом може бути запланований швидше, ніж Podʼи з нижчим пріоритетом, якщо його вимоги до планування виконуються. Якщо такий Pod не може бути запланований, планувальник продовжить спроби запланувати інші Podʼи з нижчим пріоритетом.
PodGroups та порядок планування
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the GenericWorkload feature gate for all relevant components in your cluster.
Коли функціональну можливість GenericWorkload увімкнено, PodGroups чергуються з окремими Podʼами в черзі планування. Обʼєкт PodGroup має власне поле priority, яке використовується для впорядкування відносно інших Podʼів та PodGroups. Деталі щодо того, як встановити пріоритет PodGroup, доступні на сторінці Порушення та пріоритет групи Podʼів.
CompositePodGroups та порядок планування
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the CompositePodGroup feature gate for all relevant components in your cluster.
Коли функціональну можливість CompositePodGroup увімкнено, планувальник розглядає наступні обʼєкти як одиниці планування, які можуть бути поставлені в чергу:
Самостійні Podʼи — Podʼи, які не є частиною жодного PodGroup,
Самостійні PodGroups — PodGroups, які не вказують ParentCompositePodGroup,
Кореневі CompositePodGroups — CompositePodGroups, які не вказують ParentCompositePodGroup.
Ці обʼєкти вказують значення поля priority, яке використовується для визначення їх позиції в активній черзі планування.
Витіснення
Коли Podʼи створюються, вони потрапляють у чергу та очікують на планування. Планувальник вибирає Pod з черги та намагається запланувати його на вузлі. Якщо не знайдено жодного вузла, який задовольняє всі вказані вимоги Podʼа, для Podʼа в очікуванні спрацьовує логіка витіснення. Назвімо цей Pod в очікуванні P. Логіка витіснення спробує знайти вузол, де видалення одного або кількох Podʼів з нижчим пріоритетом, ніж P, дозволить запланувати P на цьому вузлі. Якщо такий вузол знайдено, один або кілька Podʼів з нижчим пріоритетом будуть виселені з вузла. Після того, як ці Podʼи зникнуть, P може бути запланований на вузлі.
Витіснення PodGroup
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the GenericWorkload feature gate for all relevant components in your cluster.
Коли функціональну можливість GenericWorkload увімкнено, PodGroups можуть брати участь у витісненні як ініціатор або як жертва. Коли PodGroup ініціює витіснення, він дотримується логіки витіснення з урахуванням робочого навантаження, щоб витіснити інші Podʼи та PodGroups і звільнити місце для себе. Коли Pod ініціює витіснення, PodGroup може стати жертвою. У цьому випадку поле priority PodGroup використовується для впорядкування відносно інших потенційних жертв, а поле disruptionMode використовується для визначення поведінки PodGroup під час порушення. Детальний опис цих полів доступний на сторінці Порушення та пріоритет групи Podʼів.
Інформація, доступна користувачеві
Коли Pod P витісняє один або кілька Podʼів на вузлі N, поле nominatedNodeName статусу Podʼа P встановлюється в назву вузла N. Це поле допомагає планувальнику відстежувати ресурси, зарезервовані для Podʼа P, і також надає користувачам інформацію про витіснення в їх кластерах.
Зверніть увагу, що Pod P не обовʼязково планується на «номінований вузол». Планувальник завжди спочатку спробує «номінований вузол», перед тим як перевіряти будь-які інші вузли. Після того, як Podʼи-жертви витіснено, вони отримують свій період коректного завершення. Якщо під час очікування на завершення роботи Podʼів-жертв стає доступним інший вузол, планувальник може використати інший вузол для планування Podʼа P. В результаті поля nominatedNodeName та nodeName специфікації Podʼа не завжди збігаються. Крім того, якщо планувальник витісняє Podʼи на вузлі N, а потім надходить Pod вищого пріоритету, ніж Pod P, планувальник може надати вузол N новому Podʼу вищого пріоритету. У такому випадку планувальник очищає nominatedNodeName Podʼа P. Цим самим планувальник робить Pod P придатним для витіснення Podʼів на іншому вузлі.
Обмеження витіснення
Коректне завершення роботи жертв витіснення
Коли Podʼи витісняються, жертви отримують свій період коректного завершення. У них є стільки часу, скільки вказано в цьому періоді, для завершення своєї роботи та виходу. Якщо вони цього не роблять, їх робота завершується примусово. Цей період коректного завершення створює проміжок часу між моментом, коли планувальник витісняє Podʼи, і моментом, коли Pod (P) в очікуванні може бути запланований на вузол (N). Тим часом планувальник продовжує планувати інші Podʼи в очікуванні. Поки жертви завершують роботу самі або примусово, планувальник намагається запланувати Podʼи з черги очікування. Тому зазвичай є проміжок часу між моментом, коли планувальник витісняє жертв, і моментом, коли Pod P буде заплановано. Щоб зменшити цей проміжок, можна встановити період коректного завершення для Podʼів з нижчим пріоритетом на нуль або мале число.
PodDisruptionBudget підтримується, але не гарантується
PodDisruptionBudget (PDB) дозволяє власникам застосунків обмежувати кількість Podʼів реплікованого застосунку, які одночасно недоступні через добровільні порушення. Kubernetes підтримує PDB під час витіснення Podʼів, але дотримання PDB відбувається за принципом best-effort. Планувальник намагається знайти жертв, PDB яких не буде перевищено в результаті витіснення, але якщо жодної такої жертви не знайдено, витіснення все одно відбудеться, і Podʼи з нижчим пріоритетом будуть видалені, попри перевищення їхнього PDB.
Спорідненість між Podʼами для Podʼів з нижчим пріоритетом
Вузол розглядається для витіснення тільки тоді, коли відповідь на це питання ствердна: «Якщо всі Podʼи з нижчим пріоритетом, ніж Pod в очікуванні, будуть видалені з вузла, чи може Pod в очікуванні бути запланований на цьому вузлі?»
Примітка:
Витіснення не обовʼязково видаляє всі Podʼи з нижчим пріоритетом. Якщо Pod в очікуванні може бути запланований, видаливши менше, ніж всі Podʼи з нижчим пріоритетом, то видаляється лише частина Podʼів з нижчим пріоритетом. Попри це, відповідь на попереднє питання повинна бути ствердною. Якщо відповідь негативна, то вузол не розглядається для витіснення.
Якщо Pod в очікуванні має спорідненість між Podʼами з одним або кількома Podʼами з нижчим пріоритетом на вузлі, правило спорідненості між Podʼами не може бути виконане за відсутності цих Podʼів з нижчим пріоритетом. У цьому випадку планувальник не витісняє жодних Podʼів на вузлі. Замість цього він шукає інший вузол. Планувальник може знайти відповідний вузол або може і не знайти. Немає гарантії, що Pod в очікуванні може бути запланований.
Рекомендованим рішенням для цієї проблеми є створення спорідненості між Podʼами лише з Podʼами з рівним або вищим пріоритетом.
Міжвузлове витіснення
Припустимо, що вузол N розглядається для витіснення, щоб запланувати Pod P в очікуванні на N. Планування P на N може стати здійсненним лише у випадку витіснення Podʼа на іншому вузлі. Ось приклад:
Pod P розглядається для вузла N.
Pod Q запущений на іншому вузлі в тій же зоні, що й вузол N.
Pod P має антиспорідненість по всій зоні з Podʼом Q (з topologyKey: topology.kubernetes.io/zone).
Інших випадків антиспорідненості між Podʼом P та іншими Podʼами в зоні немає.
Щоб запланувати Pod P на вузлі N, Pod Q може бути витіснений, але планувальник не виконує міжвузлове витіснення. Отже, Pod P буде вважатися непридатним для планування на вузлі N.
Якщо Pod Q буде видалено зі свого вузла, порушення антиспорідненості Podʼа буде усунено, і Pod P, можливо, можна буде запланувати на вузлі N.
Ми можемо розглянути додавання міжвузлового витіснення в майбутніх версіях, якщо буде достатньо попиту і якщо ми знайдемо алгоритм з прийнятною продуктивністю.
Витіснення для зміни розміру Podʼа на місці
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the InPlacePodVerticalScalingSchedulerPreemption feature gate for all relevant components in your cluster.
Коли функціональну можливість InPlacePodVerticalScalingSchedulerPreemption увімкнено, витіснення також застосовується, коли запит на зміну розміру запущеного Podʼа на місці має статус Deferred (тобто запитана зміна розміру тимчасово неможлива, але може стати можливою пізніше) через недостатню місткість вузла. Деталі щодо станів зміни розміру дивіться в статусі зміни розміру Podʼа.
Якщо Pod вищого пріоритету не може бути змінений на місці, оскільки його вузлу бракує доступних CPU або памʼяті, kube-scheduler намагається витіснити Podʼи нижчого пріоритету на цьому вузлі, щоб звільнити необхідну місткість.
Витіснення для зміни розміру Podʼа на місці відрізняється від стандартного витіснення під час розміщення Podʼа кількома ключовими способами:
Обмеження вузла: Витіснення суворо обмежене поточним призначеним вузлом Podʼа. Планувальник не оцінює інші вузли-кандидати по всьому кластеру.
Обчислення дельти ресурсів: Необхідна для витіснення місткість обчислюється на основі дельти ресурсів (різниці між бажаними та поточно виділеними ресурсами), а не загального запиту Podʼа.
Блокування ресурсів: Запитані ресурси Podʼа, розмір якого змінюється, вважаються вже спожитими для обліку ресурсів планувальника на цьому вузлі, не даючи іншим Podʼам нижчого пріоритету їх використовувати, доки зміна розміру не буде виконана або kubelet не видалить статус Deferred.
Статус номінованого вузла: Поле nominatedNodeName у статусі Podʼа не встановлюється, оскільки Pod вже призначений і працює на своєму цільовому вузлі.
Виконання kubelet: Планувальник ініціює витіснення, щоб звільнити місткість вузла, але не привʼязує Pod повторно. Kubelet виявляє щойно звільнену місткість на вузлі та виконує фактичну зміну розміру на місці.
Політика витіснення на рівні вузла: Витіснення можна вимкнути спеціально для змін розміру на місці на конкретних вузлах за допомогою поля spec.podPreemptionPolicy.disableResizePreemption специфікації Node. На відміну від стандартного витіснення, яке можна вимкнути лише для кожного класу пріоритету за допомогою preemptionPolicy: Never, це дозволяє операторам або системам автомасштабування вимикати витіснення на окремих вузлах.
Вимкнення витіснення для зміни розміру Podʼа на місці на рівні вузла
Оператори кластера та контролери можуть вимикати ініційоване планувальником витіснення, спричинене запитами на зміну розміру Podʼа на місці, на конкретних вузлах. Це корисно для вузлів, розмір яких можна змінювати, або вузлів із власними рішеннями автомасштабування, захищаючи наявні робочі навантаження від порушення та дозволяючи натомість усунути дефіцит ресурсів збільшенням розміру вузла.
Це налаштовується за допомогою поля spec.podPreemptionPolicy у специфікації Node. Якщо список disableResizePreemption не порожній, витіснення, спричинене зміною розміру, вимикається на цьому вузлі, і kube-scheduler пропускатиме спроби витіснення для будь-яких відкладених змін розміру, що виконуються на цьому вузлі.
Формат мітки: Кожен запис у списку disableResizePreemption повинен відповідати стандартному формату ключа мітки Kubernetes (наприклад, префікс піддомену DNS та назва, розділені /).
Максимальна кількість: Список може містити максимум 20 записів.
Непорожній список: Політика виконується (витіснення вимикається), якщо список містить принаймні один запис. Якщо список порожній або поле podPreemptionPolicy опущено, витіснення для зміни розміру на місці увімкнено на вузлі.
Розвʼязання проблем
Пріоритет та витіснення Podʼа можуть мати небажані побічні ефекти. Ось кілька прикладів потенційних проблем і способів їх вирішення.
Podʼи витісняються безпідставно
Витіснення видаляє наявні Podʼи з кластера під тиском на ресурси, щоб звільнити місце для високопріоритетних Podʼів в очікуванні. Якщо ви помилково встановили високі пріоритети для певних Podʼів, ці ненавмисно високопріоритетні Podʼи можуть спричинити витіснення у вашому кластері. Пріоритет Podʼа вказується встановленням поля priorityClassName в специфікації Podʼа. Потім ціле значення пріоритету визначається і заповнюється у поле prioritypodSpec.
Щоб розвʼязати цю проблему, ви можете змінити priorityClassName для цих Podʼів, щоб використовувати класи з нижчим пріоритетом, або залишити це поле порожнім. Порожній priorityClassName стандартно вважається нулем.
Коли Pod витісняється, для такого Podʼа будуть записані події. Витіснення повинно відбуватися лише тоді, коли в кластері недостатньо ресурсів для Podʼа. У таких випадках витіснення відбувається лише тоді, коли пріоритет Podʼа в очікуванні (витіснювача) вищий, ніж у Podʼів-жертв. Витіснення не повинно відбуватися, коли немає Podʼа в очікуванні, або коли Podʼи в очікуванні мають рівні або нижчі пріоритети, ніж у жертв. Якщо витіснення відбувається в таких сценаріях, будь ласка, повідомте про проблему.
Podʼи витісняються, але витіснювач не планується
Коли Podʼи витісняються, вони отримують запитаний період коректного завершення, який стандартно становить 30 секунд. Якщо Podʼи-жертви не завершуються протягом цього періоду, вони завершуються примусово. Після того, як усі жертви зникають, Pod-витіснювач може бути запланований.
Поки Pod-витіснювач чекає, доки жертви зникнуть, може бути створений Pod з вищим пріоритетом, який підходить на той самий вузол. У цьому випадку планувальник запланує Pod з вищим пріоритетом замість витіснювача.
Це очікувана поведінка: Pod з вищим пріоритетом повинен зайняти місце Podʼа з нижчим пріоритетом.
Podʼи з вищим пріоритетом витісняються раніше за Podʼи з нижчим пріоритетом
Планувальник намагається знайти вузли, на яких можна запустити Pod в очікуванні. Якщо вузол не знайдено, планувальник намагається видалити Podʼи з нижчим пріоритетом з довільного вузла, щоб звільнити місце для Podʼа в очікуванні. Якщо вузол з Podʼами низького пріоритету не може бути використаний для запуску Podʼа в очікуванні, планувальник може вибрати інший вузол з Podʼами вищого пріоритету (порівняно з Podʼами на іншому вузлі) для витіснення. Жертви все ще повинні мати нижчий пріоритет, ніж Pod-витіснювач.
Коли є доступні кілька вузлів для витіснення, планувальник намагається вибрати вузол з набором Podʼів з найнижчим пріоритетом. Однак якщо такі Podʼи мають PodDisruptionBudget, який буде перевищено, якщо вони будуть витіснені, то планувальник може вибрати інший вузол з Podʼами вищого пріоритету.
Коли є кілька вузлів для витіснення і жоден з вищезазначених сценаріїв не застосовується, планувальник вибирає вузол з найнижчим пріоритетом.
Взаємодія між пріоритетом Podʼа та якістю обслуговування
Пріоритет Podʼа та клас якості обслуговування є двома ортогональними можливостями з невеликою кількістю взаємодій та без стандартних обмежень щодо встановлення пріоритету Podʼа на основі його класів QoS. Логіка витіснення планувальника не враховує QoS під час вибору цілей витіснення. Витіснення враховує пріоритет Podʼа і намагається вибрати набір цілей з найнижчим пріоритетом. Podʼи вищого пріоритету розглядаються для витіснення лише тоді, коли видалення Podʼів з найнижчим пріоритетом не є достатнім для того, щоб дозволити планувальнику розмістити Pod-витіснювач, або якщо Podʼи з найнижчим пріоритетом захищені PodDisruptionBudget.
kubelet використовує пріоритет для визначення порядку Podʼів для виселення внаслідок тиску на вузол. Ви можете використовувати клас QoS для оцінки порядку, в якому найімовірніше будуть виселятися Podʼи. kubelet ранжує Podʼи для виселення на основі таких факторів:
Чи перевищує використання дефіцитного ресурсу запити
Пріоритет Podʼа
Обсяг використання ресурсів в порівнянні із запитами
Виселення kubelet внаслідок тиску на вузол не виселяє Podʼи, коли їх використання не перевищує їх запити. Якщо Pod з нижчим пріоритетом не перевищує свої запити, він не буде виселений. Інший Pod з вищим пріоритетом, який перевищує свої запити, може бути виселений.
Виселення внаслідок тиску на вузол — це процес, під час якого kubelet проактивно завершує роботу Podʼів, щоб звільнити ресурси на вузлах.
kubelet моніторить ресурси, такі як памʼять, простір на диску та inode файлової системи на вузлах вашого кластера. Коли один або кілька з цих ресурсів досягають певних рівнів використання, kubelet може проактивно завершити зі збоєм один або кілька Podʼів на вузлі, щоб звільнити ресурси та запобігти їх вичерпанню.
Під час виселення внаслідок тиску на вузол kubelet встановлює фазу для вибраних Podʼів в значення Failed та завершує роботу Podʼа.
kubelet не враховує ваш налаштований PodDisruptionBudget або параметр terminationGracePeriodSeconds Podʼа. Якщо ви використовуєте порогові значення мʼякого виселення, kubelet дотримується вашого налаштованого evictionMaxPodGracePeriod. Якщо ви використовуєте порогові значення жорсткого виселення, kubelet використовує період коректного завершення 0s (негайне вимкнення) для завершення роботи.
Поведінка самозцілення
kubelet намагається звільнити ресурси на рівні вузла перед тим, як завершувати роботу Podʼів кінцевих користувачів. Наприклад, він видаляє невикористані образи контейнерів, коли дискових ресурсів недостатньо.
Якщо Podʼами керує обʼєкт керування робочим навантаженням (такий як StatefulSet або Deployment), який замінює Podʼи зі збоєм, панель управління (kube-controller-manager) створює нові Podʼи на місці виселених Podʼів.
Самозцілення статичних Podʼів
Якщо ви запускаєте статичний Pod на вузлі, який перебуває під тиском на ресурси, kubelet може виселити цей статичний Pod. Потім kubelet намагається створити заміну, оскільки статичні Podʼи завжди представляють намір запустити Pod на цьому вузлі.
Kubelet враховує пріоритет статичного Podʼа під час створення заміни. Якщо маніфест статичного Podʼа вказує низький пріоритет, і в межах панелі управління кластера визначені Podʼи з вищим пріоритетом, і вузол перебуває під тиском на ресурси, то kubelet може не мати можливості звільнити місце для цього статичного Podʼа. Kubelet продовжує намагатися запустити всі статичні Podʼи навіть тоді, коли на вузлі є тиск на ресурси.
Сигнали та пороги виселення
Kubelet використовує різні параметри для прийняття рішень щодо виселення, такі як:
Сигнали виселення
Пороги виселення
Інтервали моніторингу
Сигнали виселення
Сигнали виселення — це поточний стан певного ресурсу в конкретний момент часу. Kubelet використовує сигнали виселення для прийняття рішень про виселення, порівнюючи їх з порогами виселення, які є мінімальною кількістю ресурсу, яка повинна бути доступна на вузлі.
У цій таблиці стовпець Опис показує, як kubelet отримує значення сигналу. Кожен сигнал підтримує відсоткове або літеральне значення. Kubelet обчислює відсоткове значення відносно загальної місткості, повʼязаної із сигналом.
Сигнали памʼяті
На вузлах Linux значення для memory.available походить з cgroupfs замість таких інструментів, як free -m. Це важливо, оскільки free -m не працює у контейнері, і якщо користувачі використовують можливість ресурсів вузла, доступних для розподілу, рішення про вичерпання ресурсів приймаються локально в частині ієрархії cgroup, що належить Podʼам кінцевих користувачів, а також на кореневому вузлі. Цей скрипт або скрипт cgroupv2 відтворює той самий набір кроків, які kubelet виконує для обчислення memory.available. Kubelet виключає зі свого обчислення inactive_file (кількість байтів памʼяті, що має файлове резервне сховище, у неактивному списку LRU), оскільки припускає, що цю памʼять можна звільнити під тиском.
Примітка:
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.37; (стандартно увімкнено)
На вузлах із налаштованими hugepages kubelet віднімає загальну місткість hugepages вузла від memory.available, яку використовує менеджер виселення. Без цього коригування зарезервована під hugepages оперативна памʼять завищує AvailableBytes, оскільки контролер cgroup памʼяті не відстежує виділення hugetlb у своєму робочому наборі. Це може затримати виселення та призвести до OOM-завершень. Щоб відновити попередню поведінку, вимкніть функціональну можливість HugepageAwareEviction.
На Windows-вузлах значення memory.available отримується з глобального рівня комітів памʼяті вузла (запитується через системний виклик GetPerformanceInfo()) шляхом віднімання глобального значення CommitTotal від CommitLimit вузла. Зверніть увагу, що значення CommitLimit може змінюватися, якщо змінюється розмір файлу підкачки вузла!
Сигнали файлової системи
Kubelet розпізнає три конкретні ідентифікатори файлової системи, які можна використовувати із сигналами виселення (<identifier>.inodesFree або <identifier>.available):
nodefs: Основна файлова система вузла, використовується для локальних дискових томів, томів emptyDir, які не підтримуються памʼяттю, зберігання логів, ефемерного зберігання та іншого. Наприклад, nodefs містить /var/lib/kubelet.
imagefs: Необовʼязкова файлова система, яку середовища виконання контейнерів можуть використовувати для зберігання образів контейнерів (які є шарами тільки для читання). Якщо окремої файлової системи containerfs немає, файлова система образів також зберігає шари контейнера, доступні для запису.
containerfs: Необовʼязкова файлова система, яку середовища виконання контейнерів можуть використовувати для зберігання записуваних шарів контейнерів. Коли використовується containerfs, файлова система imagefs може бути розділена так, щоб зберігати лише образи (шари тільки для читання) і більше нічого.
Ці ідентифікатори описують файлові системи так, як їх бачить kubelet. Вони не завжди означають три різні точки монтування: у звичайних конфігураціях два або всі три ідентифікатори можуть посилатися на одну й ту ж базову файлову систему.
Примітка:
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.31; (стандартно увімкнено)
Можливість split image filesystem додає нові сигнали виселення, пороги та метрики для containerfs. Щоб використовувати containerfs, у випуску Kubernetes v1.37 потрібно увімкнути функціональну можливість KubeletSeparateDiskGC. Для Kubernetes v1.37 підтримку файлової системи containerfs пропонує лише CRI-O (v1.29 або вище).
Kubelet підтримує три поширені схеми розміщення файлових систем контейнерів:
Усе зберігається на єдиній nodefs, яку також називають «rootfs» або просто «root». У цій схемі nodefs, imagefs та containerfs посилаються на одну й ту саму базову файлову систему.
Сховище середовища виконання контейнерів розміщено на окремому диску, відокремленому від кореневої файлової системи. У цій схемі imagefs та containerfs посилаються на одну й ту саму базову файлову систему, яка зберігає як шари образів, так і записувані шари контейнерів. Це часто називають файловою системою «split disk» (або «separate disk»).
Записувані шари контейнерів розміщено на nodefs, а образи контейнерів (шари лише для читання) зберігаються на окремій imagefs. У цій схемі containerfs та nodefs посилаються на одну й ту саму базову файлову систему. Це часто називають файловою системою «split image».
Kubelet спробує автоматично виявити ці файлові системи з їхньою поточною конфігурацією безпосередньо з базового середовища виконання контейнерів і ігноруватиме інші локальні файлові системи вузла.
Kubelet не підтримує інші файлові системи контейнерів або конфігурації зберігання і наразі не підтримує кілька файлових систем для образів і контейнерів.
Застарілі можливості збору сміття kubelet
Деякі можливості збору сміття kubelet застаріли на користь виселення:
Наявний прапорець
Обґрунтування
--maximum-dead-containers
застаріло, щойно старі логи зберігаються поза контекстом контейнера
--maximum-dead-containers-per-container
застаріло, щойно старі логи зберігаються поза контекстом контейнера
--minimum-container-ttl-duration
застаріло, щойно старі логи зберігаються поза контекстом контейнера
Пороги виселення
Ви можете вказати власні пороги виселення для kubelet, які він буде використовувати під час прийняття рішень про виселення. Ви можете налаштувати мʼякі та жорсткі пороги виселення.
Пороги виселення мають формат [eviction-signal][operator][quantity], де:
operator — це оператор відношення, який ви хочете використати, наприклад, < (менше ніж).
quantity — це кількість порогу виселення, наприклад, 1Gi. Значення quantity повинно відповідати представленню кількості, яке використовується в Kubernetes. Ви можете використовувати як літеральні значення, так і відсотки (%).
Наприклад, якщо вузол має загальний обсяг памʼяті 10GiB і ви хочете ініціювати виселення, коли доступна памʼять опуститься нижче 1GiB, ви можете визначити поріг виселення як memory.available<10% або memory.available<1Gi (використовувати обидва варіанти одночасно не можна).
Мʼякі пороги виселення
Мʼякий поріг виселення поєднує в собі поріг виселення з обовʼязковим пільговим періодом, вказаним адміністратором. Kubelet не виселяє Podʼи до закінчення пільгового періоду. Kubelet повертає помилку під час запуску, якщо ви не вказали пільговий період.
Ви можете вказати як пільговий період для мʼякого порогу виселення, так і максимально дозволений період коректного завершення Podʼів, який kubelet використовуватиме під час виселення. Якщо ви вказали максимально дозволений період і мʼякий поріг виселення досягнуто, kubelet використовує менший із двох періодів. Якщо ви не вказали максимально дозволений період, kubelet негайно завершує роботу виселених Podʼів без коректного завершення.
Ви можете використовувати такі налаштування у файлі конфігурації kubelet:
evictionSoft: Набір порогів виселення, наприклад, memory.available<1.5Gi, які можуть ініціювати виселення Podʼів, якщо вони утримуються протягом вказаного пільгового періоду.
evictionSoftGracePeriod: Набір пільгових періодів для виселення, наприклад, memory.available=1m30s, які визначають, як довго мʼякий поріг виселення повинен утримуватися, перш ніж буде ініційовано виселення Podʼа.
evictionMaxPodGracePeriod: Максимально дозволений період коректного завершення (у секундах) для використання під час завершення Podʼів у відповідь на досягнення мʼякого порогу виселення.
Жорсткі пороги виселення
Жорсткий поріг виселення не має пільгового періоду. Коли досягнуто жорсткого порогу виселення, kubelet негайно завершує роботу Podʼів без коректного завершення, щоб звільнити дефіцитний ресурс.
Ви можете використовувати поле evictionHard для налаштування набору жорстких порогів виселення, наприклад memory.available<1Gi.
Kubelet має наступні стандартні жорсткі пороги виселення:
memory.available<100Mi (для вузлів Linux)
memory.available<500Mi (для вузлів Windows)
nodefs.available<10%
imagefs.available<15%
nodefs.inodesFree<5% (для вузлів Linux)
imagefs.inodesFree<5% (для вузлів Linux)
Ці стандартні значення жорстких порогів виселення будуть встановлені лише у випадку, якщо жоден з параметрів не змінено. Якщо ви зміните значення будь-якого параметра, то значення інших параметрів не будуть успадковані як стандартні та будуть встановлені в нуль. Щоб надати власні значення, ви повинні вказати всі пороги відповідно. Ви також можете встановити параметр MergeDefaultEvictionSettings у true у файлі конфігурації kubelet. Якщо встановити true і змінити будь-який параметр, то інші параметри успадкують свої стандартні значення, а не 0.
Стандартні пороги виселення для containerfs.available і containerfs.inodesFree (для Linux-вузлів) будуть встановлені таким чином:
Якщо containerfs та nodefs посилаються на одну й ту саму базову файлову систему, то пороги для containerfs встановлюються такими ж, як і для nodefs.
Якщо containerfs та imagefs посилаються на одну й ту саму базову файлову систему, то пороги для containerfs встановлюються такими ж, як і для imagefs.
Налаштування власних порогів, повʼязаних із containerfs, не підтримується, і буде видано попередження, якщо спробувати це зробити; будь-які надані власні значення будуть ігноровані.
Інтервал моніторингу виселення
Kubelet оцінює пороги виселення, виходячи з налаштованого housekeeping-interval, стандартне значення якого — 10s.
Стани вузла
Kubelet повідомляє про стани вузла, показуючи, що вузол перебуває під тиском через досягнення порогу жорсткого або мʼякого виселення, незалежно від налаштованих пільгових періодів.
Kubelet зіставляє сигнали виселення зі станами вузла таким чином:
Стан вузла
Сигнал виселення
Опис
MemoryPressure
memory.available
Доступна памʼять на вузлі досягла порогового значення для виселення
DiskPressure
nodefs.available, nodefs.inodesFree, imagefs.available, imagefs.inodesFree, containerfs.available, або containerfs.inodesFree
Доступне місце на диску та inode на кореневій файловій системі вузла, файловій системі образів або файловій системі контейнерів досягли порогового значення для виселення
PIDPressure
pid.available
Доступні ідентифікатори процесів на (Linux) вузлі зменшилися нижче порогового значення для виселення
Панель управління також зіставляє ці стани вузла на taints.
Kubelet оновлює стани вузла відповідно до налаштованого nodeStatusUpdateFrequency, стандартне значення якого — 10s.
Коливання станів вузла
У деяких випадках вузли коливаються вище та нижче мʼяких порогів виселення, не утримуючись протягом визначених пільгових періодів. Це призводить до того, що стан вузла, про який повідомляється, постійно перемикається між true та false, що призводить до поганих рішень щодо виселення.
Для захисту від коливань можна використовувати прапорець eviction-pressure-transition-period, який контролює, як довго kubelet повинен чекати перш ніж перевести стан вузла в інше значення. Період переходу має стандартне значення 5m.
Звільнення ресурсів на рівні вузла
Kubelet намагається звільнити ресурси на рівні вузла перед виселенням Podʼів кінцевих користувачів.
Коли вузол повідомляє про стан DiskPressure, kubelet звільняє ресурси на рівні вузла на основі файлових систем на вузлі.
Без imagefs або containerfs
Якщо на вузлі є лише файлова система nodefs, яка досягає порогів виселення, kubelet звільняє місце на диску в такому порядку:
Виконує збір сміття для мертвих Podʼів і контейнерів.
Видаляє непотрібні образи.
З використанням imagefs
Якщо на вузлі є окрема файлова система imagefs, яку використовують середовища виконання контейнерів, то kubelet робить таке:
Якщо файлова система nodefs досягає порогів виселення, то kubelet виконує збір сміття для мертвих Podʼів і контейнерів.
Якщо файлова система imagefs досягає порогів виселення, то kubelet видаляє всі невикористані образи.
З imagefs та containerfs
Якщо на вузлі налаштована окрема containerfs разом із файловою системою imagefs, які використовують середовища виконання контейнерів, то kubelet намагатиметься звільнити ресурси таким чином:
Якщо файлова система containerfs досягає порогів виселення, kubelet виконує збір сміття для мертвих Podʼів і контейнерів.
Якщо файлова система imagefs досягає порогів виселення, kubelet видаляє всі невикористані образи.
Вибір Podʼів для виселення kubelet
Якщо спроби kubelet звільнити ресурси на рівні вузла не знижують сигнал виселення нижче порогу, kubelet починає виселяти Podʼи кінцевих користувачів.
Kubelet використовує наступні параметри для визначення порядку виселення Podʼів:
Чи перевищує використання ресурсів Podʼа їх запити
Використання ресурсів Podʼа в порівнянні з запитами
В результаті kubelet ранжує та виселяє Podʼи в наступному порядку:
Podʼи BestEffort або Burstable, де використання перевищує запити. Ці Podʼи виселяються на основі їх пріоритету, а потім за тим, наскільки їхнє використання перевищує запит.
Podʼи Guaranteed та Burstable, де використання менше за запити, виселяються останніми, на основі їх пріоритету.
Примітка:
Kubelet не використовує клас QoS Podʼа для визначення порядку виселення. Ви можете використовувати клас QoS для оцінки найбільш ймовірного порядку виселення Podʼів під час звільнення ресурсів, таких як памʼять. Класифікація QoS не застосовується до запитів EphemeralStorage, тому вищезазначений сценарій не буде застосовуватися, якщо вузол, наприклад, перебуває під DiskPressure.
Podʼи Guaranteed гарантовані лише тоді, коли для всіх контейнерів вказано запити та обмеження, і вони є однаковими. Ці Podʼи ніколи не будуть виселятися через споживання ресурсів іншим Podʼом. Якщо системний демон (наприклад, kubelet та journald) споживає більше ресурсів, ніж було зарезервовано за допомогою розподілів systemReserved або kubeReserved, і на вузлі залишилися лише Guaranteed або Burstable Podʼи, які використовують менше ресурсів, ніж запити, то kubelet повинен вибрати Pod для виселення для збереження стабільності вузла та обмеження впливу нестачі ресурсів на інші Podʼи. У цьому випадку він вибере Podʼи з найнижчим пріоритетом першими.
Якщо ви використовуєте статичний Pod і хочете уникнути його виселення під час нестачі ресурсів, встановіть поле priority для цього Podʼа безпосередньо. Статичні Podʼи не підтримують поле priorityClassName.
Коли kubelet виселяє Podʼи у відповідь на вичерпання inode або ідентифікаторів процесів, він використовує відносний пріоритет Podʼів для визначення порядку виселення, оскільки для inode та PID не існує запитів.
Kubelet сортує Podʼи по-різному залежно від того, чи є на вузлі окрема файлова система imagefs чи containerfs:
Без imagefs або containerfs (nodefs і imagefs використовують одну і ту ж файлову систему)
Якщо nodefs ініціює виселення, kubelet сортує Podʼи на основі їх загального використання диска (локальні томи + логи та записуваний шар усіх контейнерів).
З imagefs (nodefs і imagefs — окремі файлові системи)
Якщо nodefs ініціює виселення, kubelet сортує Podʼи на основі використання nodefs (локальні томи + логи всіх контейнерів).
Якщо imagefs ініціює виселення, kubelet сортує Podʼи на основі використання записуваного шару всіх контейнерів.
З imagefs та containerfs (imagefs та containerfs розділені)
Якщо containerfs ініціює виселення, kubelet сортує Podʼи на основі використання containerfs (локальні томи + логи та записуваний шар усіх контейнерів).
Якщо imagefs ініціює виселення, kubelet сортує Podʼи на основі ранжування storage of images, яке відображає використання диска для даного образу.
Мінімальне звільнення ресурсів під час виселення
Примітка:
Станом на Kubernetes v1.37 ви не можете встановити власне значення для метрики containerfs.available. Конфігурація для цієї конкретної метрики буде встановлена автоматично, щоб відображати значення, задані для nodefs або imagefs, залежно від конфігурації.
У деяких випадках виселення Podʼів звільняє лише невелику кількість дефіцитного ресурсу. Це може призвести до того, що kubelet раз у раз досягатиме налаштованих порогів виселення та ініціюватиме кілька виселень.
Ви можете використовувати поле evictionMinimumReclaim у файлі конфігурації kubelet для налаштування мінімальної кількості звільнення для кожного ресурсу. Коли kubelet помічає нестачу ресурсу, він продовжує звільняти цей ресурс, доки не звільнить кількість, яку ви вказали.
Наприклад, наступна конфігурація встановлює мінімальні кількості звільнення:
У цьому прикладі, якщо сигнал nodefs.available досягає порога виселення, kubelet звільняє ресурс, доки сигнал не досягне порога в 1GiB, а потім продовжує звільняти мінімальну кількість 500MiB, доки доступний обсяг сховища nodefs не досягне 1,5GiB.
Аналогічно, kubelet намагається звільнити ресурс imagefs, доки значення imagefs.available не досягне 102Gi, що представляє 102GiB доступного сховища для образів контейнерів. Якщо кількість сховища, яку може звільнити kubelet, менша за 2GiB, kubelet нічого не звільняє.
Стандартно evictionMinimumReclaim дорівнює 0 для всіх ресурсів.
Поведінка в разі вичерпання памʼяті на вузлі
Якщо вузол зазнає події out of memory (OOM) до того, як kubelet зможе звільнити памʼять, вузол залежить від реагування oom_killer.
Kubelet встановлює значення oom_score_adj для кожного контейнера на основі QoS для Podʼа.
Kubelet також встановлює значення oom_score_adj рівне -997 для будь-яких контейнерів у Podʼах, які мають пріоритетsystem-node-critical.
Якщо kubelet не може звільнити памʼять до того, як вузол зазнає OOM, oom_killer обчислює оцінку oom_score на основі відсотка памʼяті, яку він використовує на вузлі, а потім додає oom_score_adj, щоб отримати ефективну оцінку oom_score для кожного контейнера. Потім він примусово завершує роботу контейнера з найвищою оцінкою.
Це означає, що спочатку припиняється робота контейнерів у Podʼах низького QoS, які споживають велику кількість памʼяті в порівнянні з їх запитами на планування.
На відміну від виселення Podʼа, якщо роботу контейнера було припинено через вичерпання памʼяті, kubelet може перезапустити його відповідно до його restartPolicy.
Поради
У наступних розділах описано найкращі практики конфігурації виселення.
Ресурси, доступні для планування, та політики виселення
Під час конфігурації kubelet з політикою виселення слід переконатися, що планувальник не розміщуватиме Podʼи, які спричинять виселення через те, що вони одразу створюють тиск на памʼять.
Розгляньте такий сценарій:
Обсяг памʼяті вузла: 10GiB
Оператор бажає зарезервувати 10% обсягу памʼяті для системних демонів (ядро, kubelet тощо)
Оператор бажає виселяти Podʼи за використання памʼяті на рівні 95%, щоб зменшити кількість випадків OOM у системі.
Для цього файл конфігурації kubelet заповнюється таким чином:
У цій конфігурації systemReserved резервує 1,5GiB памʼяті для системи, що становить 10% від загальної памʼяті + кількість порогу виселення.
Вузол може досягти порогу виселення, якщо Pod використовує більше, ніж його запит, або якщо система використовує більше 1GiB памʼяті, що знижує значення memory.available нижче 500MiB і спричиняє спрацювання порогу.
DaemonSets та виселення внаслідок тиску на вузол
Пріоритет Podʼа — це основний фактор під час прийняття рішень про виселення. Якщо вам не потрібно, щоб kubelet виселяв Podʼи, які належать до DaemonSet, встановіть цим Podʼам достатньо високий пріоритет, вказавши відповідний priorityClassName в специфікації Podʼа. Ви також можете використовувати нижчий пріоритет або стандартне значення, щоб дозволити запускати Podʼи з цього DaemonSet тільки тоді, коли є достатньо ресурсів.
Відомі проблеми
У наступних розділах описані відомі проблеми, повʼязані з обробкою вичерпання ресурсів.
kubelet може помітити тиск на памʼять не одразу
Стандартно kubelet опитує cAdvisor, щоб регулярно збирати статистику використання памʼяті. Якщо використання памʼяті швидко зростає протягом цього інтервалу, kubelet може не помітити MemoryPressure достатньо швидко, і OOM killer все одно буде викликано.
Ви можете використовувати поле конфігурації kernelMemcgNotification, щоб увімкнути API сповіщення memcg в kubelet і отримувати повідомлення негайно, коли перетинається поріг.
Якщо ви прагнете не екстремального використання, а розумного рівня overcommit, робочим обхідним рішенням цієї проблеми є використання полів конфігурації kubeReserved та systemReserved для виділення памʼяті для системи.
active_file памʼять не вважається доступною памʼяттю
В Linux ядро відстежує кількість байтів файлової памʼяті в активному списку LRU (least recently used) як статистику active_file. Kubelet розглядає області памʼяті active_file як такі, що не підлягають звільненню. Для робочих навантажень, що інтенсивно використовують локальне сховище з блоковою підтримкою, включаючи ефемерне локальне сховище, кеші ядра для файлів і блоків означають, що багато нещодавно використаних сторінок кеша, ймовірно, будуть враховані як active_file. Якщо достатньо цих буферів блоків ядра перебувають на активному списку LRU, kubelet може сприйняти це як високе використання ресурсів та накласти на вузол taint тиску на памʼять, що ініціює виселення Podʼів.
Ви можете обійти цю проблему, встановивши для контейнерів, які ймовірно виконують інтенсивну діяльність з операцій введення/виведення, однакове обмеження памʼяті та запит памʼяті. Вам потрібно оцінити або виміряти оптимальне значення обмеження памʼяті для цього контейнера.
This is a stable feature in Kubernetes, and has been since version v1.37. It was first available in the v1.35 release. You can no longer disable or opt out of this feature or behavior (it is locked); if you explicitly set a value for the associated feature gate NodeDeclaredFeatures, Kubernetes ignores it but does not report any error.
Вузли Kubernetes використовують оголошені можливості для повідомлення про доступність конкретних можливостей, які є новими або вмикаються через feature gate. Компоненти панелі управління використовують цю інформацію для прийняття кращих рішень. Kube-scheduler за допомогою втулка NodeDeclaredFeatures гарантує, що Podʼи розміщуються тільки на вузлах, які явно підтримують можливості, необхідні для Podʼа. Крім того, контролер допуску NodeDeclaredFeatureValidator перевіряє оновлення Podʼів на відповідність оголошеним можливостям вузла.
Цей механізм допомагає керувати розбіжностями версій і покращувати стабільність кластера, особливо під час оновлення кластера або в середовищах зі змішаними версіями, де не на всіх вузлах можуть бути увімкнені однакові можливості. Він призначений для розробників можливостей Kubernetes, які впроваджують нові можливості на рівні вузлів, і працює у фоновому режимі; розробникам застосунків, які розгортають Podʼи, не потрібно безпосередньо взаємодіяти з цим механізмом.
Як це працює
Оголошена можливість — це рядок, який вузол перелічує в полі .status.declaredFeatures обʼєкта Node. Кожна можливість, яку можна оголосити, ідентифікує можливість на рівні вузла, яка все ще проходить через етапи розвитку можливостей Kubernetes.
Звіт про можливості Kubelet: під час запуску kubelet на кожному вузлі виявляє, які керовані можливості Kubernetes наразі увімкнені, і повідомляє про них у полі .status.declaredFeatures вузла. У це поле включаються лише можливості, що активно розробляються.
Фільтрування планувальника: стандартний планувальник kube-scheduler використовує втулок NodeDeclaredFeatures. Цей втулок:
На етапі PreFilter перевіряє PodSpec, щоб визначити набір можливостей вузла, необхідних для Podʼа.
На етапі Filter перевіряє, чи можливості, перелічені в .status.declaredFeatures вузла, відповідають вимогам, визначеним для Podʼа. Podʼи не плануються на вузлах, які не мають необхідних можливостей.
Власні планувальники також можуть використовувати поле .status.declaredFeatures для застосування подібних обмежень.
Контроль допуску: Контролер допуску NodeDeclaredFeatureValidator може відхиляти Podʼи, які вимагають можливостей, не оголошених вузлом, до якого вони привʼязані, запобігаючи проблемам під час оновлення Podʼів.
Допуск Kubelet: Як останній запобіжний захід, kubelet повторно перевіряє вимоги Podʼа до можливостей на відповідність можливостям, доступним на його вузлі, перед запуском Podʼа, і відхиляє Pod, якщо необхідна можливість відсутня.
Очищення після GA: Коли можливість стає доступною на всіх вузлах кластера (після того, як можливість переходить до GA і підтримувана розбіжність версій між панеллю управління та вузлами минула), вузли припиняють оголошувати можливість. Це досягається шляхом встановлення максимальної версії (MaxVersion) для кожної оголошеної можливості: kubeletʼи новіші за цю версію припиняють перелічувати можливість в .status.declaredFeatures, а планувальник і контролер допуску вважають можливість загальнодоступною та припиняють її перевіряти. Можливість зрештою видаляється з набору оголошених можливостей у рамках стандартного очищення можливостей після GA.
Pod вимагає цю можливість, якщо один із його контейнерів вказує правило перезапуску з дією RestartAllContainers:
apiVersion:v1kind:Podmetadata:name:example-podspec:containers:- name:mainimage:registry.k8s.io/busybox:1.27.2restartPolicy:Never # Якщо визначено правила, необхідно вказати політику перезапуску контейнераrestartPolicyRules:# Перезапустити весь Pod на місці за коду виходу 42- action:RestartAllContainersexitCodes:operator:Invalues:[42]
Під час планування цього Podʼа kube-scheduler розглядає лише вузли, які перелічують RestartAllContainersOnContainerExits у своєму .status.declaredFeatures. У кластері, де лише деякі вузли мають увімкнену цю функціональну можливість (наприклад, у середині оновлення кластера), це запобігає призначенню Podʼа вузлу, чий kubelet ігнорував би правило перезапуску.
Оголошені можливості також обмежують оновлення запущених Podʼів. Наприклад, оголошена можливість InPlacePodVerticalScalingInitContainers вказує, що вузол підтримує зміну розміру ресурсів init-контейнерів на місці. Якщо є спроба змінити розмір init-контейнера в запущеному Podʼі, контролер допуску NodeDeclaredFeatureValidator відхиляє оновлення, якщо вузол, на якому працює цей Pod, не оголошує цю можливість.