Цей розділ документації Kubernetes допоможе вам навчитися запускати робочі навантаження безпечніше й дізнатися про основні аспекти забезпечення безпеки кластера Kubernetes.
Kubernetes базується на архітектурі cloud native і спирається на поради CNCF щодо рекомендованих практик інформаційної безпеки cloud native.
Ширший контекст щодо того, як захистити ваш кластер і застосунки, які ви на ньому запускаєте, дивіться в розділі Безпека cloud native та Kubernetes.
Механізми безпеки Kubernetes
Kubernetes містить кілька API та засобів контролю безпеки, а також способи визначення політик, які можуть бути частиною вашого керування інформаційною безпекою.
Kubernetes очікує, що ви налаштуєте та використовуватимете TLS для шифрування даних під час передавання в межах панелі управління та між панеллю управління і її клієнтами. Ви також можете ввімкнути шифрування даних у стані спокою для даних, що зберігаються в панелі управління Kubernetes; це окремо від шифрування в стані спокою для даних ваших власних робочих навантажень, що також може бути доброю ідеєю.
Secrets
API Secret надає базовий захист для конфіденційних значень конфігурації.
Захист робочих навантажень
Застосовуйте стандарти безпеки Podʼів, щоб Podʼи та їхні контейнери були належно ізольовані. Якщо потрібно, ви також можете використовувати RuntimeClasses для визначення власної ізоляції.
Мережеві політики дозволяють вам контролювати мережевий трафік між Podʼами або між Podʼами та мережею поза вашим кластером.
Ви можете розгортати засоби безпеки з ширшої екосистеми, щоб реалізувати превентивний або детективний контроль для Podʼів, їхніх контейнерів та образів, що в них працюють.
Контроль допуску
Контролери допуску — це втулки, які перехоплюють запити до API Kubernetes і можуть перевіряти або змінювати їх на основі певних полів запиту. Продумане проєктування цих контролерів допомагає уникнути ненавмисних порушень, коли API Kubernetes змінюється з оновленнями версій. Міркування щодо проєктування дивіться в розділі Рекомендації щодо використання вебхуків допуску.
Аудит
Логування аудиту Kubernetes забезпечує важливий для безпеки хронологічний набір записів, що документують послідовність дій у кластері. Кластер проводить аудит дій користувачів, застосунків, які використовують API Kubernetes, і самої панелі управління.
Безпека хмарних провайдерів
Примітка: На цій сторінці є посилання на постачальників, які не належать до Kubernetes. Автори проєкту Kubernetes не несуть відповідальності за ці сторонні продукти або проєкти. Для додавання постачальника, продукта або проєкта до цього списку, ознайомтеся з настановами щодо вмісту перед додаванням змін. Додаткова інформація.
Якщо ви запускаєте кластер Kubernetes на власному обладнанні або в іншого хмарного провайдера, ознайомтеся з рекомендаціями щодо безпеки у вашій документації. Ось посилання на документацію з безпеки деяких популярних хмарних провайдерів:
Ви можете визначати політики безпеки за допомогою вбудованих механізмів Kubernetes, таких як NetworkPolicy (декларативний контроль фільтрації мережевих пакетів) або ValidatingAdmissionPolicy (декларативні обмеження на те, які зміни можна вносити через API Kubernetes).
Однак ви також можете покладатися на реалізації політик із ширшої екосистеми навколо Kubernetes. Kubernetes надає механізми розширення, завдяки яким проєкти екосистеми можуть реалізовувати власні засоби контролю політик щодо перевірки вихідного коду, схвалення образів контейнерів, контролю доступу до API, мережі тощо.
Докладніше про механізми політик у Kubernetes читайте в розділі Політики.
Концепції захисту ваших робочих навантажень cloud native.
Kubernetes базується на архітектурі cloud native і спирається на поради CNCF щодо рекомендованих практик інформаційної безпеки cloud native.
Нижче наведено огляд того, як Kubernetes допомагає розгорнути безпечну платформу cloud native.
Інформаційна безпека cloud native
У white paper CNCF про безпеку cloud native визначено засоби контролю та практики безпеки для різних фаз життєвого циклу.
Фаза життєвого циклу Розробка
Забезпечте цілісність середовищ розробки.
Проєктуйте застосунки відповідно до рекомендованих практик інформаційної безпеки, що підходять для вашого контексту.
Враховуйте безпеку кінцевого користувача як частину проєктного рішення.
Для цього:
Використовуйте архітектуру, таку як нульова довіра, що мінімізує поверхню атаки навіть для внутрішніх загроз.
Визначте процес перевірки коду, який враховує питання безпеки.
Створіть модель загроз вашої системи або застосунку, яка визначає межі довіри. Використовуйте цю модель, щоб виявляти ризики й визначати, як із ними працювати.
Там, де це виправдано, впроваджуйте передову автоматизацію безпеки, таку як fuzzing та security chaos engineering.
Фаза життєвого циклу Розповсюдження
Забезпечте безпеку ланцюга постачання образів контейнерів, які ви запускаєте.
Забезпечте безпеку ланцюга постачання кластера та інших компонентів, які запускають ваш застосунок. Наприклад, це може бути зовнішня база даних, яку ваш застосунок cloud native використовує для зберігання даних.
Для цього:
Скануйте образи контейнерів та інші артефакти на наявність відомих вразливостей.
Переконайтеся, що розповсюдження програмного забезпечення використовує шифрування під час передавання з ланцюгом довіри до джерела програмного забезпечення.
Запровадьте процеси оновлення залежностей, коли стають доступні оновлення, особливо у відповідь на оголошення про безпеку, і дотримуйтеся їх.
Використовуйте механізми перевірки, такі як цифрові сертифікати, для гарантії безпеки ланцюга постачання.
Підписуйтесь на стрічки (feeds) та інші механізми, щоб отримувати сповіщення про безпекові ризики.
Обмежуйте доступ до артефактів. Розміщуйте образи контейнерів у приватному реєстрі, який дозволяє завантажувати образи лише авторизованим клієнтам.
Фаза життєвого циклу Розгортання
Забезпечте відповідні обмеження на те, що можна розгортати, хто може це робити й куди це можна розгорнути. Ви можете застосовувати заходи з фази розповсюдження, такі як перевірка криптографічної ідентичності артефактів образів контейнерів.
Ви можете розгортати різні застосунки та компоненти кластера в різних просторах імен. Контейнери та простори імен забезпечують механізми ізоляції, що є важливими для інформаційної безпеки.
Під час розгортання Kubernetes ви також закладаєте основу для середовища виконання ваших застосунків: кластер Kubernetes (або кілька кластерів). Ця інфраструктура має забезпечувати гарантії безпеки, яких очікують вищі рівні.
API Kubernetes — це те, завдяки чому працює ваш кластер. Захист цього API є ключовим для ефективної безпеки кластера.
Інші сторінки документації Kubernetes докладніше описують, як налаштувати окремі аспекти контролю доступу. Список перевірки безпеки містить рекомендовані базові перевірки для вашого кластера.
Крім того, захист кластера означає впровадження ефективної автентифікації та авторизації для доступу до API. Використовуйте ServiceAccounts, щоб надавати ідентичності безпеки робочим навантаженням і компонентам кластера та керувати ними.
Kubernetes використовує TLS для захисту трафіку API; переконайтеся, що кластер розгорнуто з TLS (зокрема для трафіку між вузлами та панеллю управління), і захистіть ключі шифрування. Якщо ви використовуєте власний API Kubernetes для CertificateSigningRequests, приділіть особливу увагу обмеженню зловживань ним.
Захист під час виконання: обчислення
Контейнери забезпечують дві речі: ізоляцію між застосунками та механізм обʼєднання цих ізольованих застосунків для роботи на одному хост-компʼютері. Ці два аспекти — ізоляція та агрегація — означають, що безпека під час виконання передбачає пошук компромісів і відповідного балансу.
Kubernetes покладається на середовище виконання контейнерів для налаштування та запуску контейнерів. Проєкт Kubernetes не рекомендує конкретне середовище виконання контейнерів, і вам слід переконатися, що вибране середовище відповідає вашим потребам в інформаційній безпеці.
Для захисту обчислень під час виконання ви можете:
Застосовувати до застосунків стандарти безпеки Podʼів, щоб вони працювали лише з потрібними привілеями.
Запускати на вузлах спеціалізовану операційну систему, призначену саме для контейнеризованих робочих навантажень. Зазвичай вона базується на операційній системі лише для читання (незмінний образ), яка надає тільки сервіси, необхідні для запуску контейнерів.
Операційні системи для контейнерів допомагають ізолювати системні компоненти та зменшують поверхню атаки в разі виходу за межі контейнера.
Визначати ResourceQuotas для справедливого розподілу спільних ресурсів і використовувати механізми, такі як LimitRanges, щоб Podʼи вказували свої вимоги до ресурсів.
Розподіляти робочі навантаження між різними вузлами для кращої ізоляції. Використовувати механізми ізоляції вузлів із самого Kubernetes або з екосистеми, щоб Podʼи з різними контекстами довіри працювали на окремих наборах вузлів.
Захистіть стійкість даних за допомогою резервних копій і перевіряйте, що можете відновити їх, коли це потрібно.
Автентифікуйте зʼєднання між вузлами кластера та будь-яким мережевим сховищем, на яке вони спираються.
Впровадьте шифрування даних у межах вашого власного застосунку.
Генерація ключів шифрування на спеціалізованому обладнанні забезпечує найкращий захист від ризиків розголошення. Апаратний модуль безпеки дозволяє виконувати криптографічні операції без можливості копіювання ключа безпеки в інше місце.
Мережа та безпека
Також варто врахувати заходи мережевої безпеки, такі як NetworkPolicy або service mesh. Деякі мережеві втулки для Kubernetes шифрують мережу кластера за допомогою таких технологій, як оверлей віртуальної приватної мережі (VPN). За задумом Kubernetes дозволяє використовувати власний мережевий втулок для кластера. Якщо ви використовуєте керований Kubernetes, провайдер міг уже вибрати мережевий втулок за вас.
Мережевий втулок, який ви виберете, і спосіб його інтеграції можуть суттєво вплинути на безпеку інформації під час передавання.
Спостережуваність та безпека виконання
Kubernetes дозволяє розширювати кластер додатковими інструментами. Ви можете налаштувати сторонні рішення для моніторингу або усунення несправностей ваших застосунків і кластерів, у яких вони працюють. Ви також отримуєте деякі базові можливості спостережуваності, вбудовані в сам Kubernetes. Ваш код у контейнерах може генерувати логи, публікувати метрики або надавати інші дані спостережуваності; під час розгортання потрібно переконатися, що ваш кластер забезпечує для них відповідний рівень захисту.
Якщо ви налаштовуєте dashboard метрик або щось подібне, перегляньте ланцюжок компонентів, які передають дані до цього dashboard, а також сам dashboard. Переконайтеся, що весь ланцюжок має достатню стійкість і захист цілісності, щоб на нього можна було покластися навіть під час інциденту, коли робота вашого кластера може погіршитися.
За потреби розгортайте заходи безпеки нижче рівня Kubernetes, такі як криптографічно вимірюване завантаження або автентифікований розподіл часу (що допомагає забезпечити точність логів і записів аудиту).
Для середовищ із високим рівнем гарантій розгортайте криптографічний захист, щоб логи були захищені від підробки й конфіденційні.
Огляд контролера Pod Security Admission, який може застосовувати стандарти безпеки Podʼів.
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.25
Стандарти безпеки Podʼів Kubernetes визначають різні рівні ізоляції для Podʼів. Ці стандарти дозволяють чітко й послідовно визначити, як ви хочете обмежувати поведінку Podʼів.
Kubernetes пропонує вбудований контролер допускуPod Security для застосування стандартів безпеки Podʼів. Обмеження безпеки Podʼів застосовуються на рівні простору імен під час створення Podʼів.
Вбудоване застосування Pod Security admission
Ця сторінка є частиною документації Kubernetes v1.37. Якщо ви використовуєте іншу версію Kubernetes, перегляньте документацію для цієї версії.
Після ввімкнення можливості або встановлення вебхука ви можете налаштувати простори імен, щоб визначити режим контролю допуску, який використовуватиметься для безпеки Podʼів у кожному просторі імен. Kubernetes визначає набір міток, які можна встановити, щоб вибрати попередньо визначений рівень стандарту безпеки Podʼів для простору імен. Вибрана мітка визначає, яку дію виконає панель управління, якщо виявлено потенційне порушення:
Режими Pod Security Admission
Режим
Опис
enforce
Порушення політики призводить до відхилення Podʼа.
audit
Порушення політики спричиняє додавання анотації аудиту до події, записаної в лог аудиту, але в іншому Pod дозволяється.
warn
Порушення політики спричиняє попередження для користувача, але в іншому Pod дозволяється.
Простір імен може налаштувати будь-який або всі режими, або навіть встановити різний рівень для різних режимів.
Для кожного режиму існують дві мітки, які визначають використовувану політику:
# Мітка рівня режиму вказує, який рівень політики застосовується для режиму.## РЕЖИМ повинен бути одним з `enforce`, `audit` або `warn`.# РІВЕНЬ повинен бути одним з `privileged`, `baseline` або `restricted`.pod-security.kubernetes.io/<РЕЖИМ>:<РІВЕНЬ># Необовʼязково: мітка версії режиму, яку можна використовувати для привʼязки політики до# версії, що поставляється з певною мінорною версією Kubernetes (наприклад, v1.37).## РЕЖИМ повинен бути одним з `enforce`, `audit` або `warn`.# ВЕРСІЯ повинна бути дійсною мінорною версією Kubernetes або `latest`.pod-security.kubernetes.io/<РЕЖИМ>-version:<ВЕРСІЯ>
Podʼи часто створюються опосередковано, через створення обʼєкта робочого навантаження, такого як Deployment або Job. Обʼєкт робочого навантаження визначає шаблон Podʼа, а контролер ресурсу робочого навантаження створює Podʼи на основі цього шаблону. Щоб вчасно виявляти порушення, режими audit та warn застосовуються до ресурсів робочих навантажень. Однак режим enforce не застосовується до ресурсів робочих навантажень, а лише до створених обʼєктів Pod.
Винятки
Ви можете визначити винятки із застосування безпеки Podʼів, щоб дозволити створення Podʼів, які інакше були б заборонені політикою відповідного простору імен. Винятки можна статично налаштувати в конфігурації контролера допуску.
Винятки мають бути явно перелічені. Запити, що відповідають критеріям винятків, контролер допуску ігнорує (уся поведінка enforce, audit та warn пропускається). Виміри винятків:
Usernames: запити від користувачів з автентифікованим (або імперсонованим) іменем, внесеним до винятків, ігноруються.
RuntimeClassNames: Podʼи та ресурси робочих навантажень, що вказують назву класу виконання, внесену до винятків, ігноруються.
Більшість Podʼів створює контролер у відповідь на ресурс робочого навантаження, тому виняток для кінцевого користувача звільнить його від застосування політики лише під час безпосереднього створення Podʼів, але не під час створення ресурсу робочого навантаження. ServiceAccount контролерів (наприклад, system:serviceaccount:kube-system:replicaset-controller) зазвичай не слід вносити до винятків, оскільки це неявно звільнить будь-якого користувача, який може створити відповідний ресурс робочого навантаження.
Оновлення таких полів Podʼа звільнені від перевірок політики, тобто якщо запит на оновлення Podʼа змінює лише ці поля, його не буде відхилено, навіть якщо Pod порушує поточний рівень політики:
Будь-які оновлення метаданих, крім змін анотацій seccomp або AppArmor:
pod_security_errors_total: Ця метрика показує кількість помилок, що перешкоджають звичайному оцінюванню. Нефатальні помилки можуть призвести до застосування останнього профілю restricted.
pod_security_evaluations_total: Ця метрика показує кількість виконаних оцінювань політики, не враховуючи проігноровані запити або запити-винятки під час експорту.
pod_security_exemptions_total: Ця метрика показує кількість запитів-винятків, не враховуючи проігноровані запити або запити поза областю дії.
Дізнайтеся про обʼєкти ServiceAccount в Kubernetes.
На цій сторінці описано обʼєкт ServiceAccount у Kubernetes: як працюють ServiceAccount, сценарії використання, обмеження, альтернативи та посилання на ресурси з додатковими настановами.
Що таке ServiceAccount?
ServiceAccount — це тип облікового запису не для людей, який у Kubernetes надає окрему ідентичність у кластері. Podʼи застосунків, системні компоненти та сутності всередині й поза кластером можуть використовувати облікові дані певного ServiceAccount, щоб ідентифікуватися як цей ServiceAccount. Така ідентичність корисна в різних ситуаціях, зокрема для автентифікації на API-сервері або реалізації політик безпеки на основі ідентичності.
ServiceAccount існують як обʼєкти ServiceAccount на API-сервері. Вони мають такі властивості:
Привʼязані до простору імен: Кожен ServiceAccount привʼязаний до простору імен Kubernetes. Кожен простір імен під час створення отримує ServiceAccount default.
Легкі: ServiceAccount існують у кластері й визначені в API Kubernetes. Ви можете швидко створювати ServiceAccount для виконання певних завдань.
Переносні: Набір конфігурацій для складного контейнеризованого робочого навантаження може містити визначення ServiceAccount для компонентів системи. Легкість ServiceAccount та ідентичності в межах простору імен роблять конфігурації переносними.
ServiceAccount відрізняються від облікових записів користувачів, які є автентифікованими людьми в кластері. Стандартно облікові записи користувачів не існують на API-сервері Kubernetes; натомість API-сервер розглядає ідентичності користувачів як непрозорі дані. Автентифікуватися як обліковий запис користувача можна кількома способами. Деякі дистрибутиви Kubernetes можуть додавати власні API розширення для представлення облікових записів користувачів на API-сервері.
RBAC Kubernetes або інші механізми керування ідентичністю та доступом
Призначення
Робочі навантаження, автоматизація
Люди
Стандартні ServiceAccount
Під час створення кластера Kubernetes автоматично створює обʼєкт ServiceAccount з назвою default для кожного простору імен у вашому кластері. ServiceAccount default у кожному просторі імен стандартно не мають дозволів, окрім стандартних дозволів на виявлення API, які Kubernetes надає всім автентифікованим субʼєктам, якщо ввімкнено контроль доступу на основі ролей (RBAC). Якщо ви видалите обʼєкт ServiceAccount default у просторі імен, панель управління замінить його новим.
Загалом ви можете використовувати ServiceAccount для надання ідентичностей у таких сценаріях:
Вашим Podʼам потрібно взаємодіяти з API-сервером Kubernetes, наприклад у таких ситуаціях:
Надання доступу лише для читання до конфіденційної інформації, що зберігається в Secrets.
Надання доступу між просторами імен, наприклад дозвіл Podʼу в просторі імен example читати, перелічувати й відстежувати обʼєкти Lease у просторі імен kube-node-lease.
Вашим Podʼам потрібно взаємодіяти із зовнішнім сервісом. Наприклад, Pod робочого навантаження потребує ідентичності для комерційного хмарного API, а комерційний постачальник дозволяє налаштувати відповідні довірчі стосунки.
Зовнішньому сервісу потрібно взаємодіяти з API-сервером Kubernetes. Наприклад, автентифікація в кластері як частина конвеєра CI/CD.
Ви використовуєте у своєму кластері стороннє програмне забезпечення безпеки, яке покладається на ідентичність ServiceAccount різних Podʼів, щоб групувати ці Podʼи в різні контексти.
Як використовувати ServiceAccount
Щоб скористатися ServiceAccount у Kubernetes, виконайте такі дії:
Створіть обʼєкт ServiceAccount за допомогою клієнта Kubernetes, такого як kubectl, або за допомогою маніфесту, який визначає обʼєкт.
Надайте дозволи обʼєкту ServiceAccount за допомогою механізму авторизації, такого як RBAC.
Призначте обʼєкт ServiceAccount Podʼам під час створення Podʼа.
Якщо ви використовуєте ідентичність із зовнішнього сервісу, отримайте токен ServiceAccount і використовуйте його з цього сервісу.
Ви можете використовувати вбудований у Kubernetes механізм контролю доступу на основі ролей (RBAC), щоб надавати кожному ServiceAccount мінімально потрібні дозволи. Ви створюєте роль, яка надає доступ, а потім привʼязуєте її до свого ServiceAccount. RBAC дозволяє визначити мінімальний набір дозволів, щоб дозволи ServiceAccount відповідали принципу найменших привілеїв. Podʼи, що використовують цей ServiceAccount, не отримують більше дозволів, ніж потрібно для правильної роботи.
Доступ між просторами імен за допомогою ServiceAccount
За допомогою RBAC можна дозволити ServiceAccount в одному просторі імен виконувати дії з ресурсами в іншому просторі імен кластера. Наприклад, у вас є ServiceAccount і Pod у просторі імен dev, і ви хочете, щоб ваш Pod бачив Jobs, що виконуються в просторі імен maintenance. Ви можете створити обʼєкт Role, який надає дозволи на перелік обʼєктів Job. Потім створіть обʼєкт RoleBinding у просторі імен maintenance, щоб привʼязати Role до обʼєкта ServiceAccount. Тепер Podʼи у просторі імен dev можуть отримувати перелік обʼєктів Job у просторі імен maintenance, використовуючи цей ServiceAccount.
Призначення ServiceAccount Podʼу
Щоб призначити ServiceAccount Podʼу, встановіть поле spec.serviceAccountName у специфікації Podʼа. Після цього Kubernetes автоматично надає Podʼу облікові дані цього ServiceAccount. У v1.22 і новіших Kubernetes отримує короткостроковий токен з автоматичною ротацією через API TokenRequest і монтує його як проєкційний том.
Стандартно Kubernetes надає Podʼу облікові дані призначеного ServiceAccount, будь то ServiceAccount default чи вказаний вами власний ServiceAccount.
Щоб Kubernetes не додавав автоматично облікові дані вказаного ServiceAccount або ServiceAccount default, встановіть поле automountServiceAccountToken у специфікації Podʼа в false.
У версіях до 1.22 Kubernetes надає Podʼу довгостроковий статичний токен як Secret.
Отримання облікових даних ServiceAccount вручну
Якщо облікові дані ServiceAccount потрібно змонтувати в нестандартне місце або вони потрібні для аудиторії, відмінної від API-сервера, скористайтеся одним із таких методів:
TokenRequest API (рекомендовано): Запитуйте короткостроковий токен ServiceAccount безпосередньо з коду вашого застосунку. Строк дії токена спливає автоматично, і після цього токен можна ротувати. Якщо у вас є застарілий застосунок, який не знає про Kubernetes, ви можете використати sidecar-контейнер у тому самому Podʼі, щоб отримувати ці токени й надавати їх робочому навантаженню застосунку.
Token Volume Projection (також рекомендовано): У Kubernetes v1.20 і новіших вкажіть у специфікації Podʼа, щоб kubelet додав токен ServiceAccount до Podʼа як проєкційний том. Строк дії спроєцьованих токенів спливає автоматично, а kubelet ротує токен до завершення строку дії.
Service Account Token Secrets (не рекомендовано): Ви можете монтувати токени ServiceAccount як Secrets Kubernetes у Podʼах. Ці токени не мають строку дії й не ротуються. У версіях до v1.24 для кожного ServiceAccount автоматично створювався постійний токен. Цей метод більше не рекомендується, особливо у великому масштабі, через ризики, повʼязані зі статичними довгостроковими обліковими даними. Функціональна можливість LegacyServiceAccountTokenNoAutoGeneration (стандартно ввімкнена в Kubernetes з v1.24 до v1.26) не давала Kubernetes автоматично створювати ці токени для ServiceAccount. Її вилучено у v1.27, оскільки вона перейшла на стадію GA; ви все ще можете вручну створювати безстрокові токени ServiceAccount, але маєте враховувати наслідки для безпеки.
Обмеження аудиторій вузлів для токенів ServiceAccount
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.33; (стандартно увімкнено)
Коли ввімкнено функціональну можливість ServiceAccountNodeAudienceRestriction, втулок допуску NodeRestriction обмежує аудиторії, які kubelet може запитувати під час створення токенів ServiceAccount через API TokenRequest. Стандартно kubelet може запитувати токени лише для аудиторій, на які вже посилаються Podʼи на цьому вузлі (через проєкційні томи токенів ServiceAccount або запити токенів драйвера CSI). Адміністратори можуть надати kubelet доступ до додаткових аудиторій за допомогою правил RBAC із дієсловом request-serviceaccounts-token-audience.
Це обмеження застосовується лише до kubelet (ідентичностей вузлів) і не впливає на інших клієнтів API TokenRequest. Подробиці та приклади RBAC дивіться в розділі Обмеження аудиторії токенів ServiceAccount.
Примітка:
Для застосунків, що працюють поза вашим кластером Kubernetes, ви можете розглядати створення довгострокового токена ServiceAccount, який зберігається в Secret. Це дозволяє автентифікацію, але проєкт Kubernetes рекомендує уникати такого підходу. Довгострокові токени-предʼявники є ризиком для безпеки, оскільки після розкриття токен можна використати зловмисно. Натомість розгляньте альтернативу. Наприклад, ваш зовнішній застосунок може автентифікуватися за допомогою добре захищеного приватного ключа та сертифіката або власного механізму, такого як вебхук автентифікації, який ви реалізуєте самостійно.
Ви також можете використовувати TokenRequest для отримання короткострокових токенів для вашого зовнішнього застосунку.
Обмеження доступу до Secrets (застаріло)
СТАН ФУНКЦІОНАЛУ:Deprecated since Kubernetes v1.32
Примітка:
kubernetes.io/enforce-mountable-secrets застаріло, починаючи з Kubernetes v1.32. Використовуйте окремі простори імен, щоб ізолювати доступ до змонтованих Secrets.
Kubernetes надає анотацію kubernetes.io/enforce-mountable-secrets, яку можна додати до ваших ServiceAccounts. Коли цю анотацію застосовано, Secrets цього ServiceAccount можна монтувати лише на вказані типи ресурсів, що покращує безпеку кластера.
Ви можете додати анотацію до ServiceAccount за допомогою маніфесту:
Коли цю анотацію встановлено в "true", панель управління Kubernetes гарантує, що на Secrets цього ServiceAccount поширюються певні обмеження монтування.
Назва кожного Secret, змонтованого як том у Podʼі, має бути в полі secrets ServiceAccount цього Podʼа.
Назва кожного Secret, на який посилається envFrom у Podʼі, також має бути в полі secrets ServiceAccount цього Podʼа.
Назва кожного Secret, на який посилається imagePullSecrets у Podʼі, також має бути в полі secrets ServiceAccount цього Podʼа.
Розуміючи та застосовуючи ці обмеження, адміністратори кластера можуть посилити захист і забезпечити доступ до Secrets лише для відповідних ресурсів.
Автентифікація облікових даних ServiceAccount
ServiceAccounts використовують підписані JSON Web Tokens (JWT) для автентифікації на API-сервері Kubernetes та в будь-якій іншій системі, де є довірчі стосунки. Залежно від того, як видано токен (обмежений у часі через TokenRequest чи застарілим механізмом із Secret), токен ServiceAccount може також мати час завершення дії, аудиторію та час, з якого токен починає діяти. Коли клієнт, що діє як ServiceAccount, звертається до API-сервера Kubernetes, він додає до HTTP-запиту заголовок Authorization: Bearer <token>. API-сервер перевіряє чинність цього токена так:
Перевіряє підпис токена.
Перевіряє, чи не закінчився строк дії токена.
Перевіряє, чи чинні наразі посилання на обʼєкти в твердженнях токена.
Перевіряє, чи чинний наразі токен.
Перевіряє твердження про аудиторію.
TokenRequest API створює привʼязані токени для ServiceAccount. Ця привʼязка повʼязана з часом життя клієнта, такого як Pod, що діє як цей ServiceAccount. Приклад схеми JWT та вмісту привʼязаного токена ServiceAccount Podʼа дивіться в розділі Token Volume Projection.
Для токенів, виданих через API TokenRequest, API-сервер також перевіряє, що обʼєкт, який використовує ServiceAccount, все ще існує, зіставляючи його за унікальним ідентифікатором. Для застарілих токенів, змонтованих як Secrets у Podʼах, API-сервер звіряє токен із Secret.
Докладніше про процес автентифікації дивіться в розділі Автентифікація.
Автентифікація облікових даних ServiceAccount у власному коді
Якщо у вас є власні сервіси, яким потрібно перевіряти облікові дані ServiceAccount Kubernetes, можна скористатися такими методами:
Проєкт Kubernetes рекомендує використовувати TokenReview API, оскільки цей метод анулює токени, привʼязані до обʼєктів API, таких як Secrets, ServiceAccounts, Podʼи або вузли, коли ці обʼєкти видаляються. Наприклад, якщо ви видалите Pod, що містить спроєцьований токен ServiceAccount, кластер негайно анулює цей токен, і TokenReview одразу завершиться невдачею. Якщо натомість використовувати перевірку OIDC, ваші клієнти й надалі вважатимуть токен дійсним, доки не настане час завершення його дії.
Ваш застосунок завжди має визначати аудиторію, яку він приймає, і перевіряти, що аудиторії токена відповідають очікуваним. Це допомагає звузити область дії токена, щоб його можна було використовувати лише у вашому застосунку й ніде більше.
Альтернативи
Видавайте власні токени за допомогою іншого механізму, а потім використовуйте автентифікацію за токеном через вебхук, щоб перевіряти токени-предʼявники власним сервісом перевірки.
Використовуйте ServiceAccount або облікові записи користувачів, створені у зовнішньому сервісі керування ідентичністю та доступом (IAM), наприклад у хмарного провайдера, для автентифікації у вашому кластері.
Використовуйте втулок пристроїв, щоб отримати доступ до віртуального Trusted Platform Module (TPM), який дозволяє автентифікуватися за допомогою приватного ключа.
Якщо ви не використовуєте Kubernetes v1.37, перевірте документацію для вашої версії Kubernetes.
5 - Безпека для вузлів Linux
На цій сторінці описано міркування щодо безпеки та рекомендації, специфічні для операційної системи Linux.
Захист даних Secret на вузлах
На вузлах Linux томи в памʼяті (наприклад, монтування томів secret або emptyDir з medium: Memory) реалізовано за допомогою файлової системи tmpfs.
Якщо у вас налаштовано своп і ви використовуєте старе ядро Linux (або поточне ядро та непідтримувану конфігурацію Kubernetes), дані з томів у памʼяті можуть записуватися в постійне сховище.
Ядро Linux офіційно підтримує параметр noswap з версії 6.3, тому, якщо на вузлі ввімкнено своп, рекомендується використовувати ядро версії 6.3 або новіше чи ядро з підтримкою параметра noswap через бекпорт.
На цій сторінці описано міркування щодо безпеки та рекомендації, специфічні для операційної системи Windows.
Захист даних Secret на вузлах
У Windows дані з Secrets записуються у відкритому вигляді в локальне сховище вузла (на відміну від tmpfs / файлових систем у памʼяті в Linux). Як оператору кластера вам слід вжити обох наведених нижче додаткових заходів:
Використовуйте ACL файлів, щоб захистити розташування файлів Secrets.
Застосовуйте шифрування на рівні тому за допомогою BitLocker.
Користувачі контейнерів
RunAsUsername можна вказати для Podʼів або контейнерів Windows, щоб виконувати процеси контейнера від імені конкретного користувача. Це приблизний еквівалент RunAsUser.
Контейнери Windows мають два стандартні облікові записи користувачів: ContainerUser та ContainerAdministrator. Різницю між цими обліковими записами описано в розділі When to use ContainerAdmin and ContainerUser user accounts документації Microsoft Secure Windows containers.
Локальних користувачів можна додавати до образів контейнерів під час їх збирання.
Примітка:
Образи на основі Nano Server стандартно запускаються як ContainerUser
Образи на основі Server Core стандартно запускаються як ContainerAdministrator
Специфічні для Linux механізми контексту безпеки Podʼів (такі як SELinux, AppArmor, Seccomp або власні POSIX capabilities) не підтримуються на вузлах Windows.
Привілейовані контейнери не підтримуються у Windows. Натомість у Windows можна використовувати контейнери HostProcess для виконання багатьох завдань, які в Linux виконують привілейовані контейнери.
7 - Контроль доступу до API Kubernetes
На цій сторінці наведено огляд контролю доступу до API Kubernetes.
Користувачі отримують доступ до API Kubernetes за допомогою kubectl, клієнтських бібліотек або запитів REST. Авторизувати доступ до API можна як для людей, так і для ServiceAccount Kubernetes. Коли запит досягає API, він проходить кілька етапів, показаних на цій схемі:
Транспортна безпека
Стандартно API-сервер Kubernetes прослуховує порт 6443 на першому мережевому інтерфейсі, відмінному від localhost, із захистом TLS. У типовому промисловому кластері Kubernetes API працює на порту 443. Порт можна змінити за допомогою прапорця --secure-port, а IP-адресу прослуховування — за допомогою прапорця --bind-address.
API-сервер надає сертифікат. Цей сертифікат може бути підписаний приватним центром сертифікації (CA) або базуватися на інфраструктурі відкритих ключів, повʼязаній із загальновизнаним CA. Сертифікат і відповідний приватний ключ можна задати за допомогою прапорців --tls-cert-file та --tls-private-key-file.
Якщо ваш кластер використовує приватний центр сертифікації, вам потрібна копія сертифіката цього CA, налаштована у вашому ~/.kube/config на клієнті, щоб ви могли довіряти зʼєднанню та бути впевненими, що його не було перехоплено.
На цьому етапі ваш клієнт може надати клієнтський сертифікат TLS.
Автентифікація
Після встановлення TLS HTTP-запит переходить до кроку автентифікації. На схемі це крок 1. Сценарій створення кластера або адміністратор кластера налаштовує API-сервер на використання одного або кількох модулів автентифікації. Автентифікатори докладніше описані в розділі Автентифікація.
Вхідними даними для кроку автентифікації є весь HTTP-запит; однак зазвичай перевіряються заголовки та/або клієнтський сертифікат.
Модулі автентифікації охоплюють клієнтські сертифікати, паролі та прості токени, токени bootstrap і JSON Web Tokens (використовуються для ServiceAccount).
Можна вказати кілька модулів автентифікації; у такому разі кожен із них пробується послідовно, доки один не спрацює успішно.
Якщо запит не може бути автентифікований, його буде відхилено з кодом статусу HTTP 401. В іншому разі користувач автентифікується як конкретний username, і це імʼя користувача доступне наступним крокам для прийняття рішень. Деякі автентифікатори також надають членство користувача в групах, а інші ні.
Хоча Kubernetes використовує імена користувачів для рішень щодо контролю доступу та в логах запитів, він не має обʼєкта User і не зберігає імена користувачів чи іншу інформацію про них у своєму API.
Авторизація
Після того як запит автентифіковано як такий, що надійшов від певного користувача, його потрібно авторизувати. На схемі це крок 2.
Запит має містити імʼя користувача, який його надсилає, запитану дію та обʼєкт, якого стосується дія. Запит авторизується, якщо наявна політика визначає, що користувач має дозвіл на виконання запитаної дії.
Наприклад, якщо у Боба є наведена нижче політика, він може читати Podʼи лише у просторі імен projectCaribou:
Якщо Боб зробить запит на запис (create або update) обʼєктів у просторі імен projectCaribou, йому буде відмовлено в авторизації. Якщо Боб зробить запит на читання (get) обʼєктів в іншому просторі імен, наприклад projectFish, йому також буде відмовлено в авторизації.
Авторизація в Kubernetes потребує використання загальних атрибутів REST для взаємодії з наявними системами контролю доступу на рівні всієї організації або хмарного провайдера. Важливо використовувати форматування REST, оскільки ці системи контролю можуть взаємодіяти з іншими API, крім API Kubernetes.
Kubernetes підтримує кілька модулів авторизації, таких як режим ABAC, режим RBAC та режим Webhook. Коли адміністратор створює кластер, він налаштовує модулі авторизації, які використовуватиме API-сервер. Якщо налаштовано більше одного модуля авторизації, Kubernetes перевіряє кожен модуль, і якщо будь-який модуль авторизує запит, запит може виконуватися. Якщо всі модулі відхиляють запит, його буде відхилено (код статусу HTTP 403).
Докладніше про авторизацію в Kubernetes, зокрема про створення політик за допомогою підтримуваних модулів авторизації, дивіться в розділі Авторизація.
Контроль допуску
Модулі контролю допуску — це програмні модулі, які можуть змінювати або відхиляти запити. Крім атрибутів, доступних модулям авторизації, модулі контролю допуску можуть отримувати доступ до вмісту обʼєкта, який створюється або змінюється.
Контролери допуску обробляють запити на створення, зміну, видалення обʼєкта або підключення до нього (проксі). Контролери допуску не обробляють запити, які лише читають обʼєкти. Коли налаштовано кілька контролерів допуску, вони викликаються по черзі.
На схемі це крок 3.
На відміну від модулів автентифікації та авторизації, якщо будь-який модуль контролю допуску відхиляє запит, то запит негайно відхиляється.
Крім відхилення обʼєктів, контролери допуску також можуть встановлювати складні стандартні значення для полів.
Після того як запит пройде всі контролери допуску, його перевіряють за допомогою процедур валідації відповідного обʼєкта API, а потім записують у сховище обʼєктів (на схемі це крок 4).
Аудит
Аудит Kubernetes забезпечує важливий для безпеки хронологічний набір записів, що документують послідовність дій у кластері. Кластер проводить аудит дій користувачів, застосунків, які використовують API Kubernetes, і самої панелі управління.
те, як Podʼи можуть використовувати Secrets для отримання облікових даних API.
8 - Рекомендації щодо контролю доступу на основі ролей
Принципи та практики для належного проєктування RBAC для операторів кластерів.
RBAC у Kubernetes — ключовий засіб контролю безпеки, який гарантує, що користувачі й робочі навантаження кластера мають доступ лише до ресурсів, потрібних для виконання їхніх ролей. Проєктуючи дозволи для користувачів кластера, адміністратор має розуміти, де може статися підвищення привілеїв, щоб зменшити ризик надмірного доступу, який може призвести до інцидентів безпеки.
Рекомендації, викладені тут, слід читати разом із загальною документацією з RBAC.
Загальні рекомендації
Принцип найменших привілеїв
В ідеалі користувачам і ServiceAccount слід призначати мінімальні права RBAC. Слід використовувати лише дозволи, явно потрібні для їхньої роботи. Хоча кожен кластер відрізняється, ось деякі загальні правила, які можна застосувати:
Надавайте дозволи на рівні простору імен, де це можливо. Використовуйте RoleBindings замість ClusterRoleBindings, щоб дати користувачам права лише в межах конкретного простору імен.
За можливості уникайте надання дозволів із шаблонами (wildcard), особливо для всіх ресурсів. Оскільки Kubernetes є розширюваною системою, доступ із шаблоном надає права не лише на всі типи обʼєктів, які наразі існують у кластері, а й на всі типи обʼєктів, які буде створено в майбутньому.
Адміністратори не повинні використовувати облікові записи cluster-admin, окрім випадків, коли це справді потрібно. Обліковий запис із низькими привілеями та правами імперсонації може запобігти випадковій зміні ресурсів кластера.
Уникайте додавання користувачів до групи system:masters. Будь-який член цієї групи оминає всі перевірки прав RBAC і завжди матиме необмежений доступ суперкористувача, який не можна скасувати видаленням RoleBindings або ClusterRoleBindings. До речі, якщо кластер використовує вебхук авторизації, членство в цій групі також оминає цей вебхук (запити від членів цієї групи ніколи не надсилаються до вебхука).
Мінімізація розповсюдження привілейованих токенів
В ідеалі Podʼам не слід призначати ServiceAccount із потужними дозволами (наприклад, будь-якими з прав, перелічених у розділі ризики підвищення привілеїв). Якщо робочому навантаженню потрібні потужні дозволи, розгляньте такі практики:
Обмежте кількість вузлів, на яких працюють потужні Podʼи. Переконайтеся, що всі DaemonSets, які ви запускаєте, справді потрібні та працюють із найменшими привілеями, щоб обмежити радіус ураження в разі виходу за межі контейнера.
Уникайте запуску потужних Podʼів поруч із ненадійними або публічно доступними. Розгляньте використання Taints and Toleration, NodeAffinity або PodAntiAffinity, щоб Podʼи не працювали поруч із ненадійними або менш надійними Podʼами. Особливу увагу приділіть ситуаціям, коли менш надійні Podʼи не відповідають стандарту безпеки Podʼів Restricted.
Зміцнення безпеки
Стандартно Kubernetes надає доступ, який може бути не потрібен у кожному кластері. Перегляд стандартних прав RBAC може дати можливості для зміцнення безпеки. Загалом не слід змінювати права облікових записів system:, але є деякі варіанти зміцнення прав кластера:
Перегляньте привʼязки групи system:unauthenticated і за можливості видаліть їх, оскільки вони надають доступ будь-кому, хто може звернутися до API-сервера на мережевому рівні.
Уникайте стандартного автоматичного монтування токенів ServiceAccount, встановивши automountServiceAccountToken: false. Докладніше дивіться в розділі використання стандартного токена ServiceAccount. Встановлення цього значення для Podʼа перевизначить налаштування ServiceAccount; робочі навантаження, яким потрібні токени ServiceAccount, усе ще можуть їх монтувати.
Періодичний огляд
Важливо періодично переглядати налаштування RBAC у Kubernetes на наявність зайвих записів і можливих підвищень привілеїв. Якщо зловмисник може створити обліковий запис користувача з такою самою назвою, як у видаленого користувача, він може автоматично успадкувати всі права видаленого користувача, зокрема права, призначені цьому користувачу.
Ризики підвищення привілеїв у RBAC Kubernetes
У RBAC Kubernetes є низка привілеїв, які в разі надання можуть дозволити користувачу або ServiceAccount підвищити свої привілеї в кластері або вплинути на системи поза кластером.
У цьому розділі показано області, де операторам кластерів слід бути уважними, щоб ненавмисно не надати більше доступу до кластерів, ніж передбачалося.
Перелік Secrets
Зазвичай зрозуміло, що доступ get до Secrets дозволяє користувачу читати їхній вміст. Також важливо зазначити, що доступ list і watch фактично теж дозволяє користувачам розкривати вміст Secrets. Наприклад, відповідь на запит List (наприклад, через kubectl get secrets -A -o yaml) містить вміст усіх Secrets.
Створення робочих навантажень
Дозвіл на створення робочих навантажень (Podʼів або ресурсів робочих навантажень, що керують Podʼами) у просторі імен неявно надає доступ до багатьох інших ресурсів у цьому просторі імен, таких як Secrets, ConfigMaps і PersistentVolumes, які можна монтувати в Podʼах. Крім того, оскільки Podʼи можуть працювати від імені будь-якого ServiceAccount, дозвіл на створення робочих навантажень також неявно надає рівні доступу до API будь-якого ServiceAccount у цьому просторі імен.
Користувачі, які можуть запускати привілейовані Podʼи, можуть використати цей доступ, щоб отримати доступ до вузла й, можливо, ще більше підвищити свої привілеї. Якщо ви не повністю довіряєте користувачу чи іншому принципалу створювати належно захищені та ізольовані Podʼи, застосовуйте стандарт безпеки Podʼів Baseline або Restricted. Для цього можна використовувати Pod Security admission або інші (сторонні) механізми.
Тому простори імен слід використовувати для розділення ресурсів, що потребують різних рівнів довіри або орендарів. Дотримуватися принципів найменших привілеїв і призначати мінімальний набір дозволів усе ще вважається рекомендованою практикою, але межі всередині простору імен слід вважати слабкими.
Створення PersistentVolume
Якщо комусь (людині чи застосунку) дозволено створювати довільні PersistentVolumes, цей доступ включає створення томів hostPath, а отже, Pod отримає доступ до файлової системи (або файлових систем) хоста на відповідному вузлі. Надання такої можливості є ризиком для безпеки.
Контейнер із необмеженим доступом до файлової системи хоста може підвищити привілеї багатьма способами, зокрема читаючи дані інших контейнерів і зловживаючи обліковими даними системних сервісів, таких як kubelet.
Дозволяйте створювати обʼєкти PersistentVolume лише:
Користувачам (операторам кластера), яким цей доступ потрібен для роботи і яким ви довіряєте.
Компонентам панелі управління Kubernetes, які створюють PersistentVolumes на основі PersistentVolumeClaims, налаштованих на автоматичне надання. Зазвичай це налаштовує провайдер Kubernetes або оператор під час встановлення драйвера CSI.
Якщо потрібен доступ до постійного сховища, довірені адміністратори мають створювати PersistentVolumes, а обмежені користувачі мають використовувати PersistentVolumeClaims для доступу до цього сховища.
Доступ до субресурсу proxy обʼєктів Node
Користувачі з доступом до субресурсу nodes/proxy мають права на API kubelet, що дозволяє виконувати команди в кожному Podʼі на вузлах, до яких вони мають права. Цей доступ оминає логування аудиту й контроль допуску, тому будьте обережні, надаючи будь-які права на цей ресурс. Ці API можна викликати через HTTP-запити websocket GET, які потребують лише авторизації дієслова get. Це означає, що дозвіл get на nodes/proxy не є дозволом лише для читання. Наприклад, дозвіл get на nodes/proxy надає доступ до привілейованих API kubelet, які можуть отримувати логи контейнерів, виконувати процеси в Podʼах і підключатися до них, навіть якщо викликач не має еквівалентних дозволів через API Kubernetes.
Загалом система RBAC не дозволяє користувачам створювати clusterroles із ширшими правами, ніж мають вони самі. Виняток — дієслово escalate. Як зазначено в документації RBAC, користувачі з цим правом можуть фактично підвищувати свої привілеї.
Дієслово bind
Як і дієслово escalate, це право дозволяє оминати вбудований захист Kubernetes від підвищення привілеїв, завдяки чому користувачі можуть створювати привʼязки до ролей із правами, яких вони ще не мають.
Дієслово impersonate
Це дієслово дозволяє користувачам імперсонувати інших користувачів кластера й отримувати їхні права. Надаючи його, будьте обережні, щоб через імперсоновані облікові записи не можна було отримати надмірні дозволи.
CSR і видача сертифікатів
API CSR дозволяє користувачам із правами create на CSR і update на certificatesigningrequests/approval, де підписувачем є kubernetes.io/kube-apiserver-client, створювати нові клієнтські сертифікати для автентифікації в кластері. Ці клієнтські сертифікати можуть мати довільні назви, зокрема дублювати назви системних компонентів Kubernetes. Це фактично дозволяє підвищити привілеї.
Запити токенів
Користувачі з правами create на serviceaccounts/token можуть створювати TokenRequests, щоб видавати токени для наявних ServiceAccount.
Керування вебхуками допуску
Користувачі, які контролюють validatingwebhookconfigurations або mutatingwebhookconfigurations, можуть керувати вебхуками, які можуть читати будь-який обʼєкт, допущений до кластера, а у випадку змінювальних вебхуків також змінювати допущені обʼєкти.
Зміна Namespace
Користувачі, які можуть виконувати операції patch над обʼєктами Namespace (через RoleBinding у просторі імен до Role з таким доступом), можуть змінювати мітки цього простору імен. У кластерах із Pod Security Admission це може дозволити користувачу налаштувати для простору імен менш сувору політику, ніж передбачили адміністратори. У кластерах із NetworkPolicy користувачі можуть встановити мітки, які опосередковано надають доступ до сервісів, доступ до яких адміністратор не планував дозволяти. У кластерах із динамічним розподілом ресурсів додавання до простору імен мітки resource.kubernetes.io/admin-access: "true" дозволяє будь-якому користувачу, який може створювати ResourceClaims у цьому просторі імен, запитувати адміністративний доступ до пристроїв, уже виділених будь-якій іншій заявці в будь-якому просторі імен.
Ризики відмови в обслуговуванні в RBAC Kubernetes
Відмова в обслуговуванні через створення обʼєктів
Користувачі з правами на створення обʼєктів у кластері можуть створити достатньо великі обʼєкти або достатню їх кількість, щоб спричинити відмову в обслуговуванні, як описано в etcd used by Kubernetes is vulnerable to OOM attack. Це особливо актуально для багатоорендних кластерів, якщо користувачі з частковою довірою або без довіри мають обмежений доступ до системи.
Один зі способів помʼякшити цю проблему — використовувати квоти ресурсів для обмеження кількості обʼєктів, які можна створити.
Принципи та практики належного керування Secrets для адміністраторів кластера та розробників застосунків.
У Kubernetes Secret — це обʼєкт, який зберігає конфіденційну інформацію, таку як паролі, токени OAuth та ключі SSH.
Секрети дають вам більше контролю над тим, як використовується конфіденційна інформація і зменшують ризик випадкового її розголошення. Значення Secret кодуються як рядки base64 і зазвичай зберігаються в незашифрованому вигляді, але можуть бути налаштовані для шифрування в стані покою.
Pod може посилатися на Secret різними способами, такими як монтування тому, чи як змінна середовища. Secretʼи призначені для конфіденційних даних, а ConfigMaps призначені для неконфіденційних даних.
Наведені нижче рекомендації призначені як для адміністраторів кластера, так і для розробників застосунків. Використовуйте їх, щоб підвищити безпеку конфіденційної інформації в обʼєктах Secret і ефективніше керувати своїми Secrets.
Адміністратори кластера
У цьому розділі наведено рекомендації, які адміністратори кластера можуть використовувати для покращення безпеки конфіденційної інформації в кластері.
Налаштування шифрування даних у стані спокою
Стандартно обʼєкти Secret зберігаються в etcd у незашифрованому вигляді. Вам слід налаштувати шифрування даних Secret в etcd. Інструкції дивіться в розділі Шифрування даних Secret у стані спокою.
Налаштування доступу з мінімальними привілеями до Secret
Компоненти: Обмежте доступ watch або list лише для найпривілейованіших системних компонентів. Надавайте доступ get до Secrets, лише якщо цього потребує звичайна робота компонента.
Люди: Обмежте доступ get, watch або list до Secrets. Дозволяйте доступ до etcd лише адміністраторам кластера. Це стосується й доступу лише для читання. Для складнішого контролю доступу, наприклад обмеження доступу до Secrets із певними анотаціями, розгляньте сторонні механізми авторизації.
Увага:
Надання доступу list до Secrets неявно дозволяє субʼєкту отримувати вміст Secrets.
Користувач, який може створити Pod, що використовує Secret, також може побачити значення цього Secret. Навіть якщо політики кластера не дозволяють користувачу читати Secret безпосередньо, той самий користувач може мати доступ до запуску Podʼа, який потім розкриє Secret. Ви можете виявляти або обмежувати вплив навмисного чи ненавмисного розкриття даних Secret користувачем із таким доступом. Ось деякі рекомендації:
Використовуйте Secrets із коротким терміном дії
Реалізуйте правила аудиту, які сповіщають про певні події, такі як одночасне читання кількох Secrets одним користувачем
Обмеження доступу до Secrets
Використовуйте окремі простори імен, щоб ізолювати доступ до змонтованих Secrets.
Покращення політик керування etcd
Розгляньте очищення або знищення постійного сховища, яке використовував etcd, коли воно більше не потрібне.
Якщо є кілька екземплярів etcd, налаштуйте зашифрований звʼязок SSL/TLS між ними, щоб захистити дані Secret під час передавання.
Налаштування доступу до зовнішніх Secrets
Примітка: Цей розділ містить посилання на проєкти сторонніх розробників, які надають функціонал, необхідний для Kubernetes. Автори проєкту Kubernetes не несуть відповідальності за ці проєкти. Проєкти вказано в алфавітному порядку. Щоб додати проєкт до цього списку, ознайомтеся з посібником з контенту перед надсиланням змін. Докладніше.
Ви можете використовувати сторонні сховища Secrets, щоб зберігати конфіденційні дані поза кластером, а потім налаштувати Podʼи на доступ до цієї інформації. Kubernetes Secrets Store CSI Driver — це DaemonSet, який дозволяє kubelet отримувати Secrets із зовнішніх сховищ і монтувати їх як томи в певні Podʼи, яким ви надали доступ до цих даних.
Рекомендації щодо налаштування своп-памʼяті для вузлів Linux дивіться в розділі Керування своп-памʼяттю.
Розробники
У цьому розділі наведено рекомендації для розробників щодо покращення безпеки конфіденційних даних під час створення та розгортання ресурсів Kubernetes.
Обмежте доступ до Secret певними контейнерами
Якщо ви визначаєте кілька контейнерів у Podʼі, і лише одному з них потрібен доступ до Secret, налаштуйте монтування тому або змінні середовища так, щоб інші контейнери не мали доступу до цього Secret.
Захист даних Secret після їх зчитування
Застосунки все ще мають захищати значення конфіденційної інформації після її зчитування зі змінної середовища або тому. Наприклад, ваш застосунок не повинен записувати конфіденційні дані в логи у відкритому вигляді або передавати їх ненадійній стороні.
Уникайте спільного використання маніфестів Secret
Якщо ви налаштовуєте Secret через маніфест, у якому конфіденційні дані закодовані в base64, то поширення цього файлу або його додавання до репозиторію коду означає, що Secret доступний усім, хто може читати маніфест.
Увага:
Кодування у base64 — це не метод шифрування, воно не надає додаткової конфіденційності порівняно зі звичайним текстом.
10 - Багатоорендність
На цій сторінці наведено огляд доступних параметрів конфігурації та рекомендацій щодо багатоорендності кластера.
Спільне використання кластерів зменшує витрати й спрощує адміністрування. Однак воно також створює проблеми, такі як безпека, справедливість і керування шумними сусідами.
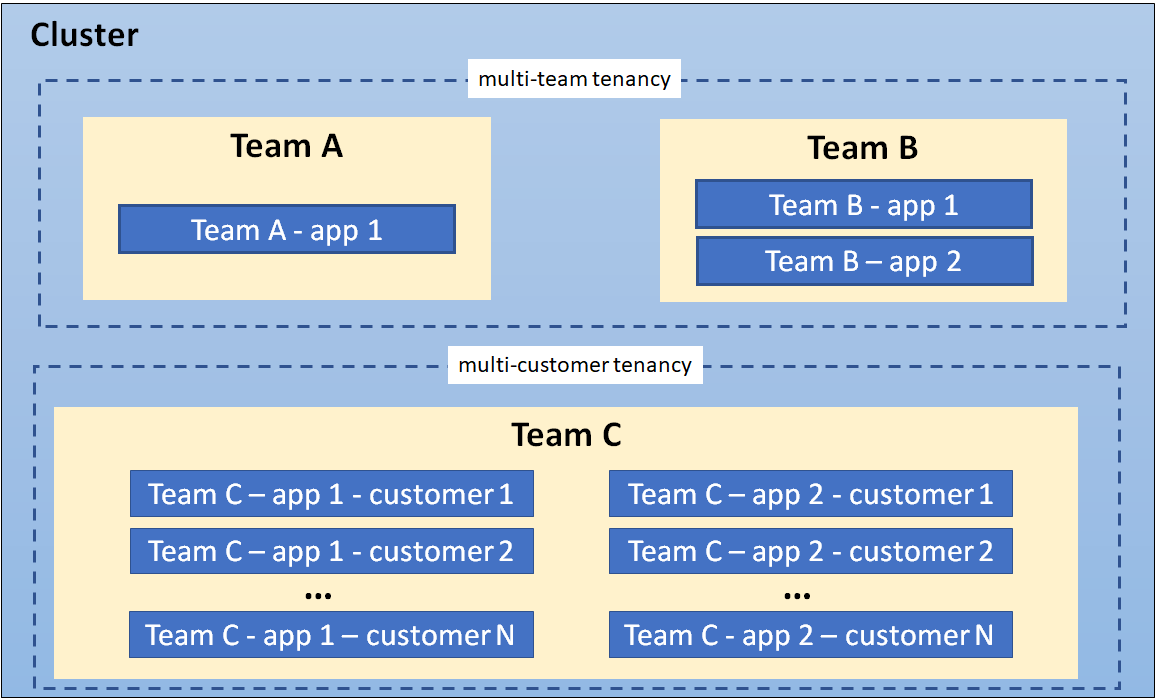
Кластери можна використовувати спільно багатьма способами. У деяких випадках у тому самому кластері можуть працювати різні застосунки. В інших випадках у тому самому кластері може працювати кілька екземплярів одного застосунку, по одному для кожного кінцевого користувача. Усі ці типи спільного використання часто описують загальним терміном багатоорендність (multi-tenancy).
Хоча в Kubernetes немає повноцінних понять кінцевих користувачів або орендарів, він надає кілька можливостей для керування різними вимогами до багатоорендності. Їх описано нижче.
Сценарії використання
Перший крок до визначення способу спільного використання кластера — зрозуміти ваш сценарій використання, щоб оцінити доступні шаблони та інструменти. Загалом багатоорендність у кластерах Kubernetes поділяється на дві широкі категорії, хоча можливо також багато варіантів і гібридів.
Кілька команд
Поширена форма багатоорендності — спільне використання кластера кількома командами в межах організації, кожна з яких може експлуатувати одне або кілька робочих навантажень. Ці робочі навантаження часто мають взаємодіяти між собою та з іншими робочими навантаженнями в тому самому або інших кластерах.
У цьому сценарії учасники команд часто мають прямий доступ до ресурсів Kubernetes через інструменти на кшталт kubectl або опосередкований доступ через контролери GitOps чи інші інструменти автоматизації випусків. Між учасниками різних команд часто є певний рівень довіри, але політики Kubernetes, такі як RBAC, квоти та мережеві політики, необхідні для безпечного й справедливого спільного використання кластерів.
Кілька клієнтів
Інша основна форма багатоорендності часто стосується постачальника програмного забезпечення як сервісу (SaaS), який запускає кілька екземплярів робочого навантаження для клієнтів. Ця бізнес-модель настільки тісно повʼязана з таким способом розгортання, що багато хто називає його «SaaS tenancy». Однак кращим терміном може бути «багатоклієнтська оренда» (multi-customer tenancy), оскільки постачальники SaaS можуть використовувати й інші моделі розгортання, а цю модель розгортання можна використовувати й поза SaaS.
У цьому сценарії клієнти не мають доступу до кластера; з їхнього погляду Kubernetes невидимий, і його використовує лише постачальник для керування робочими навантаженнями. Оптимізація витрат часто є критично важливою, а політики Kubernetes використовуються для надійної ізоляції робочих навантажень одне від одного.
Термінологія
Орендарі
Під час обговорення багатоорендності в Kubernetes немає єдиного визначення «орендаря» (tenant). Воно залежить від того, про яку оренду йдеться: багатокомандну чи багатоклієнтську.
У багатокомандному використанні орендарем зазвичай є команда, і кожна команда зазвичай розгортає невелику кількість робочих навантажень, яка зростає разом зі складністю сервісу. Однак саме визначення «команди» може бути нечітким, оскільки команди можуть обʼєднуватися в підрозділи вищого рівня або ділитися на менші команди.
Натомість якщо кожна команда розгортає окремі робочі навантаження для кожного нового клієнта, вона використовує багатоклієнтську модель оренди. У цьому випадку «орендар» — це просто група користувачів, які спільно використовують одне робоче навантаження. Це може бути ціла компанія або лише одна команда в цій компанії.
У багатьох випадках одна й та сама організація може використовувати обидва визначення «орендарів» у різних контекстах. Наприклад, команда платформи може пропонувати спільні сервіси, такі як інструменти безпеки й бази даних, кільком внутрішнім «клієнтам», а постачальник SaaS може мати кілька команд, які спільно використовують кластер для розробки. Нарешті, можливі й гібридні архітектури, наприклад постачальник SaaS, який поєднує окремі для кожного клієнта робочі навантаження для конфіденційних даних зі спільними багатоорендними сервісами.
Кластер, на якому співіснують різні моделі оренди
Ізоляція
Існує кілька способів проєктування й побудови багатоорендних рішень у Kubernetes. Кожен із цих методів має власний набір компромісів, що впливають на рівень ізоляції, зусилля на реалізацію, операційну складність і вартість обслуговування.
Кластер Kubernetes складається з панелі управління, на якій працює програмне забезпечення Kubernetes, і панелі даних, що складається з робочих вузлів, де робочі навантаження орендарів виконуються як Podʼи. Ізоляцію орендарів можна застосовувати і в панелі управління, і в панелі даних залежно від вимог організації.
Рівень ізоляції іноді описують термінами на кшталт «жорстка» багатоорендність, що передбачає сильну ізоляцію, і «мʼяка» багатоорендність, що передбачає слабшу ізоляцію. Зокрема, «жорстка» багатоорендність часто описує випадки, коли орендарі не довіряють одне одному, переважно з погляду безпеки та спільного використання ресурсів (наприклад, захист від атак на кшталт викрадення даних або DoS). Оскільки панелі даних зазвичай мають значно більшу поверхню атаки, «жорстка» багатоорендність часто потребує додаткової уваги до ізоляції панелі даних, хоча ізоляція панелі управління також залишається критично важливою.
Однак терміни «жорстка» і «мʼяка» часто можуть заплутувати, оскільки немає єдиного визначення, що підходило б усім користувачам. Краще розглядати «жорсткість» чи «мʼякість» як широкий спектр із багатьма різними техніками, які можна використовувати для підтримання різних типів ізоляції у ваших кластерах залежно від ваших вимог.
У більш екстремальних випадках може бути простіше або необхідно повністю відмовитися від спільного використання на рівні кластера й виділити кожному орендарю власний кластер, можливо, навіть на виділеному обладнанні, якщо віртуальні машини не вважаються достатньою межею безпеки. Це може бути простіше з керованими кластерами Kubernetes, де накладні витрати на створення й експлуатацію кластерів принаймні частково бере на себе хмарний провайдер. Перевагу сильнішої ізоляції орендарів слід зважувати проти вартості та складності керування кількома кластерами. За такі сценарії використання відповідає Multi-cluster SIG.
Решта цієї сторінки присвячена технікам ізоляції для спільних кластерів Kubernetes. Однак навіть якщо ви розглядаєте виділені кластери, варто переглянути ці рекомендації, оскільки вони дадуть вам гнучкість для переходу на спільні кластери в майбутньому, якщо ваші потреби чи можливості зміняться.
Ізоляція панелі управління
Ізоляція панелі управління гарантує, що різні орендарі не можуть отримувати доступ до ресурсів API Kubernetes одне одного або впливати на них.
Простори імен
У Kubernetes простір імен надає механізм ізоляції груп ресурсів API в межах одного кластера. Ця ізоляція має два ключові виміри:
Назви обʼєктів у межах простору імен можуть збігатися з назвами в інших просторах імен, подібно до файлів у теках. Це дозволяє орендарям називати свої ресурси, не зважаючи на те, що роблять інші орендарі.
Багато політик безпеки Kubernetes діють у межах просторів імен. Наприклад, RBAC Roles і Network Policies є ресурсами в межах простору імен. За допомогою RBAC користувачів і ServiceAccounts можна обмежити простором імен.
У багатоорендному середовищі простір імен допомагає виділити робоче навантаження орендаря в логічну й окрему одиницю керування. Поширеною практикою є ізоляція кожного робочого навантаження у власному просторі імен, навіть якщо кількома робочими навантаженнями керує той самий орендар. Це гарантує, що кожне робоче навантаження має власну ідентичність і може бути налаштоване з відповідною політикою безпеки.
Модель ізоляції на основі просторів імен потребує налаштування кількох інших ресурсів Kubernetes, мережевих втулків і дотримання рекомендацій з безпеки для належної ізоляції робочих навантажень орендарів. Ці міркування описано нижче.
Контроль доступу
Найважливіший тип ізоляції для панелі управління — авторизація. Якщо команди або їхні робочі навантаження можуть отримувати доступ до ресурсів API одне одного або змінювати їх, вони можуть змінювати або вимикати всі інші типи політик, зводячи нанівець будь-який захист, який ці політики можуть надавати. Тому критично важливо забезпечити, щоб кожен орендар мав відповідний доступ лише до потрібних йому просторів імен і не більше. Це називають «принципом найменших привілеїв».
Контроль доступу на основі ролей (RBAC) зазвичай використовується для забезпечення авторизації в панелі управління Kubernetes як для користувачів, так і для робочих навантажень (ServiceAccounts). Roles і RoleBindings — це обʼєкти Kubernetes, які використовуються на рівні простору імен для забезпечення контролю доступу у вашому застосунку; подібні обʼєкти існують і для авторизації доступу до обʼєктів на рівні кластера, хоча вони менш корисні для багатоорендних кластерів.
У багатокомандному середовищі RBAC слід використовувати, щоб обмежити доступ орендарів відповідними просторами імен і гарантувати, що до ресурсів на рівні кластера можуть отримувати доступ або змінювати їх лише привілейовані користувачі, такі як адміністратори кластера.
Якщо політика зрештою надає користувачеві більше дозволів, ніж йому потрібно, це, ймовірно, сигнал, що простір імен із відповідними ресурсами слід розділити на дрібніші простори імен. Інструменти керування просторами імен можуть спростити керування цими дрібнішими просторами імен, застосовуючи спільні політики RBAC до різних просторів імен і водночас дозволяючи за потреби детальніші політики.
Квоти
Робочі навантаження Kubernetes споживають ресурси вузлів, такі як CPU і памʼять. У багатоорендному середовищі ви можете використовувати квоти ресурсів для керування використанням ресурсів робочими навантаженнями орендарів. У сценарії з кількома командами, де орендарі мають доступ до API Kubernetes, ви можете використовувати квоти ресурсів, щоб обмежити кількість ресурсів API (наприклад, кількість Podʼів або ConfigMaps), які може створити орендар. Обмеження кількості обʼєктів забезпечують справедливість і допомагають уникнути проблем із шумними сусідами, що впливають на інших орендарів, які використовують спільну панель управління.
Квоти ресурсів — це обʼєкти в межах простору імен. Зіставляючи орендарів із просторами імен, адміністратори кластера можуть використовувати квоти, щоб орендар не міг монополізувати ресурси кластера або перевантажити його панель управління. Інструменти керування просторами імен спрощують адміністрування квот. Крім того, хоча квоти Kubernetes застосовуються лише в межах одного простору імен, деякі інструменти керування просторами імен дозволяють групам просторів імен спільно використовувати квоти, що дає адміністраторам значно більше гнучкості за менших зусиль, ніж вбудовані квоти.
Квоти не дають одному орендарю споживати більше виділеної йому частки ресурсів, мінімізуючи таким чином проблему «шумного сусіда», коли один орендар негативно впливає на продуктивність робочих навантажень інших орендарів.
Коли ви застосовуєте квоту до простору імен, Kubernetes вимагає також вказати запити й обмеження ресурсів для кожного контейнера. Обмеження — це верхня межа кількості ресурсів, яку може споживати контейнер. Контейнери, які намагаються спожити більше ресурсів, ніж дозволяють налаштовані обмеження, зазнають тротлінгу або примусово завершуються залежно від типу ресурсу. Якщо запити ресурсів встановлено нижче за обмеження, кожному контейнеру гарантовано запитану кількість, але певний вплив між робочими навантаженнями все ще можливий.
Квоти не можуть захистити від усіх видів спільного використання ресурсів, наприклад мережевого трафіку. Кращим рішенням цієї проблеми може бути ізоляція вузлів (описана нижче).
Ізоляція панелі даних
Ізоляція панелі даних гарантує, що Podʼи та робочі навантаження різних орендарів достатньо ізольовані.
Мережева ізоляція
Стандартно всі Podʼи в кластері Kubernetes можуть взаємодіяти між собою, а весь мережевий трафік не зашифрований. Це може призвести до вразливостей безпеки, коли трафік випадково або зловмисно надсилається не за призначенням або перехоплюється робочим навантаженням на скомпрометованому вузлі.
Взаємодію між Podʼами можна контролювати за допомогою мережевих політик, які обмежують взаємодію між Podʼами за мітками просторів імен або діапазонами IP-адрес. У багатоорендному середовищі, де потрібна сувора мережева ізоляція між орендарями, рекомендується починати зі стандартної політики, яка забороняє взаємодію між Podʼами, та ще одного правила, яке дозволяє всім Podʼам звертатися до сервера DNS для розвʼязання імен. Маючи таку стандартну політику, можна додавати більш дозвільні правила, що дозволяють взаємодію в межах простору імен. Також рекомендується не використовувати порожній селектор міток '{}' для поля namespaceSelector у визначенні мережевої політики, якщо потрібно дозволити трафік між просторами імен. Цю схему можна вдосконалювати за потреби. Зверніть увагу, що це стосується лише Podʼів у межах однієї панелі управління; Podʼи, що належать до різних віртуальних панелей управління, не можуть взаємодіяти між собою через мережу Kubernetes.
Інструменти керування просторами імен можуть спростити створення стандартних або спільних мережевих політик. Крім того, деякі з цих інструментів дозволяють примусово застосовувати узгоджений набір міток просторів імен у всьому кластері, що робить їх надійною основою для ваших політик.
Попередження:
Мережеві політики потребують втулка CNI, який підтримує реалізацію мережевих політик. Інакше ресурси NetworkPolicy ігноруватимуться.
Більш розвинену мережеву ізоляцію можуть забезпечувати service mesh, які надають політики 7-го рівня OSI на основі ідентичності робочих навантажень на додачу до просторів імен. Ці політики вищого рівня можуть полегшити керування багатоорендністю на основі просторів імен, особливо коли кілька просторів імен виділено одному орендарю. Вони часто також пропонують шифрування за допомогою взаємного TLS, захищаючи ваші дані навіть за наявності скомпрометованого вузла, і працюють на виділених або віртуальних кластерах. Однак вони можуть бути значно складнішими в керуванні й можуть підходити не всім користувачам.
Ізоляція сховищ
Kubernetes пропонує кілька типів томів, які можна використовувати як постійне сховище для робочих навантажень. Для безпеки та ізоляції даних рекомендовано динамічне надання томів, а типів томів, що використовують ресурси вузла, слід уникати.
StorageClasses дозволяють описувати власні «класи» сховищ, які пропонує ваш кластер, на основі рівнів якості обслуговування, політик резервного копіювання або власних політик, визначених адміністраторами кластера.
Podʼи можуть запитувати сховище за допомогою PersistentVolumeClaim. PersistentVolumeClaim — це ресурс у межах простору імен, що дозволяє ізолювати частини системи зберігання й виділяти їх орендарям у спільному кластері Kubernetes. Однак важливо зауважити, що PersistentVolume — це ресурс на рівні кластера, життєвий цикл якого не залежить від робочих навантажень і просторів імен.
Наприклад, ви можете налаштувати окремий StorageClass для кожного орендаря й використовувати це для зміцнення ізоляції. Якщо StorageClass спільний, слід встановити політику повторного використання Delete, щоб PersistentVolume не можна було повторно використовувати в різних просторах імен.
Ізоляція контейнерів у пісочниці
Podʼи Kubernetes складаються з одного або кількох контейнерів, що виконуються на робочих вузлах. Контейнери використовують віртуалізацію на рівні ОС і тому надають слабшу межу ізоляції, ніж віртуальні машини, що використовують апаратну віртуалізацію.
У спільному середовищі невиправлені вразливості на рівні застосунків і систем можуть бути використані зловмисниками для виходу за межі контейнера й віддаленого виконання коду, що дає доступ до ресурсів хоста. У деяких застосунках, наприклад у системах керування вмістом (CMS), клієнтам може бути дозволено завантажувати й виконувати недовірені скрипти чи код. У будь-якому разі бажані механізми подальшої ізоляції та захисту робочих навантажень за допомогою сильної ізоляції.
Ізоляція в пісочниці дає змогу ізолювати робочі навантаження, що працюють у спільному кластері. Зазвичай вона передбачає запуск кожного Podʼа в окремому середовищі виконання, такому як віртуальна машина або ядро в просторі користувача. Ізоляцію в пісочниці часто рекомендують, коли ви запускаєте недовірений код, а робочі навантаження вважаються зловмисними. Частково така ізоляція потрібна тому, що контейнери — це процеси, які працюють на спільному ядрі; вони монтують файлові системи, такі як /sys і /proc, з базового хоста, що робить їх менш безпечними, ніж застосунок у віртуальній машині з власним ядром. Хоча такі засоби контролю, як seccomp, AppArmor і SELinux, можна використовувати для зміцнення безпеки контейнерів, важко застосувати універсальний набір правил до всіх робочих навантажень у спільному кластері. Запуск робочих навантажень у пісочниці допомагає захистити хост від виходу з контейнера, коли зловмисник використовує вразливість, щоб отримати доступ до системи хоста й усіх процесів і файлів на цьому хості.
Віртуальні машини та ядра в просторі користувача — два популярні підходи до ізоляції в пісочниці.
Ізоляція вузлів
Ізоляція вузлів — ще одна техніка, яку можна використовувати для ізоляції робочих навантажень орендарів одне від одного. За ізоляції вузлів набір вузлів виділяється для запуску Podʼів певного орендаря, а спільне розміщення Podʼів різних орендарів заборонено. Така конфігурація зменшує проблему шумного орендаря, оскільки всі Podʼи на вузлі належать одному орендарю. Ризик розкриття інформації дещо нижчий за ізоляції вузлів, оскільки зловмисник, якому вдасться вийти за межі контейнера, матиме доступ лише до контейнерів і томів, змонтованих на цьому вузлі.
Хоча робочі навантаження різних орендарів працюють на різних вузлах, важливо памʼятати, що kubelet і (якщо не використовуються віртуальні панелі управління) сервіс API все ще є спільними сервісами. Кваліфікований зловмисник може використати дозволи, призначені kubelet або іншим Podʼам на вузлі, щоб переміщатися кластером і отримати доступ до робочих навантажень орендарів на інших вузлах. Якщо це викликає серйозне занепокоєння, розгляньте компенсаційні засоби контролю, такі як seccomp, AppArmor або SELinux, або використання контейнерів у пісочниці чи створення окремих кластерів для кожного орендаря.
Ізоляцію вузлів дещо простіше обґрунтувати з погляду виставлення рахунків, ніж ізоляцію контейнерів у пісочниці, оскільки витрати можна розподіляти за вузлами, а не за Podʼами. Вона також має менше проблем із сумісністю та продуктивністю й може бути простішою в реалізації, ніж ізоляція контейнерів у пісочниці. Наприклад, вузли кожного орендаря можна налаштувати з taints, щоб на них могли працювати лише Podʼи з відповідною toleration. Потім змінювальний вебхук може автоматично додавати tolerations і спорідненість вузлів до Podʼів, розгорнутих у просторах імен орендарів, щоб вони працювали на певному наборі вузлів, призначених цьому орендарю.
У цьому розділі розглянуто інші конструкції та шаблони Kubernetes, що стосуються багатоорендності.
API Priority and Fairness
API Priority and Fairness — це можливість Kubernetes, яка дозволяє призначати пріоритет певним Podʼам, що працюють у кластері. Коли застосунок викликає API Kubernetes, API-сервер оцінює пріоритет, призначений Podʼу. Виклики від Podʼів із вищим пріоритетом виконуються раніше за виклики з нижчим пріоритетом. За високої конкуренції виклики з нижчим пріоритетом можуть ставитися в чергу, доки сервер не звільниться, або ви можете відхиляти запити.
Використання API Priority and Fairness не дуже поширене в середовищах SaaS, якщо тільки ви не дозволяєте клієнтам запускати застосунки, що взаємодіють з API Kubernetes, наприклад контролер.
Якість обслуговування (QoS)
Коли ви запускаєте застосунок SaaS, вам може знадобитися можливість пропонувати різним орендарям різні рівні якості обслуговування (QoS). Наприклад, у вас може бути безкоштовний сервіс (freemium) з меншими гарантіями продуктивності та меншим набором можливостей і платний рівень сервісу з конкретними гарантіями продуктивності. На щастя, у Kubernetes є кілька конструкцій, які допомагають досягти цього в спільному кластері, зокрема мережевий QoS, класи сховищ, а також пріоритет і витіснення Podʼів. Ідея кожної з них полягає в тому, щоб надавати орендарям ту якість обслуговування, за яку вони заплатили. Почнімо з мережевого QoS.
Зазвичай усі Podʼи на вузлі використовують спільний мережевий інтерфейс. Без мережевого QoS деякі Podʼи можуть споживати непропорційно велику частку доступної пропускної здатності за рахунок інших Podʼів. Втулок bandwidth Kubernetes створює для мережі розширений ресурс, який дозволяє використовувати конструкції ресурсів Kubernetes, тобто запити й обмеження, щоб застосовувати обмеження швидкості до Podʼів за допомогою черг Linux tc. Зверніть увагу, що згідно з документацією про мережеві втулки цей втулок вважається експериментальним, і його слід ретельно перевірити перед використанням у промислових середовищах.
Для QoS сховища вам, імовірно, знадобиться створити різні класи сховищ або профілі з різними характеристиками продуктивності. Кожен профіль сховища можна повʼязати з окремим рівнем обслуговування, оптимізованим для різних робочих навантажень, наприклад щодо IO, резервування чи пропускної здатності. Може знадобитися додаткова логіка, щоб орендар міг повʼязати відповідний профіль сховища зі своїм робочим навантаженням.
Нарешті, є пріоритет і витіснення Podʼів, де ви можете призначати Podʼам значення пріоритету. Під час планування Podʼів планувальник намагатиметься виселити Podʼи з нижчим пріоритетом, коли бракує ресурсів для планування Podʼів із вищим пріоритетом. Якщо у вас є сценарій, де орендарі мають різні рівні обслуговування в спільному кластері, наприклад безкоштовний і платний, ви можете за допомогою цієї можливості надати вищий пріоритет певним рівням.
DNS
Кластери Kubernetes містять сервіс системи доменних імен (DNS), який перетворює імена на IP-адреси для всіх Services і Podʼів. Стандартно сервіс DNS Kubernetes дозволяє пошук у всіх просторах імен кластера.
У багатоорендних середовищах, де орендарі мають доступ до Podʼів та інших ресурсів Kubernetes, або де потрібна сильніша ізоляція, може знадобитися заборонити Podʼам шукати сервіси в інших просторах імен. Ви можете обмежити пошук DNS між просторами імен, налаштувавши правила безпеки для сервісу DNS. Наприклад, CoreDNS (стандартний сервіс DNS для Kubernetes) може використовувати метадані Kubernetes, щоб обмежувати запити Podʼами та Services у межах простору імен. Докладніше дивіться приклад такого налаштування в документації CoreDNS.
Оператори — це контролери Kubernetes, які керують застосунками. Оператори можуть спростити керування кількома екземплярами застосунку, наприклад сервісу баз даних, що робить їх поширеним будівельним блоком у сценарії багатоклієнтської (SaaS) багатоорендності.
Оператори, що використовуються в багатоорендному середовищі, повинні дотримуватися суворішого набору настанов. Зокрема, Оператор повинен:
Підтримувати створення ресурсів у різних просторах імен орендарів, а не лише в просторі імен, де розгорнуто Оператор.
Гарантувати, що Podʼи налаштовані із запитами та обмеженнями ресурсів, щоб забезпечити планування й справедливість.
Підтримувати налаштування Podʼів для технік ізоляції панелі даних, таких як ізоляція вузлів і контейнери в пісочниці.
Реалізації
Існує два основні способи спільного використання кластера Kubernetes для багатоорендності: за допомогою просторів імен (тобто простір імен на орендаря) або віртуалізації панелі управління (тобто віртуальна панель управління на орендаря).
В обох випадках рекомендовано також ізоляцію панелі даних і врахування додаткових міркувань, таких як API Priority and Fairness.
Ізоляція за просторами імен добре підтримується в Kubernetes, майже не потребує ресурсів і надає механізми належної взаємодії орендарів, наприклад дозволяючи взаємодію між сервісами. Однак її може бути складно налаштувати, і вона не застосовується до ресурсів Kubernetes, які не можуть належати простору імен, таких як Custom Resource Definitions, Storage Classes і Webhooks.
Віртуалізація панелі управління дозволяє ізолювати ресурси поза просторами імен ціною дещо більшого використання ресурсів і складнішого спільного використання між орендарями. Це хороший варіант, коли ізоляції за просторами імен недостатньо, але виділені кластери небажані через високу вартість їх підтримки (особливо on-prem) або через вищі накладні витрати й відсутність спільного використання ресурсів. Однак навіть у віртуалізованій панелі управління використання просторів імен, імовірно, теж дасть переваги.
Обидва варіанти докладніше описано в розділах нижче.
Простір імен на орендаря
Як уже згадувалося, варто розглянути ізоляцію кожного робочого навантаження у власному просторі імен, навіть якщо ви використовуєте виділені кластери або віртуалізовані панелі управління. Це гарантує, що кожне робоче навантаження має доступ лише до власних ресурсів, таких як ConfigMaps і Secrets, і дозволяє налаштувати окремі політики безпеки для кожного робочого навантаження. Крім того, рекомендується давати кожному простору імен назву, унікальну в межах усього вашого парку (тобто навіть якщо вони в окремих кластерах), оскільки це дає гнучкість для переходу між виділеними та спільними кластерами в майбутньому або для використання багатокластерних інструментів, таких як service mesh.
З іншого боку, є також переваги в призначенні просторів імен на рівні орендаря, а не лише робочого навантаження, оскільки часто існують політики, що застосовуються до всіх робочих навантажень одного орендаря. Однак це створює власні проблеми. По-перше, це ускладнює або унеможливлює налаштування політик для окремих робочих навантажень, а по-друге, може бути складно визначити єдиний рівень «оренди», якому слід надати простір імен. Наприклад, в організації можуть бути підрозділи, команди та підкоманди — кому з них призначити простір імен?
Один із можливих підходів — організувати простори імен в ієрархії та спільно використовувати між ними певні політики й ресурси. Це може охоплювати керування мітками просторів імен, життєвими циклами просторів імен, делегованим доступом і спільними квотами ресурсів для повʼязаних просторів імен. Ці можливості можуть бути корисними як у багатокомандних, так і в багатоклієнтських сценаріях.
Віртуальна панель управління на орендаря
Ще одна форма ізоляції панелі управління — використання розширень Kubernetes, щоб надати кожному орендарю віртуальну панель управління, яка дозволяє розділити ресурси API на рівні кластера. Разом із цією моделлю можна використовувати техніки ізоляції панелі даних для безпечного керування робочими вузлами різних орендарів.
Модель багатоорендності на основі віртуальної панелі управління розширює багатоорендність на основі просторів імен, надаючи кожному орендарю окремі компоненти панелі управління, а отже, повний контроль над ресурсами на рівні кластера й сервісами надбудов. Робочі вузли спільні для всіх орендарів і керуються кластером Kubernetes, який зазвичай недоступний орендарям. Цей кластер часто називають суперкластером (super-cluster) або іноді хост-кластером (host-cluster). Оскільки панель управління орендаря не повʼязана безпосередньо з базовими обчислювальними ресурсами, її називають віртуальною панеллю управління.
Віртуальна панель управління зазвичай складається з API-сервера Kubernetes, менеджера контролерів і сховища даних etcd. Вона взаємодіє із суперкластером через контролер синхронізації метаданих, який координує зміни між панелями управління орендарів і панеллю управління суперкластера.
Завдяки виділеним панелям управління для кожного орендаря вирішується більшість проблем ізоляції, спричинених використанням одного API-сервера всіма орендарями. Приклади таких проблем: шумні сусіди в панелі управління, неконтрольований радіус ураження від помилкових конфігурацій політик і конфлікти між обʼєктами на рівні кластера, такими як вебхуки та CRD. Отже, модель віртуальної панелі управління особливо підходить для випадків, коли кожному орендарю потрібен доступ до API-сервера Kubernetes і він очікує повної керованості кластера.
Покращена ізоляція досягається ціною запуску й підтримки окремої віртуальної панелі управління для кожного орендаря. Крім того, панелі управління для кожного орендаря не вирішують проблем ізоляції в панелі даних, таких як шумні сусіди на рівні вузла або загрози безпеці. Їх усе ще потрібно вирішувати окремо.
11 - Посібник зі зміцнення безпеки — динамічний розподіл ресурсів
Інформація про зміцнення безпеки авторизації та шаблонів доступу для динамічного розподілу ресурсів (DRA).
Динамічний розподіл ресурсів (DRA) додає потужні можливості планування та керування пристроями. Оскільки компоненти DRA оновлюють статус ResourceClaim, адміністратори кластера мають налаштувати авторизацію цих оновлень за допомогою явного RBAC з мінімальними привілеями.
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.36; (стандартно увімкнено)
Починаючи з Kubernetes v1.36, оновлення статусу DRA використовують синтетичні субресурси та, в деяких випадках, спеціалізовані дієслова з урахуванням вузла.
Зміцнення дозволів на оновлення статусу DRA
Для оновлень статусу DRA, окрім надання дозволів update на субресурс resourceclaims/status, адміністратори кластера мають надавати дозволи на конкретні «синтетичні» субресурси залежно від того, які саме поля потрібно змінювати компоненту. Це застосовує принцип мінімальних привілеїв до планувальника, власних контролерів і драйверів DRA.
Перевірки авторизації DRA поділяються на два синтетичні субресурси:
resourceclaims/binding
Потрібно для зміни status.allocation та status.reservedFor.
Зазвичай надається kube-scheduler та власним контролерам розподілу.
Використовує стандартні дієслова update та patch.
resourceclaims/driver
Потрібно для зміни status.devices.
Перевірка виконується для кожного драйвера, щоб запобігти втручанню драйверів у пристрої на різних вузлах та/або від інших драйверів.
Використовує дієслова з урахуванням вузла для суворішої області дії.
Дієслова DRA з урахуванням вузла
Під час авторизації оновлень resourceclaims/driver використовуйте відповідний спеціалізований префікс дієслова:
associated-node:<verb> (наприклад, associated-node:update)
Для драйверів, локальних для вузла.
API-сервер перевіряє звʼязок драйвера, що надсилає запит, із вузлом.
arbitrary-node:<verb> (наприклад, arbitrary-node:patch)
Для контролерів панелі управління або багатовузлових контролерів, які можуть оновлювати заявки з будь-якого вузла.
12 - Посібник зі зміцнення безпеки — механізми автентифікації
Інформація про варіанти автентифікації в Kubernetes та їх властивості безпеки.
Вибір відповідних механізмів автентифікації — ключовий аспект захисту вашого кластера. Kubernetes надає кілька вбудованих механізмів, кожен із власними перевагами та недоліками, які слід ретельно враховувати під час вибору найкращого механізму автентифікації для вашого кластера.
Загалом рекомендується вмикати якомога менше механізмів автентифікації, щоб спростити керування користувачами й уникнути ситуацій, коли користувачі зберігають доступ до кластера, який їм більше не потрібен.
Важливо зазначити, що Kubernetes не має вбудованої бази даних користувачів у кластері. Натомість він отримує інформацію про користувачів із налаштованої системи автентифікації й використовує її для прийняття рішень щодо авторизації. Тому для аудиту доступу користувачів потрібно переглядати облікові дані з кожного налаштованого джерела автентифікації.
Для промислових кластерів із багатьма користувачами, які безпосередньо звертаються до API Kubernetes, рекомендується використовувати зовнішні джерела автентифікації, такі як OIDC. Внутрішні механізми автентифікації, такі як клієнтські сертифікати та токени ServiceAccount, описані нижче, не підходять для цього сценарію.
Автентифікація за клієнтським сертифікатом X.509
Kubernetes використовує автентифікацію за клієнтським сертифікатом X.509 для системних компонентів, наприклад коли kubelet автентифікується на API-сервері. Хоча цей механізм можна використовувати й для автентифікації користувачів, він може не підходити для промислового використання через кілька обмежень:
Клієнтські сертифікати не можна відкликати окремо. Скомпрометований сертифікат зловмисник може використовувати до завершення його строку дії. Щоб зменшити цей ризик, рекомендується налаштовувати короткий строк дії для облікових даних користувачів, створених за допомогою клієнтських сертифікатів.
Якщо сертифікат потрібно анулювати, необхідно змінити ключі центру сертифікації, що може створити ризики для доступності кластера.
У кластері немає постійного запису про створені клієнтські сертифікати. Тому, якщо вам потрібно їх відстежувати, усі видані сертифікати слід записувати.
Приватні ключі для автентифікації за клієнтським сертифікатом не можна захистити паролем. Будь-хто, хто може прочитати файл із ключем, зможе ним скористатися.
Автентифікація за клієнтським сертифікатом потребує прямого зʼєднання клієнта з API-сервером без проміжних точок завершення TLS, що може ускладнити архітектуру мережі.
Дані про групи вбудовані в значення O клієнтського сертифіката, тому членство користувача в групах не можна змінити протягом строку дії сертифіката.
Файл статичних токенів
Хоча Kubernetes дозволяє завантажувати облікові дані з файлу статичних токенів, розташованого на дисках вузлів панелі управління, цей підхід не рекомендується для промислових серверів з кількох причин:
Облікові дані зберігаються у відкритому вигляді на дисках вузлів панелі управління, що може бути ризиком для безпеки.
Зміна будь-яких облікових даних потребує перезапуску процесу API-сервера для набуття чинності, що може вплинути на доступність.
Немає механізму, який дозволяв би користувачам ротувати свої облікові дані. Щоб ротувати облікові дані, адміністратор кластера має змінити токен на диску та передати його користувачам.
Немає механізму блокування для запобігання атакам підбору (brute force).
Токени bootstrap
Токени bootstrap використовуються для приєднання вузлів до кластерів і не рекомендуються для автентифікації користувачів з кількох причин:
Вони мають жорстко задане членство в групах, непридатне для загального використання, тому не підходять для автентифікації.
Створення токенів bootstrap вручну може призвести до появи слабких токенів, які може вгадати зловмисник, що є ризиком для безпеки.
Немає механізму блокування для запобігання атакам підбору, тому зловмисникам легше вгадати або зламати токен.
Токени ServiceAccount у Secret
Secrets для ServiceAccount доступні як варіант для автентифікації робочих навантажень кластера на API-сервері. У Kubernetes < 1.23 це був стандартний варіант, однак їх замінюють токени TokenRequest API. Хоча ці Secrets можна використовувати для автентифікації користувачів, зазвичай вони не підходять із кількох причин:
Для них не можна задати строк дії, і вони залишаються чинними, доки відповідний ServiceAccount не буде видалено.
Токени автентифікації видимі будь-якому користувачу кластера, який може читати Secrets у просторі імен, де їх визначено.
ServiceAccount не можна додавати до довільних груп, що ускладнює керування RBAC там, де вони використовуються.
Токени TokenRequest API
TokenRequest API — корисний інструмент для створення короткострокових облікових даних для автентифікації сервісів на API-сервері або в сторонніх системах. Однак загалом його не рекомендується використовувати для автентифікації користувачів, оскільки немає способу відкликання, а безпечно передавати облікові дані користувачам може бути складно.
Під час використання токенів TokenRequest для автентифікації сервісів рекомендується задавати короткий строк дії, щоб зменшити наслідки компрометації токенів.
Автентифікація токенами OpenID Connect
Kubernetes підтримує інтеграцію зовнішніх сервісів автентифікації з API Kubernetes за допомогою OpenID Connect (OIDC). Існує багато програмного забезпечення для інтеграції Kubernetes із постачальником ідентифікації. Однак під час використання автентифікації OIDC у Kubernetes важливо врахувати такі заходи зі зміцнення безпеки:
Програмне забезпечення, встановлене в кластері для підтримки автентифікації OIDC, має бути ізольоване від звичайних робочих навантажень, оскільки воно працюватиме з високими привілеями.
Деякі керовані сервіси Kubernetes обмежують перелік постачальників OIDC, які можна використовувати.
Як і токени TokenRequest, токени OIDC повинні мати короткий строк дії, щоб зменшити наслідки компрометації токенів.
Автентифікація за токеном через вебхук
Автентифікація за токеном через вебхук — ще один варіант інтеграції зовнішніх постачальників автентифікації в Kubernetes. Цей механізм дозволяє звертатися через вебхук до сервісу автентифікації, що працює в кластері або поза ним, для прийняття рішення щодо автентифікації. Важливо зазначити, що придатність цього механізму, ймовірно, залежатиме від програмного забезпечення сервісу автентифікації, і є певні особливості Kubernetes, які варто врахувати.
Для налаштування автентифікації через вебхук потрібен доступ до файлових систем серверів панелі управління. Це означає, що в керованому Kubernetes це неможливо, якщо постачальник спеціально не надасть таку можливість. Крім того, будь-яке програмне забезпечення, встановлене в кластері для підтримки цього доступу, має бути ізольоване від звичайних робочих навантажень, оскільки воно працюватиме з високими привілеями.
Проксі автентифікації
Ще один варіант інтеграції зовнішніх систем автентифікації в Kubernetes — проксі автентифікації. За цього механізму Kubernetes очікує отримувати від проксі запити з певними значеннями заголовків, які вказують імʼя користувача та членство в групах для авторизації. Важливо зазначити, що під час використання цього механізму слід врахувати певні особливості.
По-перше, між проксі та API-сервером Kubernetes слід використовувати безпечно налаштований TLS, щоб зменшити ризик перехоплення трафіку або атак зі сніфінгом. Це гарантує безпеку звʼязку між проксі та API-сервером Kubernetes.
По-друге, важливо памʼятати, що зловмисник, який може змінювати заголовки запиту, може отримати неавторизований доступ до ресурсів Kubernetes. Тому важливо забезпечити належний захист заголовків, щоб їх не можна було підробити.
У цьому документі описано, як покращити захищеність планувальника.
Неправильно налаштований планувальник може мати наслідки для безпеки. Такий планувальник може націлюватися на певні вузли й виселяти робочі навантаження чи застосунки, які спільно використовують вузол і його ресурси. Це може допомогти зловмиснику провести атаку Yo-Yo — атаку на вразливий автомасштабувальник.
Конфігурація kube-scheduler
Параметри командного рядка автентифікації та авторизації планувальника
Під час налаштування автентифікації слід переконатися, що автентифікація kube-scheduler залишається узгодженою з автентифікацією kube-api-server. Якщо в запиті немає заголовків автентифікації, автентифікація має відбуватися через kube-api-server, що забезпечує узгодженість автентифікації в кластері.
authentication-kubeconfig: Переконайтеся, що ви надали правильний kubeconfig, щоб планувальник міг отримувати параметри конфігурації автентифікації з API-сервера. Цей файл kubeconfig має бути захищено суворими правами доступу до файлів.
authentication-tolerate-lookup-failure: Встановіть значення false, щоб планувальник завжди отримував свою конфігурацію автентифікації з API-сервера.
authentication-skip-lookup: Встановіть значення false, щоб планувальник завжди отримував свою конфігурацію автентифікації з API-сервера.
authorization-always-allow-paths: Ці шляхи повинні відповідати даними, придатними для анонімної авторизації. Стандартно /healthz,/readyz,/livez.
profiling: Встановіть значення false, щоб вимкнути точки доступу профілювання, які надають налагоджувальну інформацію, але не повинні бути ввімкнені в промислових кластерах, оскільки становлять ризик відмови в обслуговуванні або витоку інформації. Аргумент --profiling застарів, і тепер його можна задати через KubeScheduler DebuggingConfiguration. Профілювання можна вимкнути в конфігурації kube-scheduler, встановивши enableProfiling у false.
requestheader-client-ca-file: Не передавайте цей аргумент.
Параметри командного рядка для мережевих налаштувань планувальника
bind-address: У більшості випадків kube-scheduler не потребує зовнішнього доступу. Встановлення адреси привʼязки на localhost є безпечною практикою.
permit-address-sharing: Встановіть значення false, щоб вимкнути спільне використання зʼєднань через SO_REUSEADDR. SO_REUSEADDR може призвести до повторного використання завершених зʼєднань, які перебувають у стані TIME_WAIT.
permit-port-sharing: Стандартно: false. Використовуйте стандартне значення, якщо ви не впевнені, що розумієте наслідки для безпеки.
Параметри командного рядка планувальника для TLS
tls-cipher-suites: Завжди надавайте список бажаних наборів шифрів. Це гарантує, що шифрування ніколи не відбуватиметься за допомогою ненадійних наборів шифрів.
Конфігурації планування для власних планувальників
Під час використання власних планувальників, заснованих на коді планування Kubernetes, адміністратори кластерів мають бути обережними із втулками, які використовують точки розширенняqueueSort, prefilter, filter або permit. Ці точки розширення керують різними етапами процесу планування, і неправильна конфігурація може вплинути на поведінку kube-scheduler у вашому кластері.
Основні міркування
Одночасно може бути увімкнено лише один втулок, який використовує точку розширення queueSort. Усі втулки, які використовують queueSort, слід ретельно перевіряти.
Втулки, які реалізують точку розширення prefilter або filter, потенційно можуть позначити всі вузли як непридатні для планування. Це може зупинити планування нових Podʼів.
Втулки, які реалізують точку розширення permit, можуть перешкоджати привʼязці Podʼа або затримувати її. Такі втулки мають бути ретельно перевірені адміністратором кластера.
Якщо ви використовуєте втулок, який не належить до стандартних, розгляньте можливість вимкнення точок розширення queueSort, filter і permit так:
apiVersion:kubescheduler.config.k8s.io/v1kind:KubeSchedulerConfigurationprofiles:- schedulerName:my-schedulerplugins:# Вимкніть певні втулки для різних точок розширення# Ви можете вимкнути всі втулки для точки розширення за допомогою "*"queueSort:disabled:- name:"*"# Вимкнути всі втулки queueSort# - name: "PrioritySort" # Вимкнути певний втулок queueSortfilter:disabled:- name:"*"# Вимкнути всі втулки фільтрів# - name: "NodeResourcesFit" # Вимкнути певний втулок фільтруванняpermit:disabled:- name:"*"# Вимкнути всі втулки дозволів# - name: "TaintToleration" # Вимкнути певний втулок
Це створить профіль планувальника my-scheduler. Щоразу, коли в .spec Podʼа немає значення .spec.schedulerName, для цього Podʼа працює kube-scheduler зі своєю основною конфігурацією та стандартними втулками. Якщо ви визначите Pod із .spec.schedulerName, встановленим у my-scheduler, kube-scheduler запуститься, але з власною конфігурацією; у цій конфігурації точки розширення queueSort, filter і permit вимкнено. Якщо ви використовуєте цю KubeSchedulerConfiguration, не запускаєте жодного власного планувальника, а потім визначите Pod із .spec.schedulerName, встановленим у nonexistent-scheduler (або будь-яку іншу назву планувальника, якого немає у вашому кластері), для Podʼа не буде згенеровано жодних подій.
Заборона додавання міток вузлам
Адміністратор кластера має подбати про те, щоб користувачі кластера не могли додавати мітки вузлам. Зловмисник може використати nodeSelector, щоб запланувати робочі навантаження на вузли, де їх не повинно бути.
14 - Ризики обходу API-сервера Kubernetes
Інформація про архітектуру безпеки, що стосується API-сервера та інших компонентів
API-сервер Kubernetes — головна точка входу до кластера для зовнішніх сторін (користувачів і сервісів), що з ним взаємодіють.
У межах цієї ролі API-сервер має кілька ключових вбудованих засобів контролю безпеки, таких як логування аудиту та контролери допуску. Однак існують способи змінити конфігурацію або вміст кластера, оминаючи ці засоби контролю.
На цій сторінці описано способи обходу вбудованих в API-сервер Kubernetes засобів контролю безпеки, щоб оператори кластера й архітектори безпеки могли переконатися, що ці обхідні шляхи належно обмежені.
Статичні Podʼи
kubelet на кожному вузлі завантажує та безпосередньо керує всіма маніфестами, що зберігаються в зазначеній теці або завантажуються з конкретної URL-адреси як статичні Podʼи у вашому кластері. API-сервер не керує цими статичними Podʼами. Зловмисник із правами запису в це місце може змінити конфігурацію статичних Podʼів, завантажених із цього джерела, або додати нові статичні Podʼи.
Статичним Podʼам заборонено доступ до інших обʼєктів API Kubernetes. Наприклад, не можна налаштувати статичний Pod на монтування Secret із кластера. Однак ці Podʼи можуть виконувати інші чутливі з погляду безпеки дії, наприклад використовувати монтування hostPath з базового вузла.
Стандартно kubelet створює дзеркальний Pod, щоб статичні Podʼи були видимими в API Kubernetes. Однак якщо під час створення Podʼа зловмисник вкаже недійсну назву простору імен, Pod не буде видимий в API Kubernetes, і його зможуть виявити лише інструменти з доступом до уражених хостів.
Якщо статичний Pod не проходить контроль допуску, kubelet не зареєструє Pod на API-сервері. Однак Pod все одно працює на вузлі. Докладніше дивіться в issue kubeadm #1541.
Якщо вузол використовує статичні Podʼи, обмежте доступ до файлової системи з текою маніфестів статичних Podʼів або до URL лише користувачами, яким він потрібен.
Обмежте доступ до параметрів і файлів конфігурації kubelet, щоб зловмисник не міг задати шлях або URL статичних Podʼів.
Регулярно проводьте аудит усіх звернень до тек або вебсховищ із маніфестами статичних Podʼів і файлами конфігурації kubelet та централізовано звітуйте про них.
API kubelet
kubelet надає HTTP API, який зазвичай доступний через TCP-порт 10250 на робочих вузлах кластера. API також може бути доступний на вузлах панелі управління залежно від дистрибутива Kubernetes. Прямий доступ до API дозволяє розкривати інформацію про Podʼи, що працюють на вузлі, отримувати логи цих Podʼів і виконувати команди в кожному контейнері на вузлі.
Деякі з цих точок доступу підтримують протоколи Websocket через HTTP-запити GET, які авторизуються за допомогою дієслова get. Це означає, що дозвіл get на nodes/proxy не є дозволом лише для читання й авторизує доступ до точок доступу, які можна використовувати для виконання команд у будь-якому контейнері на вузлі.
Коли у користувачів кластера Kubernetes є доступ RBAC до субресурсів обʼєкта Node, цей доступ слугує авторизацією для взаємодії з API kubelet. Точний доступ залежить від того, доступ до якого субресурсу надано, як детально описано в розділі авторизація kubelet.
Прямий доступ до API kubelet не підлягає контролю допуску й не реєструється логуванням аудиту Kubernetes. Зловмисник із прямим доступом до цього API може обійти засоби контролю, які виявляють певні дії або запобігають їм.
API kubelet можна налаштувати на автентифікацію запитів кількома способами. Стандартно конфігурація kubelet дозволяє анонімний доступ. Більшість провайдерів Kubernetes змінюють стандартну конфігурацію на автентифікацію через вебхук і сертифікати. Це дозволяє панелі управління переконатися, що викликач має право доступу до ресурсу API nodes або його субресурсів. Стандартний анонімний доступ не дає панелі управління такого підтвердження.
Зменшення ризиків
Обмежте доступ до субресурсів обʼєкта API nodes за допомогою механізмів, таких як RBAC. Надавайте цей доступ лише за потреби, наприклад сервісам моніторингу.
Уникайте надання загального дозволу nodes/proxy, навіть лише з дієсловом get. Натомість надавайте детальні дозволи.
Обмежте доступ до порту kubelet. Дозволяйте доступ до порту лише зазначеним та довіреним діапазонам IP-адрес.
Переконайтеся, що для автентифікації kubelet встановлено режим webhook або сертифікатів.
Переконайтеся, що неавтентифікований порт kubelet лише для читання не ввімкнено в кластері.
API etcd
Кластери Kubernetes використовують etcd як сховище даних. Сервіс etcd прослуховує TCP-порт 2379. Доступ потрібен лише API-серверу Kubernetes та інструментам резервного копіювання, які ви використовуєте. Прямий доступ до цього API дозволяє розкривати або змінювати будь-які дані, що зберігаються в кластері.
Доступом до API etcd зазвичай керує автентифікація за клієнтськими сертифікатами. Будь-який сертифікат, виданий центром сертифікації, якому довіряє etcd, надає повний доступ до даних в etcd.
Прямий доступ до etcd не підлягає контролю допуску Kubernetes і не реєструється логуванням аудиту Kubernetes. Зловмисник, який має доступ на читання до приватного ключа клієнтського сертифіката etcd API-сервера (або може створити новий довірений клієнтський сертифікат), може отримати права адміністратора кластера, отримавши доступ до Secrets кластера або змінивши правила доступу. Навіть без підвищення привілеїв RBAC у Kubernetes зловмисник, який може змінювати etcd, може отримати будь-який обʼєкт API або створити нові робочі навантаження в кластері.
Багато провайдерів Kubernetes налаштовують etcd на використання взаємного TLS (клієнт і сервер перевіряють сертифікати один одного для автентифікації). Загальноприйнятої реалізації авторизації для API etcd немає, хоча така можливість існує. Оскільки моделі авторизації немає, будь-який сертифікат із клієнтським доступом до etcd можна використати для повного доступу до etcd. Зазвичай клієнтські сертифікати etcd, які використовуються лише для перевірки справності, також можуть надавати повний доступ на читання та запис.
Зменшення ризиків
Переконайтеся, що центр сертифікації, якому довіряє etcd, використовується лише для автентифікації в цьому сервісі.
Контролюйте доступ до приватного ключа сертифіката сервера etcd, а також до клієнтського сертифіката й ключа API-сервера.
Розгляньте обмеження доступу до порту etcd на рівні мережі, щоб дозволити доступ лише із зазначених і довірених діапазонів IP-адрес.
Сокет середовища виконання контейнерів
На кожному вузлі кластера Kubernetes доступ до взаємодії з контейнерами контролює середовище виконання контейнерів (або середовища, якщо ви налаштували більше одного). Зазвичай середовище виконання контейнерів надає сокет Unix, до якого має доступ kubelet. Зловмисник із доступом до цього сокета може запускати нові контейнери або взаємодіяти із запущеними контейнерами.
На рівні кластера вплив такого доступу залежить від того, чи мають контейнери на скомпрометованому вузлі доступ до Secrets або інших конфіденційних даних, які зловмисник може використати для підвищення привілеїв на інших робочих вузлах чи в компонентах панелі управління.
Зменшення ризиків
Суворо контролюйте доступ до сокетів середовища виконання контейнерів у файловій системі. За можливості обмежте цей доступ користувачем root.
Ізолюйте kubelet від інших компонентів, що працюють на вузлі, використовуючи механізми, такі як простори імен ядра Linux.
Обмежте або заборонте використання монтувань hostPath, що охоплюють сокет середовища виконання контейнерів безпосередньо або через монтування батьківської теки. Крім того, монтування hostPath слід налаштовувати лише для читання, щоб зменшити ризик обходу обмежень тек зловмисниками.
Обмежте доступ користувачів до вузлів, особливо обмежте доступ суперкористувача до вузлів.
15 - Обмеження безпеки ядра Linux для Podʼів та контейнерів
Огляд модулів безпеки ядра Linux та обмежень, які можна використовувати для зміцнення ваших Podʼів і контейнерів.
На цій сторінці описано деякі можливості безпеки, вбудовані в ядро Linux, які ви можете використовувати у своїх робочих навантаженнях Kubernetes. Щоб дізнатися, як застосувати ці можливості до ваших Podʼів і контейнерів, дивіться Налаштування контексту безпеки для Podʼа або контейнера. Ви вже маєте бути знайомі з Linux та основами робочих навантажень Kubernetes.
Запуск робочих навантажень без привілеїв root
Коли ви розгортаєте робоче навантаження в Kubernetes, використовуйте специфікацію Podʼа, щоб заборонити йому працювати від імені користувача root на вузлі. За допомогою securityContext Podʼа можна визначити конкретного користувача та групу Linux для процесів у Podʼі та явно заборонити контейнерам працювати від імені root. Значення, встановлені в маніфесті Podʼа, мають вищий пріоритет за аналогічні значення в образі контейнера, що особливо корисно, якщо ви запускаєте образи, які вам не належать.
Увага:
Переконайтеся, що користувач або група, яку ви призначаєте робочому навантаженню, має дозволи, потрібні для правильної роботи застосунку. Зміна користувача або групи на таких, що не мають потрібних дозволів, може призвести до проблем із доступом до файлів або збоїв операцій.
Налаштування описаних на цій сторінці можливостей безпеки ядра забезпечує детальний контроль над діями процесів у вашому кластері, але керування цими налаштуваннями може бути складним у великому масштабі. Запуск контейнерів не від імені root або в просторах імен користувачів, якщо вам потрібні привілеї root, зменшує ймовірність того, що вам доведеться застосовувати налаштовані можливості безпеки ядра.
Можливості безпеки в ядрі Linux
Kubernetes дозволяє налаштовувати та використовувати можливості ядра Linux для кращої ізоляції та зміцнення ваших контейнеризованих робочих навантажень. Серед поширених можливостей:
Режим безпечних обчислень (seccomp): фільтрування системних викликів, які може робити процес
AppArmor: обмеження привілеїв доступу окремих програм
Security Enhanced Linux (SELinux): призначення міток безпеки обʼєктам для зручнішого застосування політик безпеки
Щоб налаштувати одну з цих можливостей, операційна система ваших вузлів має вмикати її в ядрі. Наприклад, Ubuntu 7.10 і новіші стандартно вмикають AppArmor. Щоб дізнатися, чи ввімкнено певну можливість у вашій ОС, зверніться до документації ОС.
Поле securityContext у специфікації Podʼа визначає обмеження, що застосовуються до цих процесів. Воно також підтримує інші налаштування безпеки, такі як конкретні capabilities Linux або дозволи на доступ до файлів за допомогою UID і GID. Докладніше дивіться в розділі Налаштування контексту безпеки для Podʼа або контейнера.
seccomp
Деяким вашим робочим навантаженням можуть бути потрібні привілеї для виконання певних дій від імені користувача root на хост-машині вузла. Linux використовує capabilities, щоб розділити доступні привілеї на категорії, тож процеси можуть отримувати привілеї, потрібні для певних дій, без надання всіх привілеїв. Кожна capability має набір системних викликів (syscalls), які може робити процес. seccomp дозволяє обмежувати ці окремі syscalls. Його можна використовувати, щоб ізолювати привілеї процесу в пісочниці, обмежуючи виклики, які він може робити з простору користувача до ядра.
У Kubernetes для запуску контейнерів на кожному вузлі використовується середовище виконання контейнерів. Приклади середовищ — CRI-O, Docker або containerd. Кожне середовище стандартно дозволяє лише підмножину capabilities Linux. Ви можете додатково обмежити дозволені syscalls окремо за допомогою профілю seccomp. Середовища виконання контейнерів зазвичай містять стандартний профіль seccomp. Kubernetes дозволяє автоматично застосовувати до ваших Podʼів і контейнерів профілі seccomp, завантажені на вузол.
Примітка:
У Kubernetes також є налаштування allowPrivilegeEscalation для Podʼів і контейнерів. Якщо встановити його в false, процеси не зможуть отримувати нові capabilities, а непривілейовані користувачі не зможуть змінити застосований профіль seccomp на менш суворий.
Докладніше про seccomp дивіться в розділі Seccomp BPF документації ядра Linux.
Міркування щодо seccomp
seccomp — це низькорівнева конфігурація безпеки, яку варто налаштовувати самостійно лише тоді, коли потрібен детальний контроль над системними викликами Linux. Використання seccomp, особливо у великому масштабі, має такі ризики:
Конфігурації можуть ламатися під час оновлень застосунків
Зловмисники все ще можуть використовувати дозволені syscalls для експлуатації вразливостей
Керування профілями окремих застосунків стає складним у великому масштабі
Рекомендація: Використовуйте стандартний профіль seccomp, що постачається з вашим середовищем виконання контейнерів. Якщо потрібне більш ізольоване середовище, розгляньте пісочницю, таку як gVisor. Пісочниці усувають наведені вище ризики власних профілів seccomp, але потребують більше обчислювальних ресурсів на вузлах і можуть мати проблеми сумісності з GPU та іншим спеціалізованим обладнанням.
AppArmor та SELinux: обовʼязковий контроль доступу на основі політик
Для зміцнення робочих навантажень Kubernetes можна використовувати механізми обовʼязкового контролю доступу (MAC) Linux на основі політик, такі як AppArmor і SELinux.
AppArmor
AppArmor — це модуль безпеки ядра Linux, який доповнює стандартні дозволи Linux на основі користувачів і груп, обмежуючи програми певним набором ресурсів. AppArmor можна налаштувати для будь-якого застосунку, щоб зменшити його потенційну поверхню атаки й забезпечити багаторівневий захист. Він налаштовується через профілі, що дозволяють доступ, потрібний конкретній програмі чи контейнеру, зокрема capabilities Linux, мережевий доступ і дозволи на файли. Кожен профіль може працювати в режимі примусового застосування (enforcing), який блокує доступ до заборонених ресурсів, або в режимі скарг (complain), який лише повідомляє про порушення.
AppArmor може допомогти зробити розгортання безпечнішим, обмежуючи дії контейнерів, та/або покращити аудит через системні логи. Середовище виконання контейнерів може постачатися зі стандартним профілем AppArmor, або ви можете використовувати власний профіль.
SELinux — це модуль безпеки ядра Linux, який дозволяє обмежувати доступ певного субʼєкта, такого як процес, до файлів у вашій системі. Ви визначаєте політики безпеки, які застосовуються до субʼєктів із певними мітками SELinux. Коли процес із міткою SELinux намагається отримати доступ до файлу, сервер SELinux перевіряє, чи дозволяє політика безпеки цього процесу такий доступ, і приймає рішення про авторизацію.
У Kubernetes ви можете встановити мітку SELinux у полі securityContext вашого маніфесту. Вказані мітки призначаються цим процесам. Якщо ви налаштували політики безпеки, що стосуються цих міток, ядро ОС хоста застосовує ці політики.
Операційна система на ваших вузлах Linux зазвичай містить або AppArmor, або SELinux. Обидва механізми забезпечують схожий захист, але мають такі відмінності:
Налаштування: AppArmor використовує профілі для визначення доступу до ресурсів. SELinux використовує політики, які застосовуються до певних міток.
Застосування політики: В AppArmor ви визначаєте ресурси за допомогою шляхів до файлів. SELinux ідентифікує ресурс за його індексним дескриптором (inode).
Підсумок можливостей
У наведеній нижче таблиці описано сценарії використання та область дії кожного засобу контролю безпеки. Ви можете використовувати всі ці засоби разом, щоб створити більш захищену систему.
Підсумок можливостей безпеки ядра Linux
Можливість безпеки
Опис
Як використовувати
Приклад
seccomp
Обмежуйте окремі виклики ядра в просторі користувача. Зменшує ймовірність того, що вразливість, яка використовує обмежений системний виклик, скомпрометує систему.
Вказуйте завантажений профіль seccomp у специфікації Podʼа або контейнера, щоб застосувати його обмеження до процесів у Podʼі.
Відхиляйте системний виклик unshare, який використовувався в CVE-2022-0185.
AppArmor
Обмежуйте доступ програм до певних ресурсів. Зменшує поверхню атаки програми. Покращує логування аудиту.
Вкажіть завантажений профіль AppArmor у специфікації контейнера.
Заборонити програмі, що працює лише для читання, запис за будь-яким шляхом у системі.
SELinux
Обмежуйте доступ до ресурсів, таких як файли, застосунки, порти та процеси за допомогою міток та політик безпеки.
Вкажіть обмеження доступу для конкретних міток. Позначте процеси цими мітками, щоб застосувати обмеження доступу, повʼязані з міткою.
Заборонити контейнеру доступ до файлів поза його власною файловою системою.
Примітка:
Механізми на кшталт AppArmor і SELinux можуть забезпечувати захист, що виходить за межі контейнера. Наприклад, SELinux може допомогти помʼякшити CVE-2019-5736.
Міркування щодо керування власними конфігураціями
seccomp, AppArmor і SELinux зазвичай мають стандартну конфігурацію, що надає базовий захист. Ви також можете створювати власні профілі й політики, що відповідають вимогам ваших робочих навантажень. Керування цими власними конфігураціями та їх розповсюдження у великому масштабі може бути складним, особливо якщо ви використовуєте всі три можливості разом. Для цього використовуйте інструмент на кшталт Kubernetes Security Profiles Operator.
Можливості безпеки на рівні ядра та привілейовані контейнери
Kubernetes дозволяє вказати, що деякі довірені контейнери можуть працювати в привілейованому режимі. Будь-який контейнер у Podʼі може працювати в привілейованому режимі, щоб використовувати адміністративні capabilities операційної системи, які інакше були б недоступні. Це доступно і для Windows, і для Linux.
Привілейовані контейнери явно перевизначають деякі обмеження ядра Linux, які ви можете використовувати у своїх робочих навантаженнях:
seccomp: Привілейовані контейнери працюють із профілем seccomp Unconfined, перевизначаючи будь-який профіль seccomp, вказаний у маніфесті.
AppArmor: Привілейовані контейнери ігнорують будь-які застосовані профілі AppArmor.
SELinux: Привілейовані контейнери працюють у домені unconfined_t.
Привілейовані контейнери
Будь-який контейнер у Podʼі може ввімкнути привілейований режим, якщо встановити privileged: true у полі securityContext контейнера. Привілейовані контейнери перевизначають або скасовують багато інших налаштувань зміцнення безпеки, таких як застосований профіль seccomp, профіль AppArmor або обмеження SELinux. Привілейовані контейнери отримують усі capabilities Linux, зокрема ті, які їм не потрібні. Наприклад, користувач root у привілейованому контейнері може використовувати capabilities CAP_SYS_ADMIN і CAP_NET_ADMIN на вузлі, оминаючи конфігурацію seccomp середовища виконання та інші обмеження.
У більшості випадків слід уникати привілейованих контейнерів і натомість надавати контейнеру потрібні capabilities за допомогою поля capabilities у полі securityContext. Використовуйте привілейований режим, лише якщо потрібна capability, яку не можна надати через securityContext. Це корисно для контейнерів, яким потрібні адміністративні capabilities операційної системи, наприклад для керування мережевим стеком або доступу до апаратних пристроїв.
У Kubernetes 1.26 і новіших ви також можете запускати контейнери Windows у подібному привілейованому режимі, встановивши прапорець windowsOptions.hostProcess у контексті безпеки специфікації Podʼа. Докладніше дивіться в розділі Створення HostProcess Pod для Windows.
Рекомендації
Перш ніж налаштовувати можливості безпеки на рівні ядра, розгляньте впровадження ізоляції на рівні мережі. Докладніше читайте в розділі Список перевірки безпеки.
Якщо немає потреби в іншому, запускайте робочі навантаження Linux не від імені root, вказавши конкретні ідентифікатори користувача та групи в маніфесті Podʼа та runAsNonRoot: true.
Крім того, ви можете запускати робочі навантаження в просторах імен користувачів, встановивши hostUsers: false у маніфесті Podʼа. Це дозволяє запускати контейнери від імені root у просторі імен користувача, але не від імені root у просторі імен хоста на вузлі. Ця можливість ще на ранніх етапах розробки й може не мати потрібного вам рівня підтримки. Інструкції дивіться в розділі Використання простору імен користувачів із Podʼом.
Базовий список перевірки для забезпечення безпеки в кластерах Kubernetes.
Цей список перевірки має на меті надати базовий перелік настанов із посиланнями на докладнішу документацію з кожної теми. Він не претендує на вичерпність і буде змінюватися з часом.
Як читати й використовувати цей документ:
Порядок тем не відображає порядок пріоритетів.
Деякі пункти списку описано докладніше в абзаці під списком кожного розділу.
Увага:
Самих лише списків перевірки недостатньо для досягнення належного рівня безпеки. Належний рівень безпеки потребує постійної уваги й удосконалення, але список перевірки може бути першим кроком на нескінченному шляху до готовності в питаннях безпеки. Деякі рекомендації в цьому списку можуть бути надто обмежувальними або надто мʼякими для ваших конкретних потреб у безпеці. Оскільки безпека Kubernetes не є універсальною для всіх, кожну категорію пунктів списку слід оцінювати окремо.
Автентифікація та авторизація
Група system:masters не використовується для автентифікації користувачів чи компонентів після початкового налаштування.
Компонент kube-controller-manager працює з увімкненим параметром --use-service-account-credentials.
Кореневий сертифікат захищений (або офлайн CA, або керований онлайн CA з ефективними засобами контролю доступу).
Проміжні та кінцеві сертифікати мають строк дії не більше ніж 3 роки наперед.
Існує процес періодичного перегляду доступу, і перегляди відбуваються з інтервалом не більше ніж 24 місяці.
Після початкового налаштування ні користувачі, ні компоненти не повинні автентифікуватися в API Kubernetes як system:masters. Так само слід уникати запуску всього kube-controller-manager від імені system:masters. Фактично system:masters слід використовувати лише як механізм аварійного доступу, а не як адміністративного користувача.
Безпека мережі
CNI-втулки, що використовуються, підтримують мережеві політики.
Мережеві політики для вхідного та вихідного трафіку застосовано до всіх робочих навантажень у кластері.
У кожному просторі імен діють стандартні мережеві політики, які вибирають усі Podʼи та забороняють усе.
За потреби використовується service mesh для шифрування всіх зʼєднань усередині кластера.
Доступ до API Kubernetes, API kubelet та etcd не відкрито публічно в Інтернеті.
Доступ робочих навантажень до API хмарних метаданих фільтрується.
Використання LoadBalancer та ExternalIPs обмежено.
Низка втулків Container Network Interface (CNI) дозволяє обмежувати мережеві ресурси, з якими можуть взаємодіяти Podʼи. Найчастіше це робиться за допомогою мережевих політик, які є ресурсом у межах простору імен для визначення правил. Стандартні мережеві політики, які блокують увесь вихідний і вхідний трафік у кожному просторі імен, вибираючи всі Podʼи, допомагають застосувати підхід зі списком дозволеного й переконатися, що жодне робоче навантаження не пропущено.
Не всі CNI-втулки забезпечують шифрування під час передавання. Якщо обраний втулок не має цієї можливості, альтернативним рішенням може бути використання service mesh.
Сховище даних etcd панелі управління повинно мати засоби обмеження доступу й не повинно бути публічно доступним в Інтернеті. Крім того, для безпечного звʼязку з ним слід використовувати взаємний TLS (mTLS). Центр сертифікації для цього має бути окремим, лише для etcd.
Зовнішній доступ з Інтернету до API-сервера Kubernetes слід обмежити, щоб не відкривати API публічно. Будьте обережні: багато керованих дистрибутивів Kubernetes стандартно відкривають публічний доступ до API-сервера. У такому разі для доступу до сервера можна використовувати хост-бастіон.
Доступ до API kubelet слід обмежити й не відкривати публічно: стандартні налаштування автентифікації та авторизації, якщо файл конфігурації не вказано прапорцем --config, є надто дозвільними.
Якщо Kubernetes розміщено в хмарного провайдера, доступ Podʼів до API хмарних метаданих 169.254.169.254 також слід обмежити або заблокувати, якщо він не потрібен, оскільки це може призвести до витоку інформації.
Права RBAC create, update, patch, delete для робочих навантажень надаються лише за потреби.
Для всіх просторів імен визначено й примусово застосовано відповідну політику стандартів безпеки Podʼів.
Для робочих навантажень встановлено обмеження памʼяті, що дорівнює запиту або менше за нього.
Для чутливих робочих навантажень можна встановити обмеження CPU.
На вузлах, що його підтримують, увімкнено Seccomp з відповідним профілем syscalls для програм.
На вузлах, що їх підтримують, увімкнено AppArmor або SELinux з відповідним профілем для програм.
Авторизація RBAC є важливою, але не може бути достатньо деталізованою, щоб авторизувати дії з ресурсами Podʼів (або з будь-яким ресурсом, який керує Podʼами). Єдиним рівнем деталізації є дієслова API для самого ресурсу, наприклад create для Podʼів. Без додаткового контролю допуску дозвіл на створення цих ресурсів надає прямий необмежений доступ до придатних для планування вузлів кластера.
Стандарти безпеки Podʼів визначають три різні політики: privileged, baseline і restricted, які обмежують, як можна встановлювати поля PodSpec, що стосуються безпеки. Ці стандарти можна примусово застосовувати на рівні простору імен за допомогою нового допуску Pod Security, стандартно ввімкненого, або стороннього вебхука допуску. Зверніть увагу, що, на відміну від вилученого допуску PodSecurityPolicy, який він замінює, допуск Pod Security можна легко поєднувати з вебхуками допуску та зовнішніми сервісами.
Політика restricted допуску Pod Security, найсуворіша політика з набору стандартів безпеки Podʼів, може працювати в кількох режимах, warn, audit або enforce, щоб поступово застосовувати найвідповідніший контекст безпеки згідно з рекомендаціями з безпеки. Проте контекст безпеки Podʼів слід досліджувати окремо, щоб обмежити привілеї та доступ, які Podʼи можуть мати понад наперед визначені стандарти безпеки, для конкретних сценаріїв використання.
Обмеження памʼяті та CPU слід встановлювати, щоб обмежити ресурси памʼяті та CPU, які Pod може споживати на вузлі, і таким чином запобігти можливим DoS-атакам зі зловмисних або скомпрометованих робочих навантажень. Таку політику може примусово застосовувати контролер допуску. Зверніть увагу, що обмеження CPU спричиняють тротлінг і тому можуть мати небажаний вплив на можливості автомасштабування або на ефективність, тобто на виконання процесу в режимі best effort з доступними ресурсами CPU.
Увага:
Обмеження памʼяті, що перевищує запит, може наразити весь вузол на проблеми з OOM.
Увімкнення Seccomp
Seccomp означає режим безпечних обчислень (secure computing mode) і є можливістю ядра Linux з версії 2.6.12. Його можна використовувати, щоб ізолювати привілеї процесу в пісочниці, обмежуючи виклики, які він може робити з простору користувача до ядра. Kubernetes дозволяє автоматично застосовувати до ваших Podʼів і контейнерів профілі seccomp, завантажені на вузол.
Seccomp може покращити безпеку ваших робочих навантажень, зменшуючи поверхню атаки через системні виклики ядра Linux, доступну всередині контейнерів. Режим фільтрації seccomp використовує BPF для створення списків дозволених або заборонених конкретних системних викликів, які називаються профілями.
Починаючи з Kubernetes 1.27, ви можете ввімкнути використання RuntimeDefault як стандартного профілю seccomp для всіх робочих навантажень. На цю тему є навчальний матеріал з безпеки. Крім того, Kubernetes Security Profiles Operator — це проєкт, що полегшує керування seccomp і його використання в кластерах.
Примітка:
Seccomp доступний лише на вузлах Linux.
Увімкнення AppArmor або SELinux
AppArmor
AppArmor — це модуль безпеки ядра Linux, який може забезпечити простий спосіб реалізації обовʼязкового контролю доступу (MAC, Mandatory Access Control) та кращого аудиту через системні логи. На вузлах, які його підтримують, примусово застосовується стандартний профіль AppArmor, або можна налаштувати власний профіль. Як і seccomp, AppArmor налаштовується через профілі, де кожен профіль працює або в режимі примусового застосування (enforcing), який блокує доступ до заборонених ресурсів, або в режимі скарг (complain), який лише повідомляє про порушення. Профілі AppArmor застосовуються до кожного контейнера окремо за допомогою анотації, що дозволяє процесам отримувати саме ті привілеї, які їм потрібні.
SELinux також є модулем безпеки ядра Linux, який надає механізм підтримки політик безпеки контролю доступу, зокрема обовʼязкового контролю доступу (MAC). Мітки SELinux можна призначати контейнерам або Podʼам через їхній розділ securityContext.
Логи аудиту, якщо їх увімкнено, захищені від загального доступу.
Розташування Podʼів
Розташування Podʼів відповідає рівням чутливості застосунку.
Чутливі застосунки працюють ізольовано на вузлах або з окремими середовищами виконання в пісочниці.
Podʼи різних рівнів чутливості, наприклад Pod застосунку та API-сервер Kubernetes, слід розгортати на окремих вузлах. Мета ізоляції вузлів — не дати зловмиснику після виходу за межі контейнера застосунку отримати прямий доступ до застосунків із вищим рівнем чутливості й легко переміщуватися кластером. Це розділення слід забезпечувати примусово, щоб Podʼи випадково не розгорталися на тому самому вузлі. Для цього можна використовувати такі можливості:
Пари ключ-значення в специфікації Podʼа, які вказують, на яких вузлах його розгортати. Їх можна примусово застосовувати на рівні простору імен і кластера за допомогою контролера допуску PodNodeSelector.
Контролер допуску, який дозволяє адміністраторам обмежувати дозволені tolerations у межах простору імен. Podʼи в просторі імен можуть використовувати лише tolerations, вказані в ключах анотації обʼєкта простору імен, які задають набір стандартних і дозволених tolerations.
RuntimeClass — це можливість вибору конфігурації середовища виконання контейнерів. Ця конфігурація використовується для запуску контейнерів Podʼа й може забезпечувати більшу або меншу ізоляцію від хоста ціною додаткових витрат продуктивності.
Secrets
ConfigMaps не використовуються для зберігання конфіденційних даних.
Для Secret API налаштовано шифрування у стані спокою.
За потреби розгорнуто й доступний механізм для додавання Secrets, що зберігаються в сторонньому сховищі.
Токени ServiceAccount не монтуються в Podʼи, яким вони не потрібні.
Конфіденційні дані, потрібні Podʼам, слід зберігати в обʼєктах Secret Kubernetes, а не в альтернативах на кшталт ConfigMap. Ресурси Secret, що зберігаються в etcd, слід шифрувати у стані спокою.
Podʼи, яким потрібні Secrets, повинні отримувати їх автоматично змонтованими через томи, бажано збереженими в памʼяті, як-от за допомогою параметра emptyDir.medium. Цей механізм також можна використовувати для додавання Secrets зі сторонніх сховищ у вигляді томів, як-от у Secrets Store CSI Driver. Цьому способу слід надавати перевагу перед наданням ServiceAccount Podʼа доступу RBAC до Secrets. Це дозволить додавати Secrets у Pod як змінні середовища або файли. Зверніть увагу, що спосіб зі змінними середовища може бути більш схильним до витоків через аварійні дампи в логах і неконфіденційну природу змінних середовища в Linux, на відміну від механізму дозволів на файли.
Токени ServiceAccount не слід монтувати в Podʼи, яким вони не потрібні. Це можна налаштувати, встановивши automountServiceAccountToken у false або в ServiceAccount, щоб застосувати це до всього простору імен, або окремо для Podʼа. Для Kubernetes v1.22 і новіших використовуйте привʼязані ServiceAccounts для обмежених у часі облікових даних ServiceAccount.
Образи
Мінімізуйте непотрібний вміст в образах контейнерів.
Образи контейнерів налаштовано на запуск від імені непривілейованого користувача.
На образи контейнерів посилаються за дайджестами sha256 (а не за теґами), або походження образу підтверджується перевіркою його цифрового підпису під час розгортання через контроль допуску.
Образи контейнерів регулярно скануються під час створення та розгортання, а для відомого вразливого програмного забезпечення застосовуються виправлення.
Образ контейнера повинен містити лише мінімум, потрібний для запуску програми, яку він пакує. Бажано лише програму та її залежності, а сам образ слід збирати з мінімально можливої бази. Зокрема, образи, що використовуються в промисловому середовищі, не повинні містити оболонок або засобів налагодження, оскільки для усунення несправностей можна використовувати ефемерний контейнер налагодження.
Збирайте образи так, щоб вони одразу запускалися від імені непривілейованого користувача, за допомогою інструкції USER у Dockerfile. Контекст безпеки дозволяє запускати образ контейнера від імені певного користувача та групи за допомогою runAsUser і runAsGroup, навіть якщо їх не вказано в маніфесті образу. Однак дозволи на файли в шарах образу можуть унеможливити простий запуск процесу від імені нового непривілейованого користувача без зміни образу.
Уникайте посилань на образ за теґом, особливо за теґом latest, оскільки образ за теґом можна легко змінити в реєстрі. Надавайте перевагу повному дайджесту sha256, який є унікальним для маніфесту образу. Цю політику можна примусово застосовувати за допомогою ImagePolicyWebhook. Підписи образів також можна автоматично перевіряти контролером допуску під час розгортання, щоб підтверджувати їхню автентичність і цілісність.
Сканування образу контейнера може запобігти потраплянню критичних вразливостей до кластера разом з образом. Сканування образу слід завершувати до розгортання образу контейнера в кластері, і зазвичай воно виконується як частина процесу розгортання в конвеєрі CI/CD. Мета сканування образу — отримати інформацію про можливі вразливості та їх запобігання в образі контейнера, наприклад оцінку Common Vulnerability Scoring System (CVSS). Якщо результати сканування поєднати з правилами відповідності конвеєра, до промислового середовища потраплять лише образи контейнерів із належними виправленнями.
Контролери допуску
Увімкнено відповідний набір контролерів допуску.
Політика безпеки Podʼів примусово застосовується за допомогою Pod Security Admission та/або контролера допуску на основі вебхука.
Втулки ланцюжка допуску та вебхуки налаштовано безпечно.
Контролери допуску можуть допомогти покращити безпеку кластера. Однак вони самі можуть становити ризики, оскільки розширюють API-сервер і мають бути належно захищені.
У наведених нижче списках подано низку контролерів допуску, які варто розглянути для покращення безпеки вашого кластера та застосунку. Сюди входять контролери, на які можуть бути посилання в інших частинах цього документа.
Ця перша група контролерів допуску містить втулки, стандартно ввімкнені. Залишайте їх увімкненими, якщо тільки не розумієте, що робите:
Обмежує дозволи kubelet лише зміною ресурсів API Podʼів, які йому належать, або ресурсу API вузла, що його представляє. Він також не дозволяє kubelet використовувати анотацію node-restriction.kubernetes.io/, яку зловмисник із доступом до облікових даних kubelet міг би використати, щоб впливати на розміщення Podʼів на контрольованому вузлі.
Третя група містить втулки, які стандартно не ввімкнені, але їх можна розглянути для певних сценаріїв використання:
Базові рекомендації щодо забезпечення безпеки застосунків у Kubernetes, орієнтовані на розробників застосунків.
Цей список перевірки містить основні рекомендації щодо захисту застосунків, що працюють у Kubernetes, з погляду розробника. Він не є вичерпним і змінюватиметься з часом.
Як читати та використовувати цей документ:
Порядок тем не відображає пріоритетність.
Деякі пункти списку детально описані в абзаці нижче списку кожного розділу.
Цей список передбачає, що розробник — це користувач кластера Kubernetes, який взаємодіє з обʼєктами в межах простору імен.
Увага:
Самих лише списків перевірки не достатньо для досягнення належного рівня безпеки. Належний рівень безпеки потребує постійної уваги та вдосконалення, але список перевірки може бути першим кроком на нескінченному шляху до готовності в питаннях безпеки. Деякі рекомендації в цьому списку можуть бути занадто суворими або занадто мʼякими для ваших конкретних потреб у безпеці. Оскільки безпека Kubernetes не є універсальною, кожну категорію пунктів списку слід оцінювати окремо.
Базове зміцнення безпеки
Наведений нижче список містить рекомендації з базового зміцнення безпеки, які стосуються більшості застосунків, що розгортаються в Kubernetes.
Дизайн застосунків
Дотримуйтеся відповідних принципів безпеки під час проєктування застосунків.
Застосунок налаштовано з відповідним класом QoS через запити й обмеження ресурсів.
Для робочих навантажень встановлено обмеження памʼяті, яке дорівнює запиту або перевищує його.
Для чутливих робочих навантажень можна встановити обмеження CPU.
ServiceAccount
Уникайте використання ServiceAccount default. Створюйте ServiceAccount для кожного робочого навантаження або мікросервісу.
automountServiceAccountToken слід встановити в false, якщо Podʼу не потрібен доступ до API Kubernetes для роботи.
Рекомендації для securityContext на рівні Podʼа
Встановіть runAsNonRoot: true.
Налаштуйте контейнер на виконання від імені менш привілейованого користувача (наприклад, за допомогою runAsUser і runAsGroup) і налаштуйте відповідні дозволи на файли або теки в образі контейнера.
За потреби додайте допоміжну групу через fsGroup для доступу до постійних томів.
Застосунок розгортається в просторі імен, де застосовується відповідний стандарт безпеки Podʼів. Якщо ви не можете контролювати це застосування в кластерах, де розгортається застосунок, врахуйте це в документації або через додатковий багаторівневий захист (defense in depth).
Рекомендації для securityContext на рівні контейнера
Вимкніть підвищення привілеїв за допомогою allowPrivilegeEscalation: false.
Налаштуйте кореневу файлову систему лише для читання за допомогою readOnlyRootFilesystem: true.
Вилучіть усі capabilities з контейнерів і поверніть лише ті, які потрібні для роботи контейнера.
Контроль доступу на основі ролей (RBAC)
Дозволи, такі як create, patch, update і delete, слід надавати лише за потребою.
Уникайте дозволів RBAC на створення або оновлення ролей, що може призвести до підвищення привілеїв.
Перегляньте привʼязки для групи system:unauthenticated і видаліть їх, якщо можливо, оскільки це надає доступ будь-кому, хто може підʼєднатися до API-сервера на мережевому рівні.
Для чутливих робочих навантажень розгляньте можливість надання рекомендованої ValidatingAdmissionPolicy, яка додатково обмежує дозволені дії запису.
Безпека образів
Використовуйте інструмент для сканування образів перед розгортанням контейнерів у кластері Kubernetes.
Використовуйте підписування контейнерів для перевірки підпису образу контейнера перед розгортанням у кластері Kubernetes.
Мережеві політики
Налаштуйте NetworkPolicies, щоб дозволити лише очікуваний вхідний та вихідний трафік Podʼів.
Переконайтеся, що ваш кластер підтримує та застосовує NetworkPolicy. Якщо ви пишете застосунок, який користувачі розгортатимуть у різних кластерах, подумайте, чи можна припускати, що NetworkPolicy доступна й застосовується.
Розширене зміцнення безпеки
У цьому розділі посібника розглянуто деякі розширені аспекти зміцнення безпеки, які можуть бути корисними залежно від налаштування середовища Kubernetes.
Налаштуйте відповідні класи виконання для контейнерів.
Примітка: Цей розділ містить посилання на проєкти сторонніх розробників, які надають функціонал, необхідний для Kubernetes. Автори проєкту Kubernetes не несуть відповідальності за ці проєкти. Проєкти вказано в алфавітному порядку. Щоб додати проєкт до цього списку, ознайомтеся з посібником з контенту перед надсиланням змін. Докладніше.
Деяким контейнерам може знадобитися інший рівень ізоляції, ніж той, що забезпечує стандартне середовище виконання кластера. runtimeClassName можна використовувати у podspec для визначення іншого класу виконання.
Для чутливих робочих навантажень розгляньте використання інструментів емуляції ядра, таких як gVisor, або віртуалізованої ізоляції за допомогою механізму, такого як kata-containers.
У середовищах із високою довірою розгляньте використання конфіденційних віртуальних машин, щоб ще більше підвищити безпеку кластера.