Багатоорендність
На цій сторінці наведено огляд доступних параметрів конфігурації та рекомендацій щодо багатоорендності кластера.
Спільне використання кластерів зменшує витрати й спрощує адміністрування. Однак воно також створює проблеми, такі як безпека, справедливість і керування шумними сусідами.
Кластери можна використовувати спільно багатьма способами. У деяких випадках у тому самому кластері можуть працювати різні застосунки. В інших випадках у тому самому кластері може працювати кілька екземплярів одного застосунку, по одному для кожного кінцевого користувача. Усі ці типи спільного використання часто описують загальним терміном багатоорендність (multi-tenancy).
Хоча в Kubernetes немає повноцінних понять кінцевих користувачів або орендарів, він надає кілька можливостей для керування різними вимогами до багатоорендності. Їх описано нижче.
Сценарії використання
Перший крок до визначення способу спільного використання кластера — зрозуміти ваш сценарій використання, щоб оцінити доступні шаблони та інструменти. Загалом багатоорендність у кластерах Kubernetes поділяється на дві широкі категорії, хоча можливо також багато варіантів і гібридів.
Кілька команд
Поширена форма багатоорендності — спільне використання кластера кількома командами в межах організації, кожна з яких може експлуатувати одне або кілька робочих навантажень. Ці робочі навантаження часто мають взаємодіяти між собою та з іншими робочими навантаженнями в тому самому або інших кластерах.
У цьому сценарії учасники команд часто мають прямий доступ до ресурсів Kubernetes через інструменти на кшталт kubectl або опосередкований доступ через контролери GitOps чи інші інструменти автоматизації випусків. Між учасниками різних команд часто є певний рівень довіри, але політики Kubernetes, такі як RBAC, квоти та мережеві політики, необхідні для безпечного й справедливого спільного використання кластерів.
Кілька клієнтів
Інша основна форма багатоорендності часто стосується постачальника програмного забезпечення як сервісу (SaaS), який запускає кілька екземплярів робочого навантаження для клієнтів. Ця бізнес-модель настільки тісно повʼязана з таким способом розгортання, що багато хто називає його «SaaS tenancy». Однак кращим терміном може бути «багатоклієнтська оренда» (multi-customer tenancy), оскільки постачальники SaaS можуть використовувати й інші моделі розгортання, а цю модель розгортання можна використовувати й поза SaaS.
У цьому сценарії клієнти не мають доступу до кластера; з їхнього погляду Kubernetes невидимий, і його використовує лише постачальник для керування робочими навантаженнями. Оптимізація витрат часто є критично важливою, а політики Kubernetes використовуються для надійної ізоляції робочих навантажень одне від одного.
Термінологія
Орендарі
Під час обговорення багатоорендності в Kubernetes немає єдиного визначення «орендаря» (tenant). Воно залежить від того, про яку оренду йдеться: багатокомандну чи багатоклієнтську.
У багатокомандному використанні орендарем зазвичай є команда, і кожна команда зазвичай розгортає невелику кількість робочих навантажень, яка зростає разом зі складністю сервісу. Однак саме визначення «команди» може бути нечітким, оскільки команди можуть обʼєднуватися в підрозділи вищого рівня або ділитися на менші команди.
Натомість якщо кожна команда розгортає окремі робочі навантаження для кожного нового клієнта, вона використовує багатоклієнтську модель оренди. У цьому випадку «орендар» — це просто група користувачів, які спільно використовують одне робоче навантаження. Це може бути ціла компанія або лише одна команда в цій компанії.
У багатьох випадках одна й та сама організація може використовувати обидва визначення «орендарів» у різних контекстах. Наприклад, команда платформи може пропонувати спільні сервіси, такі як інструменти безпеки й бази даних, кільком внутрішнім «клієнтам», а постачальник SaaS може мати кілька команд, які спільно використовують кластер для розробки. Нарешті, можливі й гібридні архітектури, наприклад постачальник SaaS, який поєднує окремі для кожного клієнта робочі навантаження для конфіденційних даних зі спільними багатоорендними сервісами.
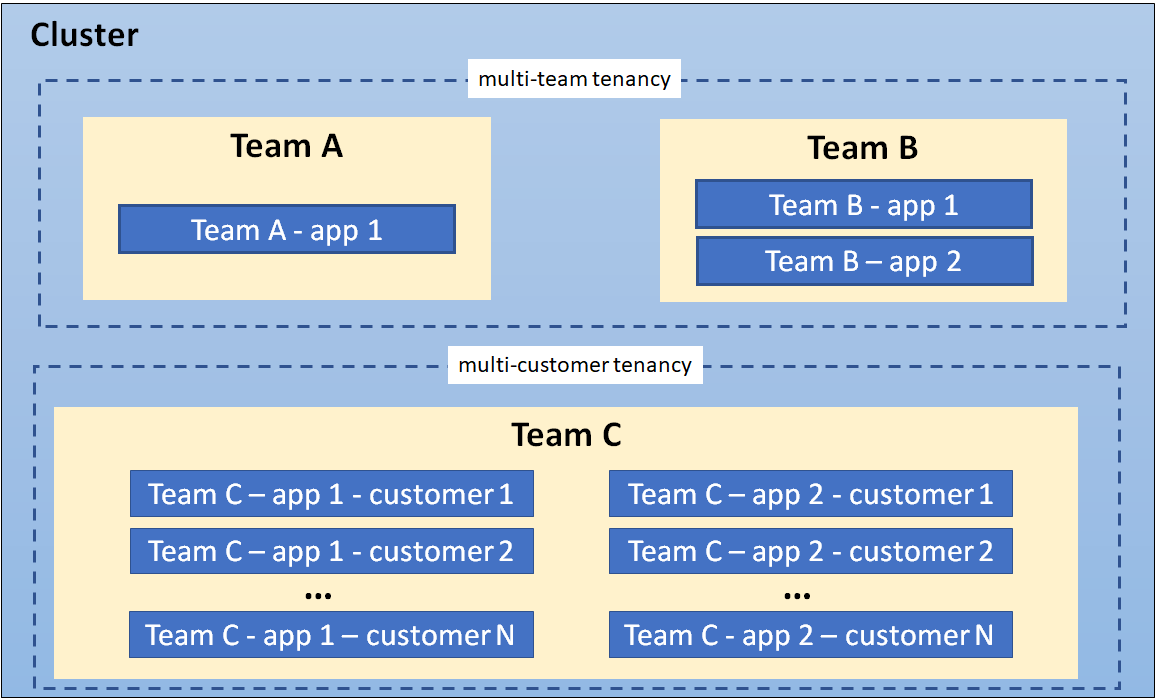
Кластер, на якому співіснують різні моделі оренди
Ізоляція
Існує кілька способів проєктування й побудови багатоорендних рішень у Kubernetes. Кожен із цих методів має власний набір компромісів, що впливають на рівень ізоляції, зусилля на реалізацію, операційну складність і вартість обслуговування.
Кластер Kubernetes складається з панелі управління, на якій працює програмне забезпечення Kubernetes, і панелі даних, що складається з робочих вузлів, де робочі навантаження орендарів виконуються як Podʼи. Ізоляцію орендарів можна застосовувати і в панелі управління, і в панелі даних залежно від вимог організації.
Рівень ізоляції іноді описують термінами на кшталт «жорстка» багатоорендність, що передбачає сильну ізоляцію, і «мʼяка» багатоорендність, що передбачає слабшу ізоляцію. Зокрема, «жорстка» багатоорендність часто описує випадки, коли орендарі не довіряють одне одному, переважно з погляду безпеки та спільного використання ресурсів (наприклад, захист від атак на кшталт викрадення даних або DoS). Оскільки панелі даних зазвичай мають значно більшу поверхню атаки, «жорстка» багатоорендність часто потребує додаткової уваги до ізоляції панелі даних, хоча ізоляція панелі управління також залишається критично важливою.
Однак терміни «жорстка» і «мʼяка» часто можуть заплутувати, оскільки немає єдиного визначення, що підходило б усім користувачам. Краще розглядати «жорсткість» чи «мʼякість» як широкий спектр із багатьма різними техніками, які можна використовувати для підтримання різних типів ізоляції у ваших кластерах залежно від ваших вимог.
У більш екстремальних випадках може бути простіше або необхідно повністю відмовитися від спільного використання на рівні кластера й виділити кожному орендарю власний кластер, можливо, навіть на виділеному обладнанні, якщо віртуальні машини не вважаються достатньою межею безпеки. Це може бути простіше з керованими кластерами Kubernetes, де накладні витрати на створення й експлуатацію кластерів принаймні частково бере на себе хмарний провайдер. Перевагу сильнішої ізоляції орендарів слід зважувати проти вартості та складності керування кількома кластерами. За такі сценарії використання відповідає Multi-cluster SIG.
Решта цієї сторінки присвячена технікам ізоляції для спільних кластерів Kubernetes. Однак навіть якщо ви розглядаєте виділені кластери, варто переглянути ці рекомендації, оскільки вони дадуть вам гнучкість для переходу на спільні кластери в майбутньому, якщо ваші потреби чи можливості зміняться.
Ізоляція панелі управління
Ізоляція панелі управління гарантує, що різні орендарі не можуть отримувати доступ до ресурсів API Kubernetes одне одного або впливати на них.
Простори імен
У Kubernetes простір імен надає механізм ізоляції груп ресурсів API в межах одного кластера. Ця ізоляція має два ключові виміри:
Назви обʼєктів у межах простору імен можуть збігатися з назвами в інших просторах імен, подібно до файлів у теках. Це дозволяє орендарям називати свої ресурси, не зважаючи на те, що роблять інші орендарі.
Багато політик безпеки Kubernetes діють у межах просторів імен. Наприклад, RBAC Roles і Network Policies є ресурсами в межах простору імен. За допомогою RBAC користувачів і ServiceAccounts можна обмежити простором імен.
У багатоорендному середовищі простір імен допомагає виділити робоче навантаження орендаря в логічну й окрему одиницю керування. Поширеною практикою є ізоляція кожного робочого навантаження у власному просторі імен, навіть якщо кількома робочими навантаженнями керує той самий орендар. Це гарантує, що кожне робоче навантаження має власну ідентичність і може бути налаштоване з відповідною політикою безпеки.
Модель ізоляції на основі просторів імен потребує налаштування кількох інших ресурсів Kubernetes, мережевих втулків і дотримання рекомендацій з безпеки для належної ізоляції робочих навантажень орендарів. Ці міркування описано нижче.
Контроль доступу
Найважливіший тип ізоляції для панелі управління — авторизація. Якщо команди або їхні робочі навантаження можуть отримувати доступ до ресурсів API одне одного або змінювати їх, вони можуть змінювати або вимикати всі інші типи політик, зводячи нанівець будь-який захист, який ці політики можуть надавати. Тому критично важливо забезпечити, щоб кожен орендар мав відповідний доступ лише до потрібних йому просторів імен і не більше. Це називають «принципом найменших привілеїв».
Контроль доступу на основі ролей (RBAC) зазвичай використовується для забезпечення авторизації в панелі управління Kubernetes як для користувачів, так і для робочих навантажень (ServiceAccounts). Roles і RoleBindings — це обʼєкти Kubernetes, які використовуються на рівні простору імен для забезпечення контролю доступу у вашому застосунку; подібні обʼєкти існують і для авторизації доступу до обʼєктів на рівні кластера, хоча вони менш корисні для багатоорендних кластерів.
У багатокомандному середовищі RBAC слід використовувати, щоб обмежити доступ орендарів відповідними просторами імен і гарантувати, що до ресурсів на рівні кластера можуть отримувати доступ або змінювати їх лише привілейовані користувачі, такі як адміністратори кластера.
Якщо політика зрештою надає користувачеві більше дозволів, ніж йому потрібно, це, ймовірно, сигнал, що простір імен із відповідними ресурсами слід розділити на дрібніші простори імен. Інструменти керування просторами імен можуть спростити керування цими дрібнішими просторами імен, застосовуючи спільні політики RBAC до різних просторів імен і водночас дозволяючи за потреби детальніші політики.
Квоти
Робочі навантаження Kubernetes споживають ресурси вузлів, такі як CPU і памʼять. У багатоорендному середовищі ви можете використовувати квоти ресурсів для керування використанням ресурсів робочими навантаженнями орендарів. У сценарії з кількома командами, де орендарі мають доступ до API Kubernetes, ви можете використовувати квоти ресурсів, щоб обмежити кількість ресурсів API (наприклад, кількість Podʼів або ConfigMaps), які може створити орендар. Обмеження кількості обʼєктів забезпечують справедливість і допомагають уникнути проблем із шумними сусідами, що впливають на інших орендарів, які використовують спільну панель управління.
Квоти ресурсів — це обʼєкти в межах простору імен. Зіставляючи орендарів із просторами імен, адміністратори кластера можуть використовувати квоти, щоб орендар не міг монополізувати ресурси кластера або перевантажити його панель управління. Інструменти керування просторами імен спрощують адміністрування квот. Крім того, хоча квоти Kubernetes застосовуються лише в межах одного простору імен, деякі інструменти керування просторами імен дозволяють групам просторів імен спільно використовувати квоти, що дає адміністраторам значно більше гнучкості за менших зусиль, ніж вбудовані квоти.
Квоти не дають одному орендарю споживати більше виділеної йому частки ресурсів, мінімізуючи таким чином проблему «шумного сусіда», коли один орендар негативно впливає на продуктивність робочих навантажень інших орендарів.
Коли ви застосовуєте квоту до простору імен, Kubernetes вимагає також вказати запити й обмеження ресурсів для кожного контейнера. Обмеження — це верхня межа кількості ресурсів, яку може споживати контейнер. Контейнери, які намагаються спожити більше ресурсів, ніж дозволяють налаштовані обмеження, зазнають тротлінгу або примусово завершуються залежно від типу ресурсу. Якщо запити ресурсів встановлено нижче за обмеження, кожному контейнеру гарантовано запитану кількість, але певний вплив між робочими навантаженнями все ще можливий.
Квоти не можуть захистити від усіх видів спільного використання ресурсів, наприклад мережевого трафіку. Кращим рішенням цієї проблеми може бути ізоляція вузлів (описана нижче).
Ізоляція панелі даних
Ізоляція панелі даних гарантує, що Podʼи та робочі навантаження різних орендарів достатньо ізольовані.
Мережева ізоляція
Стандартно всі Podʼи в кластері Kubernetes можуть взаємодіяти між собою, а весь мережевий трафік не зашифрований. Це може призвести до вразливостей безпеки, коли трафік випадково або зловмисно надсилається не за призначенням або перехоплюється робочим навантаженням на скомпрометованому вузлі.
Взаємодію між Podʼами можна контролювати за допомогою мережевих політик, які обмежують взаємодію між Podʼами за мітками просторів імен або діапазонами IP-адрес. У багатоорендному середовищі, де потрібна сувора мережева ізоляція між орендарями, рекомендується починати зі стандартної політики, яка забороняє взаємодію між Podʼами, та ще одного правила, яке дозволяє всім Podʼам звертатися до сервера DNS для розвʼязання імен. Маючи таку стандартну політику, можна додавати більш дозвільні правила, що дозволяють взаємодію в межах простору імен. Також рекомендується не використовувати порожній селектор міток '{}' для поля namespaceSelector у визначенні мережевої політики, якщо потрібно дозволити трафік між просторами імен. Цю схему можна вдосконалювати за потреби. Зверніть увагу, що це стосується лише Podʼів у межах однієї панелі управління; Podʼи, що належать до різних віртуальних панелей управління, не можуть взаємодіяти між собою через мережу Kubernetes.
Інструменти керування просторами імен можуть спростити створення стандартних або спільних мережевих політик. Крім того, деякі з цих інструментів дозволяють примусово застосовувати узгоджений набір міток просторів імен у всьому кластері, що робить їх надійною основою для ваших політик.
Попередження:
Мережеві політики потребують втулка CNI, який підтримує реалізацію мережевих політик. Інакше ресурси NetworkPolicy ігноруватимуться.Більш розвинену мережеву ізоляцію можуть забезпечувати service mesh, які надають політики 7-го рівня OSI на основі ідентичності робочих навантажень на додачу до просторів імен. Ці політики вищого рівня можуть полегшити керування багатоорендністю на основі просторів імен, особливо коли кілька просторів імен виділено одному орендарю. Вони часто також пропонують шифрування за допомогою взаємного TLS, захищаючи ваші дані навіть за наявності скомпрометованого вузла, і працюють на виділених або віртуальних кластерах. Однак вони можуть бути значно складнішими в керуванні й можуть підходити не всім користувачам.
Ізоляція сховищ
Kubernetes пропонує кілька типів томів, які можна використовувати як постійне сховище для робочих навантажень. Для безпеки та ізоляції даних рекомендовано динамічне надання томів, а типів томів, що використовують ресурси вузла, слід уникати.
StorageClasses дозволяють описувати власні «класи» сховищ, які пропонує ваш кластер, на основі рівнів якості обслуговування, політик резервного копіювання або власних політик, визначених адміністраторами кластера.
Podʼи можуть запитувати сховище за допомогою PersistentVolumeClaim. PersistentVolumeClaim — це ресурс у межах простору імен, що дозволяє ізолювати частини системи зберігання й виділяти їх орендарям у спільному кластері Kubernetes. Однак важливо зауважити, що PersistentVolume — це ресурс на рівні кластера, життєвий цикл якого не залежить від робочих навантажень і просторів імен.
Наприклад, ви можете налаштувати окремий StorageClass для кожного орендаря й використовувати це для зміцнення ізоляції. Якщо StorageClass спільний, слід встановити політику повторного використання Delete, щоб PersistentVolume не можна було повторно використовувати в різних просторах імен.
Ізоляція контейнерів у пісочниці
Podʼи Kubernetes складаються з одного або кількох контейнерів, що виконуються на робочих вузлах. Контейнери використовують віртуалізацію на рівні ОС і тому надають слабшу межу ізоляції, ніж віртуальні машини, що використовують апаратну віртуалізацію.
У спільному середовищі невиправлені вразливості на рівні застосунків і систем можуть бути використані зловмисниками для виходу за межі контейнера й віддаленого виконання коду, що дає доступ до ресурсів хоста. У деяких застосунках, наприклад у системах керування вмістом (CMS), клієнтам може бути дозволено завантажувати й виконувати недовірені скрипти чи код. У будь-якому разі бажані механізми подальшої ізоляції та захисту робочих навантажень за допомогою сильної ізоляції.
Ізоляція в пісочниці дає змогу ізолювати робочі навантаження, що працюють у спільному кластері. Зазвичай вона передбачає запуск кожного Podʼа в окремому середовищі виконання, такому як віртуальна машина або ядро в просторі користувача. Ізоляцію в пісочниці часто рекомендують, коли ви запускаєте недовірений код, а робочі навантаження вважаються зловмисними. Частково така ізоляція потрібна тому, що контейнери — це процеси, які працюють на спільному ядрі; вони монтують файлові системи, такі як /sys і /proc, з базового хоста, що робить їх менш безпечними, ніж застосунок у віртуальній машині з власним ядром. Хоча такі засоби контролю, як seccomp, AppArmor і SELinux, можна використовувати для зміцнення безпеки контейнерів, важко застосувати універсальний набір правил до всіх робочих навантажень у спільному кластері. Запуск робочих навантажень у пісочниці допомагає захистити хост від виходу з контейнера, коли зловмисник використовує вразливість, щоб отримати доступ до системи хоста й усіх процесів і файлів на цьому хості.
Віртуальні машини та ядра в просторі користувача — два популярні підходи до ізоляції в пісочниці.
Ізоляція вузлів
Ізоляція вузлів — ще одна техніка, яку можна використовувати для ізоляції робочих навантажень орендарів одне від одного. За ізоляції вузлів набір вузлів виділяється для запуску Podʼів певного орендаря, а спільне розміщення Podʼів різних орендарів заборонено. Така конфігурація зменшує проблему шумного орендаря, оскільки всі Podʼи на вузлі належать одному орендарю. Ризик розкриття інформації дещо нижчий за ізоляції вузлів, оскільки зловмисник, якому вдасться вийти за межі контейнера, матиме доступ лише до контейнерів і томів, змонтованих на цьому вузлі.
Хоча робочі навантаження різних орендарів працюють на різних вузлах, важливо памʼятати, що kubelet і (якщо не використовуються віртуальні панелі управління) сервіс API все ще є спільними сервісами. Кваліфікований зловмисник може використати дозволи, призначені kubelet або іншим Podʼам на вузлі, щоб переміщатися кластером і отримати доступ до робочих навантажень орендарів на інших вузлах. Якщо це викликає серйозне занепокоєння, розгляньте компенсаційні засоби контролю, такі як seccomp, AppArmor або SELinux, або використання контейнерів у пісочниці чи створення окремих кластерів для кожного орендаря.
Ізоляцію вузлів дещо простіше обґрунтувати з погляду виставлення рахунків, ніж ізоляцію контейнерів у пісочниці, оскільки витрати можна розподіляти за вузлами, а не за Podʼами. Вона також має менше проблем із сумісністю та продуктивністю й може бути простішою в реалізації, ніж ізоляція контейнерів у пісочниці. Наприклад, вузли кожного орендаря можна налаштувати з taints, щоб на них могли працювати лише Podʼи з відповідною toleration. Потім змінювальний вебхук може автоматично додавати tolerations і спорідненість вузлів до Podʼів, розгорнутих у просторах імен орендарів, щоб вони працювали на певному наборі вузлів, призначених цьому орендарю.
Ізоляцію вузлів можна реалізувати за допомогою селекторів вузлів Podʼа.
Додаткові міркування
У цьому розділі розглянуто інші конструкції та шаблони Kubernetes, що стосуються багатоорендності.
API Priority and Fairness
API Priority and Fairness — це можливість Kubernetes, яка дозволяє призначати пріоритет певним Podʼам, що працюють у кластері. Коли застосунок викликає API Kubernetes, API-сервер оцінює пріоритет, призначений Podʼу. Виклики від Podʼів із вищим пріоритетом виконуються раніше за виклики з нижчим пріоритетом. За високої конкуренції виклики з нижчим пріоритетом можуть ставитися в чергу, доки сервер не звільниться, або ви можете відхиляти запити.
Використання API Priority and Fairness не дуже поширене в середовищах SaaS, якщо тільки ви не дозволяєте клієнтам запускати застосунки, що взаємодіють з API Kubernetes, наприклад контролер.
Якість обслуговування (QoS)
Коли ви запускаєте застосунок SaaS, вам може знадобитися можливість пропонувати різним орендарям різні рівні якості обслуговування (QoS). Наприклад, у вас може бути безкоштовний сервіс (freemium) з меншими гарантіями продуктивності та меншим набором можливостей і платний рівень сервісу з конкретними гарантіями продуктивності. На щастя, у Kubernetes є кілька конструкцій, які допомагають досягти цього в спільному кластері, зокрема мережевий QoS, класи сховищ, а також пріоритет і витіснення Podʼів. Ідея кожної з них полягає в тому, щоб надавати орендарям ту якість обслуговування, за яку вони заплатили. Почнімо з мережевого QoS.
Зазвичай усі Podʼи на вузлі використовують спільний мережевий інтерфейс. Без мережевого QoS деякі Podʼи можуть споживати непропорційно велику частку доступної пропускної здатності за рахунок інших Podʼів. Втулок bandwidth Kubernetes створює для мережі розширений ресурс, який дозволяє використовувати конструкції ресурсів Kubernetes, тобто запити й обмеження, щоб застосовувати обмеження швидкості до Podʼів за допомогою черг Linux tc. Зверніть увагу, що згідно з документацією про мережеві втулки цей втулок вважається експериментальним, і його слід ретельно перевірити перед використанням у промислових середовищах.
Для QoS сховища вам, імовірно, знадобиться створити різні класи сховищ або профілі з різними характеристиками продуктивності. Кожен профіль сховища можна повʼязати з окремим рівнем обслуговування, оптимізованим для різних робочих навантажень, наприклад щодо IO, резервування чи пропускної здатності. Може знадобитися додаткова логіка, щоб орендар міг повʼязати відповідний профіль сховища зі своїм робочим навантаженням.
Нарешті, є пріоритет і витіснення Podʼів, де ви можете призначати Podʼам значення пріоритету. Під час планування Podʼів планувальник намагатиметься виселити Podʼи з нижчим пріоритетом, коли бракує ресурсів для планування Podʼів із вищим пріоритетом. Якщо у вас є сценарій, де орендарі мають різні рівні обслуговування в спільному кластері, наприклад безкоштовний і платний, ви можете за допомогою цієї можливості надати вищий пріоритет певним рівням.
DNS
Кластери Kubernetes містять сервіс системи доменних імен (DNS), який перетворює імена на IP-адреси для всіх Services і Podʼів. Стандартно сервіс DNS Kubernetes дозволяє пошук у всіх просторах імен кластера.
У багатоорендних середовищах, де орендарі мають доступ до Podʼів та інших ресурсів Kubernetes, або де потрібна сильніша ізоляція, може знадобитися заборонити Podʼам шукати сервіси в інших просторах імен. Ви можете обмежити пошук DNS між просторами імен, налаштувавши правила безпеки для сервісу DNS. Наприклад, CoreDNS (стандартний сервіс DNS для Kubernetes) може використовувати метадані Kubernetes, щоб обмежувати запити Podʼами та Services у межах простору імен. Докладніше дивіться приклад такого налаштування в документації CoreDNS.
Коли використовується модель віртуальної панелі управління на орендаря, сервіс DNS слід налаштовувати для кожного орендаря окремо або використовувати багатоорендний сервіс DNS. Ось приклад зміненої версії CoreDNS, що підтримує кількох орендарів.
Оператори
Оператори — це контролери Kubernetes, які керують застосунками. Оператори можуть спростити керування кількома екземплярами застосунку, наприклад сервісу баз даних, що робить їх поширеним будівельним блоком у сценарії багатоклієнтської (SaaS) багатоорендності.
Оператори, що використовуються в багатоорендному середовищі, повинні дотримуватися суворішого набору настанов. Зокрема, Оператор повинен:
- Підтримувати створення ресурсів у різних просторах імен орендарів, а не лише в просторі імен, де розгорнуто Оператор.
- Гарантувати, що Podʼи налаштовані із запитами та обмеженнями ресурсів, щоб забезпечити планування й справедливість.
- Підтримувати налаштування Podʼів для технік ізоляції панелі даних, таких як ізоляція вузлів і контейнери в пісочниці.
Реалізації
Існує два основні способи спільного використання кластера Kubernetes для багатоорендності: за допомогою просторів імен (тобто простір імен на орендаря) або віртуалізації панелі управління (тобто віртуальна панель управління на орендаря).
В обох випадках рекомендовано також ізоляцію панелі даних і врахування додаткових міркувань, таких як API Priority and Fairness.
Ізоляція за просторами імен добре підтримується в Kubernetes, майже не потребує ресурсів і надає механізми належної взаємодії орендарів, наприклад дозволяючи взаємодію між сервісами. Однак її може бути складно налаштувати, і вона не застосовується до ресурсів Kubernetes, які не можуть належати простору імен, таких як Custom Resource Definitions, Storage Classes і Webhooks.
Віртуалізація панелі управління дозволяє ізолювати ресурси поза просторами імен ціною дещо більшого використання ресурсів і складнішого спільного використання між орендарями. Це хороший варіант, коли ізоляції за просторами імен недостатньо, але виділені кластери небажані через високу вартість їх підтримки (особливо on-prem) або через вищі накладні витрати й відсутність спільного використання ресурсів. Однак навіть у віртуалізованій панелі управління використання просторів імен, імовірно, теж дасть переваги.
Обидва варіанти докладніше описано в розділах нижче.
Простір імен на орендаря
Як уже згадувалося, варто розглянути ізоляцію кожного робочого навантаження у власному просторі імен, навіть якщо ви використовуєте виділені кластери або віртуалізовані панелі управління. Це гарантує, що кожне робоче навантаження має доступ лише до власних ресурсів, таких як ConfigMaps і Secrets, і дозволяє налаштувати окремі політики безпеки для кожного робочого навантаження. Крім того, рекомендується давати кожному простору імен назву, унікальну в межах усього вашого парку (тобто навіть якщо вони в окремих кластерах), оскільки це дає гнучкість для переходу між виділеними та спільними кластерами в майбутньому або для використання багатокластерних інструментів, таких як service mesh.
З іншого боку, є також переваги в призначенні просторів імен на рівні орендаря, а не лише робочого навантаження, оскільки часто існують політики, що застосовуються до всіх робочих навантажень одного орендаря. Однак це створює власні проблеми. По-перше, це ускладнює або унеможливлює налаштування політик для окремих робочих навантажень, а по-друге, може бути складно визначити єдиний рівень «оренди», якому слід надати простір імен. Наприклад, в організації можуть бути підрозділи, команди та підкоманди — кому з них призначити простір імен?
Один із можливих підходів — організувати простори імен в ієрархії та спільно використовувати між ними певні політики й ресурси. Це може охоплювати керування мітками просторів імен, життєвими циклами просторів імен, делегованим доступом і спільними квотами ресурсів для повʼязаних просторів імен. Ці можливості можуть бути корисними як у багатокомандних, так і в багатоклієнтських сценаріях.
Віртуальна панель управління на орендаря
Ще одна форма ізоляції панелі управління — використання розширень Kubernetes, щоб надати кожному орендарю віртуальну панель управління, яка дозволяє розділити ресурси API на рівні кластера. Разом із цією моделлю можна використовувати техніки ізоляції панелі даних для безпечного керування робочими вузлами різних орендарів.
Модель багатоорендності на основі віртуальної панелі управління розширює багатоорендність на основі просторів імен, надаючи кожному орендарю окремі компоненти панелі управління, а отже, повний контроль над ресурсами на рівні кластера й сервісами надбудов. Робочі вузли спільні для всіх орендарів і керуються кластером Kubernetes, який зазвичай недоступний орендарям. Цей кластер часто називають суперкластером (super-cluster) або іноді хост-кластером (host-cluster). Оскільки панель управління орендаря не повʼязана безпосередньо з базовими обчислювальними ресурсами, її називають віртуальною панеллю управління.
Віртуальна панель управління зазвичай складається з API-сервера Kubernetes, менеджера контролерів і сховища даних etcd. Вона взаємодіє із суперкластером через контролер синхронізації метаданих, який координує зміни між панелями управління орендарів і панеллю управління суперкластера.
Завдяки виділеним панелям управління для кожного орендаря вирішується більшість проблем ізоляції, спричинених використанням одного API-сервера всіма орендарями. Приклади таких проблем: шумні сусіди в панелі управління, неконтрольований радіус ураження від помилкових конфігурацій політик і конфлікти між обʼєктами на рівні кластера, такими як вебхуки та CRD. Отже, модель віртуальної панелі управління особливо підходить для випадків, коли кожному орендарю потрібен доступ до API-сервера Kubernetes і він очікує повної керованості кластера.
Покращена ізоляція досягається ціною запуску й підтримки окремої віртуальної панелі управління для кожного орендаря. Крім того, панелі управління для кожного орендаря не вирішують проблем ізоляції в панелі даних, таких як шумні сусіди на рівні вузла або загрози безпеці. Їх усе ще потрібно вирішувати окремо.