1.1 - Các phiên bản được hỗ trợ của tài liệu Kubernetes
Trang web này lưu tài liệu của phiên bản hiện tại và bốn phiên bản trước của Kubernetes.
2 - Bắt đầu với Kubernetes
Ở mục này chúng ta sẽ liệt kê ra những cách khác nhau để cài đặt và sử dụng Kubernetes. Khi cài đặt Kubernetes, bạn hãy lựa chọn cách thức dựa trên theo những yếu tố như: dễ dàng bảo trì, tính bảo mật, mức độ kiểm soát, tài nguyên sẵn có, cũng như trình độ chuyên môn cần thiết để vận hành và quản lý cluster.
Để triển khai (deploy) Kubernetes cluster ở máy local, trên dịch vụ điện toán đám mây (cloud) hay ở trung tâm dữ liệu của riêng bạn, hãy tải Kubernetes xuống ở đây.
Chúng tôi khuyến khích bạn thực thi components dưới dạng những container images, Kubernetes sẽ quản lý những components đó. Lưu ý, không bao gồm những components có sử dụng container (đặc biệt là kubelet).
Trong trường hợp bạn không muốn tự quản lý Kubernetes cluster, bạn có thể chọn một service quản lý, bao gồm certified platforms. Ngoài ra còn có các giải pháp tiêu chuẩn và tùy chỉnh khác trên nhiều môi trường điện toán đám mây (cloud), hay môi trường một máy chủ (bare metal environment) khác nhau.
Môi trường học tập
Nếu bạn đang ở trong giai đoạn học Kubernetes, bạn có thể sử dụng những công cụ (tools) được hỗ trợ bởi cộng đồng Kubernetes, hoặc những công cụ trong hệ sinh thái để cài đặt Kubernetes cluster trên máy của bạn. Xem thêm.
Môi trường production
Khi đánh giá một giải pháp dành cho môi trường production,
bạn cần xem xét những khía cạnh về việc vận hành Kubernetes cluster (hoặc khái niệm trừu trượng của nó) mà bạn muốn tự quản lý,
hoặc những phần nào bạn muốn để cho nhà cung cấp quản lý.
Với cluster bạn tự quản lý, công cụ hỗ trợ chính thức để triển khai (deploy) Kubernetes là kubeadm.
Một cụm Kubernetes chất lượng production yêu cầu có sự lên kế hoạch và chuẩn bị.
Nếu cụm Kubernetes của bạn dùng để chạy các workload quan trọng, nó phải được cấu hình để có khả năng phục hồi.
Trang này giải thích các bước bạn có thể thực hiện để thiết lập một cụm sẵn sàng cho production,
hoặc để thúc đẩy một cụm hiện có cho việc sử dụng production.
Nếu bạn đã quen thuộc với thiết lập production và muốn những liên kết, hãy bỏ qua đến
Tiếp theo là gì.
Những cân nhắc production
Thông thường, một môi trường cụm Kubernetes production có nhiều yêu cầu hơn một
môi trường Kubernetes cho học tập, phát triển hoặc thử nghiệm cá nhân. Một môi trường production
có thể yêu cầu truy cập an toàn bởi nhiều người dùng, tính khả dụng nhất quán, và các nguồn lực để
thích ứng với nhu cầu thay đổi.
Khi bạn quyết định nơi bạn muốn triển khai môi trường Kubernetes production
(on-premise hoặc trên cloud) và lượng công việc quản lý bạn muốn đảm nhận hoặc trao cho
người khác, hãy xem xét các yêu cầu của bạn đối với cụm Kubernetes bị ảnh hưởng như thế nào
bởi các vấn đề sau:
Tính sẵn sàng: Một môi trường học tập Kubernetes trên một máy
có một điểm lỗi duy nhất. Tạo một cụm có tính sẵn sàng cao có nghĩa là phải cân nhắc:
Tách control plane khỏi các worker node.
Nhân bản các thành phần control plane trên nhiều node.
Có đủ các worker node sẵn sàng, hoặc có khả năng trở nên khả dụng một cách nhanh chóng khi workload thay đổi.
Quy mô: Nếu bạn mong muốn môi trường Kubernetes production của mình đáp ứng được một lượng
yêu cầu ổn định, bạn có thể thiết lập khả năng đáp ứng bạn cần và hoàn thành. Tuy nhiên,
nếu bạn mong muốn đáp ứng nhu cầu tăng theo thời gian hoặc thay đổi đáng kể dựa trên những yếu tố
như mùa hoặc sự kiện đặc biệt, bạn cần lập kế hoạch về việc mở rộng quy mô để giảm bớt áp lực
tăng lên từ nhiều yêu cầu hơn đối với control plane và các worker node hoặc thu hẹp quy mô để tối ưu
tài nguyên không sử dụng.
Quản lý bảo mật và truy cập: Bạn có đầy đủ các đặc quyền admin trên cụm
Kubernetes học tập của mình. Nhưng các cụm chia sẻ với nhiều workload quan trọng, và
nhiều hơn một hoặc hai người dùng, yêu cầu một cách tiếp cận tinh tế hơn đối với những ai và
những gì có thể truy cập vào các tài nguyên cụm. Bạn có thể sử dụng kiểm soát truy cập dựa trên vai trò
(RBAC) và các kỹ thuật bảo mật khác
để chắc chắn rằng người dùng và workloads có thể truy cập được tới tài nguyên họ cần
trong khi vẫn đảm bảo bảo mật cho worload và cụm máy chủ.
Bạn có thể đặt giới hạn lên tài nguyên mà người dùng và workload có thể truy cập
bằng cách quản lý các chính sách và
tài nguyên container.
Trước khi dựng một môi trường Kubernetes production, cân nhắc
chuyển giao một phần hoặc toàn bộ công việc này cho các nhà cung cấp giải pháp Cloud
Turnkey Cloud Solutions
hoặc các đối tác Kubernetes Partners.
Các tùy chọn gồm:
Serverless: Chỉ cần chạy workload trên thiết bị của bên thứ ba mà không cần quản lý
toàn bộ cụm. Bạn sẽ bị tính phí cho những thứ như mức sử dụng CPU, bộ nhớ, và
các yêu cầu ổ đĩa.
Control plane được quản lý: Hãy để nhà cung cấp quản lý quy mô và tính sẵn sàng
của control plane trong cụm, cũng như xử lý các bản vá và cập nhật.
Worker node được quản lý: Cấu hình nhóm các node để đáp ứng nhu cầu của bạn,
sau đó nhà cung cấp sẽ đảm bảo rằng những node đó khả dụng và sẵn sàng để thực hiện
các cập nhật khi cần thiết.
Sự tích hợp: Có những nhà cung cấp tích hợp Kubernetes với các dịch vụ khác
mà bạn có thể cần, ví dụ kho lưu trữ, container registries, các phương thức xác thực,
và những công cụ phát triển.
Liệu bạn tự dựng một cụm Kubernetes production hay làm điều đó với
các đối tác, xem những phần dưới đây để đánh giá nhu cầu liên quan tới
control plane, các worker node, truy cập người dùng, và
các tài nguyên workload cho cụm của bạn.
Thiết lập cụm production
Trong một cụm Kubernetes có chất lượng production, control plane quản lý
cụm từ các dịch vụ có thể được trải đều trên nhiều máy tính
theo những cách khác nhau. Tuy nhiên, mỗi worker node đại diện cho một thực thể duy nhất
được cấu hình để chạy Kubernetes pod.
Control plane trên production
Cụm Kubernetes đơn giản nhất có toàn bộ dịch vụ control plane và worker node
chạy trên cùng một máy. Bạn có thể phát triển môi trường đó bằng cách thêm
các worker node, như được phản ánh trong sơ đồ được minh họa trong
Các thành phần Kubernetes.
Nếu cụm có nghĩa là có sẵn trong một khoảng thời gian ngắn hoặc có thể
bị loại bỏ nếu có sự cố nghiêm trọng, điều này có thể đáp ứng nhu cầu của bạn.
Tuy nhiên, nếu bạn cần một cụm vĩnh viễn, có mức độ sẵn cao hơn, bạn nên
xem xét các cách mở rộng control plane. Theo thiết kế, dịch vụ control plane
chạy trên một máy tính đơn là không có tính sẵn sàng cao.
Nếu việc giữ cụm được dựng lên và chạy
và đảm bảo rằng nó có thể được sửa chữa nếu có sự cố xảy ra là điều quan trọng,
Xem xét các bước sau:
Chọn các công cụ triển khai: Bạn có thể triển khai một control plane bằng các công cụ
vi dụ như kubeadm, kops, và kubespray. Xem
Cài đặt Kubernetes với những công cụ triển khai
để tìm hiểu các mẹo triển khai chất lượng production bằng cách sử dụng từng phương pháp
triển khai đó. Những Container Runtimes
khác cũng có sẵn để bạn sử dụng cho việc triển khai của mình.
Quản lý chứng chỉ: Giao tiếp bảo mật giữa các dịch vụ control plane
được thực hiện bằng chứng chỉ. Chứng chỉ được tự động tạo trong quá trình triển khai
hoặc bạn có thể tạo chúng bằng cách sử dụng cơ quan cấp chứng chỉ của riêng bạn.
Xem Chứng chỉ PKI và yêu cầu để biết thêm chi tiết.
Cấu hình bộ cân bằng tải cho apiserver: Cấu hình bộ cân bằng tải
để phân phối các request API bên ngoài tới các instance của dịch vụ apiserver chạy trên các node khác nhau. Xem
Tạo Bộ Cân bằng tải bên ngoài
để biết thêm chi tiết.
Phân tách và sao lưu dịch vụ etcd: Các dịch vụ etcd có thể chạy trên
cùng các máy với các dịch vụ control plane khác hoặc chạy trên các máy tách biệt, để
tăng tính bảo mật và khả dụng. Bởi vì etcd lưu dữ liệu cấu hình của cụm,
sao lưu cơ sở dữ liệu etcd nên được thực hiện thường xuyên để đảm bảo rằng bạn có thể
sửa chữa cơ sở dữ liệu đó nếu cần.
Xem thêm etcd FAQ để biết thêm chi tiết về việc cấu hình và sử dụng etcd.
Xem Vận hành các cụm etcd cho Kubernetes
và Thiết lập một cụm etcd có tính Sẵn sàng cao với kubeadm
để biết thêm chi tiết.
Tạo nhiều hệ thống control plane: Để có tính sẵn sàng cao,
control plane không nên giới hạn trong một máy. Nếu các dịch vụ control plane
được chạy bởi một dịch vụ khởi tạo (ví dụ systemd), các dịch vụ nên chạy trên
ít nhất ba máy. Tuy nhiên, chạy các dịch vụ control plane dạng pods trong
Kubernetes đảm bảo rằng số lượng bản sao dịch vụ mà bạn yêu cầu
sẽ luôn có sẵn.
Scheduler phải có khả năng chịu lỗi,
nhưng không sẵn sàng cao. Một số công cụ triển khai được thiết lập thuật toán đồng thuận
Raft để bầu cử leader cho các dịch vụ Kubernetes. Nếu
nếu leader biến mất, một dịch vụ khác tự bầu cử chính nó và tiếp quản.
Trải rộng nhiều zone: Nếu việc duy trì cụm khả dụng mọi lúc là quan trọng,
cân nhắc việc tạo một cụm chạy trên nhiều trung tâm dữ liệu,
được gọi là zone trên các môi trường đám mây. Nhóm các zone gọi là region.
Bằng cách trải rộng một cụm trên nhiều zone trong cùng một region,
nó có thể làm tăng cơ hội cho cụm của bạn được tiếp tục hoạt động ngay cả khi
một zone trở nên không khả dụng.
Xem Chạy trong nhiều zone để biết thêm chi tiết.
Quản lý các tính năng on-going: Nếu bạn có kế hoạch giữ cụm theo thời gian,
có những nhiệm vụ bạn cần làm để duy trì sức khỏe và bảo mật của cụm. Ví dụ,
nếu bạn đã cài đặt với kubeadm, có các hướng dẫn để giúp bạn
Quản lý Chứng chỉ
và Nâng cấp các cụm kubeadm.
Xem Quản lý một cụm
để biết thêm danh sách các tác vụ quản trị của Kubernetes.
Workload chất lượng production cần phải có tính đàn hồi và bất kỳ thành phần nào mà chúng phụ thuộc vào cũng phải có tính đàn hồi
(ví dụ CoreDNS). Cho dù bạn tự quản lý control plane hay có một nhà cung cấp cloud làm điều đó cho bạn, bạn vẫn cần phải xem xét
cách bạn muốn quản lý các worker node (còn gọi một cách đơn giản là node).
Cấu hình các node: Các node có thể là máy vật lý hay máy ảo. Nếu bạn muốn tạo
và quản lý node của riêng bạn, bạn có thể cài đặt một hệ điều hành được hỗ trợ,
sau đó thêm và chạy các dịch vụ Node thích hợp. Xem xét:
Nhu cầu của workload khi bạn thiết lập các node bằng cách có sẵn bộ nhớ, CPU và tốc độ đĩa và dung lượng lưu trữ phù hợp.
Liệu các hệ thống máy tính chung sẽ làm hay bạn có workload cần bộ xử lý GPU, node Windows hoặc VM cô lập.
Xác nhận các node: Xem Thiết lập node hợp lệ
để biết thông tin về cách đảm bảo một node đáp ứng các yêu cầu để tham gia cụm Kubernetes.
Thêm các node vào cụm: Nếu bạn đang quản lý cụm của riêng mình, bạn có thể
thêm các node bằng cách thiết lập các máy của riêng bạn và thêm chúng theo cách thủ công hoặc
để chúng tự đăng ký với apiserver của cụm. Xem phần Nodes
để biết thông tin về cách thiết lập Kubernetes để thêm các nút theo những cách này.
Quy mô các node: Sau cùng bạn sẽ cần có một kế hoạch để mở rộng khả năng của cụm.
Xem Các cân nhắc cho những cụm lớn để giúp xác định bạn cần bao nhiêu node,
dựa trên số lượng pod và container bạn cần chạy. Nếu bạn đang tự quản lý các node,
điều này có thể có nghĩa là mua và cài đặt thiết bị vật lý của riêng bạn.
Autoscale các node: Đọc
Node Autoscaling để tìm hiểu về
các công cụ có sẵn để tự động quản lý các node của bạn và khả năng chúng cung cấp.
Thiết lập kiểm tra sức khỏe node: Đối với những workload quan trọng, bạn muốn đảm bảo rằng
các node và các pod chạy trên các node đó là khỏe mạnh. Sử dụng
Trình phát hiện vấn đề node,
bạn có thể đảm bảo các node của bạn khỏe mạnh.
Quản lý người dùng trên production
Trên production, bạn có thể chuyển từ một mô hình nơi bạn hoặc một nhóm nhỏ
những người đang truy cập cụm đến nơi có khả năng có hàng tá hoặc
hàng trăm người. Trong môi trường học tập hoặc nền tảng nguyên mẫu, bạn có thể có một
tài khoản quản trị cho mọi thứ bạn làm. Trên production, bạn sẽ muốn
nhiều tài khoản với các cấp độ truy cập khác nhau vào các namespace khác nhau.
Đảm nhận một cụm có chất lượng production nghĩa là quyết định việc bạn muốn làm thế nào
để cho phép người dùng khác truy cập một cách chọn lọc. Đặc biệt, bạn cần
chọn chiến lược để xác minh danh tính những người đang cố truy cập vào cụm của bạn
(xác thực) và quyết định liệu họ có quyền làm những gì họ muốn (phân quyền):
Xác thực: Apiserver có thể xác thực người dùng bằng chứng chỉ khác, bearer tokens,
một proxy xác thực, hoặc HTTP basic auth.
Bạn có thể chọn phương pháp xác thực bạn muốn. Băng việc sử dụng plugin, apiserver có thể
tận dụng phương thức xác thực hiện có của tổ chức của bạn, ví dụ LDAP hoặc Kerberos. Xem
Xác thực
dể biết mô tả về các phương pháp xác thực người dùng Kubernetes khác nhau.
Phân quyền: Khi bạn bắt đầu ủy quyền cho người dùng thường xuyên của mình, bạn có lẽ
sẽ chọn giữa phân quyền RBAC và ABAC.
Xem Tổng quan phân quyền
để xem những chế độ phân quyền tài khoản người dùng khác nhau (cũng như quyền truy cập của
service account tới cụm của bạn):
Kiểm soát truy cập dựa trên vai trò (RBAC): Cho phép
bạn chỉ định quyền truy cập vào cụm bằng cách cho phép thiết lập một tập các quyền tới
người dùng đã xác thực.
Quyền có thể được chỉ định trong một namespace cụ thể (Role) hoặc trong cả cụm (ClusterRole). Sau đó sử dụng RoleBindings và ClusterRoleBindings, những quyền này có thể
được gán tới những người dùng cụ thể.
Kiểm soát truy cập dựa trên thuộc tính (ABAC): Cho phép bạn
tạo các chính sách dựa trên thuộc tính của tài nguyên trong cụm và sẽ cho phép hoặc
hoặc từ chối truy cập dựa trên những thuộc tính đó. Mỗi dòng trong 1 file chính sách
xác định phiên bản của thuộc tính (apiVersion and kind) và một ánh xạ các thuộc tính
đặc trưng để gán tới một chủ thể (người dùng hoặc nhóm), thuộc tính tài nguyên, thuộc tính
phi tài nguyên (/versions hoặc /apis), và chỉ đọc. Xem
Các ví dụ để biết thêm chi tiết
Với tư cách là người thiết lập xác thực và phân quyền trên cụm Kubernetes production,
dưới đây là một số điều cần cân nhắc:
Đặt chế độ phân quyền: Khi Kubernetes API server
(kube-apiserver)
khởi động, chế độ hỗ trợ phân quyền phải được thiết lập bằng cờ --authorization-config
file hoặc --authorization-mode. Ví dụ, cờ đó trong kube-adminserver.yaml file
(tại /etc/kubernetes/manifests) có thể được đặt là Node,RBAC. Điều này sẽ cho phép
phân quyền Node và RBAC tới những yêu cầu đã xác thực.
Tạo chứng chỉ người dùng và role bindings (RBAC): Nếu bạn sử dụng phân quyền RBAC,
người dùng có thể tạo một CertificateSigningRequest (CSR) và sẽ được ký bởi CA của cụm.
Sau đó bạn có thể gán Roles và ClusterRoles tới từng người dùng.
Xem Certificate Signing Requests để biết thêm chi tiết.
Tạo các chính sách kết hợp các thuộc tính (ABAC): Nếu bạn sử dụng phân quyền ABAC,
bạn có thể gán sự kết hợp các thuộc tính thành các chính sách để phân quyền tới
người dùng hoặc nhóm được chọn để họ có thể truy cập tới những tài nguyên cụ thể
(ví dụ pod), namespace, hoặc apiGroup. Để biết thêm thông tin, xem
Các ví dụ.
Cân nhắc Admission Controllers: Các hình thức phân quyền bổ sung cho các yêu cầu
đến thông qua API server bao gồm
Webhook Token Authentication.
Webhooks và những loại phân quyền đặc biệt khác cần được kích hoạt bằng cách thêm
Admission Controllers
vào API server.
Đặt giới hạn tài nguyên cho workload
Những yêu cầu từ production workload có thể gây ra áp lực lên cả trong và ngoài
Kubernetes control plane. Hãy cân nhắc những mục này khi thiết lập cho
nhu cầu của workload trong cụm của bạn:
Chuẩn bị cho yêu cầu DNS: Nếu bạn mong đợi workloads mở rộng một cách ồ ạt,
dịch vụ DNS của bạn phải săn sàng để mở rộng quy mô. Xem
Autoscale dịch vụ DNS trong cụm.
Tạo thêm các service account: Tài khoản người dùng (user account) xác định những gì
người dùng có thể thực hiện trên một cụm, trong khi đó một tài khoản dịch vụ (service account)
định nghĩa khả năng truy cập của pod trong một namespace cụ thể. Mặc định, một pod sẽ
tiếp nhận service account default từ namespace của nó.
Xem Quản lý Service Account
để biết cách tạo một service account. Ví dụ, bạn có thể muốn:
Nếu bạn chọn dựng cụm cho riêng bạn, lập kế hoạch về việc xử lý
các chứng chỉ
và thiết lập tính sẵn sàng cao cho các thành phần, ví dụ
etcd
và
API server.
Lưu ý: Dockershim đã được loại bỏ khỏi dự án Kubernetes kể từ phiên bản 1.24. Đọc Dockershim Removal FAQ để biết thêm chi tiết.
Bạn cần cài đặt một
container runtime
vào mỗi node trong cluster để chạy Pod trên đó. Trang này mô tả những gì liên quan và các bước liên quan để thiết lập node.
Nếu bạn đang chạy một phiên bản Kubernetes khác với v1.37, hãy xem tài liệu của phiên bản đó.
Điều kiện tiên quyết của Cài đặt và cấu hình
Cấu hình mạng lưới
Trông khi tình hình mặc định, Linux kernel không cho phép các gói mạng IPv4 được chuyển đi giữa các giao diện. Hầu hết các tính năng mạng Kubernetes sẽ thay đổi cài đặt này (nếu cần thiết), nhưng một số có thể mong đợi rằng người quản trị sẽ làm cho nó. (Một số có thể cũng mong đợi các tham số sysctl khác được thiết lập, các module kernel được tải, v.v; hãy xem tài liệu cho từng tính năng mạng cụ thể của bạn.)
Bật chuyển tiếp gói mạng IPv4
Để bật chuyển tiếp gói mạng IPv4:
# sysctl params required by setup, params persist across rebootscat <<EOF | sudo tee /etc/sysctl.d/k8s.conf
net.ipv4.ip_forward = 1
EOF# Apply sysctl params without rebootsudo sysctl --system
Kiểm tra rằng net.ipv4.ip_forward đã được thiết lập thành 1 bằng cách:
sysctl net.ipv4.ip_forward
cgroup drivers
Linux sử dụng các control groups để giới hạn các tài nguyên được cấp phát cho các quy trình.
Cả kubelet và container runtime xuống nó cần giao tiếp với control groups để áp dụng quản lý tài nguyên cho pods và containers
và thiết lập tài nguyên như cpu/memory requests và limits. Để giao tiếp với control groups, kubelet và container runtime cần sử dụng một cgroup drivers.
Điều quan trọng là kubelet và container runtime phải sử dụng cùng một cgroup driver và cấu hình.
cgroupfs driver là cgroup driver mặc định trong kubelet.
Khi sử dụng cgroupfs driver, kubelet và container runtime giao tiếp trực tiếp với cgroup filesystem để cấu hình cgroups.
Khi systemd là hệ thống khởi tạo, cgroupfs driver không được khuyến nghị vì systemd mong đợi một cgroup manager duy nhất trên hệ thống. Bổ sung nữa, nếu bạn sử dụng cgroup v2, hãy sử dụng systemd cgroup driver thay vì cgroupfs.
systemd cgroup driver
Khi systemd được chọn làm hệ thống khởi tạo cho một phân phối Linux, quy trình khởi tạo sẽ tạo và tiêu thụ một control group gốc (cgroup) và trở thành cgroup manager.
Sự tích hợp của systemd và cgroups rất chặt chẽ. Mỗi cái systemd unit sẽ được cấp cho một cgroup. Vì vậy, nếu bạn sử dụng systemd làm hệ thống khởi tạo với cgroupfs driver, hệ thống sẽ có hai cgroup managers khác nhau.
Hai cgroup managers sẽ dẫn đến hai cái nhìn khác nhau về các tài nguyên có sẵn và đang được sử dụng trong hệ thống. Trong một số trường hợp, các node được cấu hình sử dụng cgroupfs cho kubelet và container runtime, nhưng sử dụng systemd cho các quy trình còn lại sẽ trở nên không ổn định trong trường hợp nặng tài nguyên.
Cách để giảm thiểu tình hình không ổn định là sử dụng systemd làm cgroup driver cho kubelet và container runtime khi systemd được chọn làm hệ thống khởi tạo.
Để thiết lập systemd làm cgroup driver, chỉnh sửa cấu hình KubeletConfiguration
của cgroupDriver và đặt nó thành systemd. Ví dụ:
Từ v1.22 trở đi, khi tạo một cluster với kubeadm, nếu bạn không thiết lập cgroupDriver trong KubeletConfiguration, kubeadm sẽ mặc định nó thành systemd.
Nếu bạn cấu hình systemd làm cgroup driver cho kubelet, bạn cũng phải cấu hình systemd làm cgroup driver cho container runtime. Hãy xem tài liệu của container runtime để biết hướng dẫn. Ví dụ:
Kubernetes được bật KubeletCgroupDriverFromCRIfeature gate và một container runtime dùng được RuntimeConfig CRI RPC, kubelet sẽ tự động phát hiện được cgroup driver phù hợp từ runtime, và bỏ qua cài đặt cgroupDriver trong kubelet cấu hình.
Tuy nhiên, các phiên bản cũ hơn của container runtimes (đạc biệt là containerd 1.y và dưới) không dùng dược RuntimeConfig CRI RPC, và có thể không phản hồi chính xác đến yêu cầu này. Do đó kubelet sẽ sử dụng tham số --cgroup-driver của riêng nó.
Trong Kubernetes 1.36, hành vi này sẽ bị loại bỏ, và các containerd phiên bản cũ sẽ bị lỗi với các kubelet mới hơn.
Chú ý:
Thay đổi cgroup driver của một Node đã tham gia một cluster là một hoạt động quan trọng. Nếu kubelet đã tạo các Pod bằng cách sử dụng các khái niệm của một cgroup driver, thay đổi container runtime sang một cgroup driver khác có thể dẫn đến lỗi khi cố gắng tạo lại sandbox của Pod cho các Pod đó. Khởi động lại kubelet không giải quyết được các lỗi này.
Nếu bạn có một hệ thống tự động, thay thế node bằng một node mới bằng cấu hình đã cập nhật, hoặc cài đặt lại node bằng cách sử dụng hệ thống tự động.
Chuyển sang cgroup driver systemd trong các cluster được quản lý bởi kubeadm
Nếu bạn muốn chuyển sang cgroup driver systemd trong các cluster được quản lý bởi kubeadm, hãy theo cấu hình một cgroup driver.
Các CRI phiên bản #{cri-versions}
Container runtime của bạn phải tương thích với ít nhất v1alpha2 của container runtime interface.
Kubernetes bắt đầu từ v1.26chỉ tác dụng với CRI API phiên bản v1. Nhưng nếu một container runtime không tác dụng với CRI API phiên bản v1, kubelet sẽ sử dụng (đã bị loại bỏ) CRI API phiên bản v1alpha2 thay vì đó.
Container runtimes
Lưu ý: Phần này liên kết đến các dự án bên thứ ba cung cấp chức năng được yêu cầu bởi Kubernetes. Tác giả dự án Kubernetes không chịu trách nhiệm về những dự án này, được liệt kê theo thứ tự chữ cái. Để thêm một dự án vào danh sách này, đọc hướng dẫn nội dung trước khi gửi thay đổi. Thêm thông tin.
containerd
Phần này mô tả các bước cần thiết để sử dụng containerd làm CRI runtime.
Để cài đặt containerd trên hệ thống của bạn, hãy theo các hướng dẫn trên bắt đầu với containerd. Trở lại bước này khi bạn đã tạo một file cấu hình config.toml hợp lệ.
Tìm được file này ở đường dẫn /etc/containerd/config.toml.
Tìm được file này ở đường dẫn C:\Program Files\containerd\config.toml.
Trên Linux, CRI socket mặc định của containerd là /run/containerd/containerd.sock.
Trên Windows, CRI endpoint mặc định là npipe://./pipe/containerd-containerd.
Configuring the systemd cgroup driver
Để sử dụng systemd cgroup driver trong /etc/containerd/config.toml với runc, thiết lập cấu hình do phiên bản của bạn.
systemd cgroup driver là khuyến nghị nếu bạn sử dụng cgroup v2
Lưu ý:
Nếu bạn cài đặt containerd tử một package (ví sự, RPM hoạc .deb), bạn có thể phát hiện rằng plugin CRI tích hợp đã bị tắt mặc định.
Bạn cần phải có hỗ trợ CRI để sử dụng containerd với Kubernetes. Hãy đảm bảo rằng cri không nằm trong danh sách disabled_plugins trong /etc/containerd/config.toml; nếu bạn đã thay đổi file này, hãy khởi động lại containerd.
Nếu bạn gặp container lặp tuần hoàn sau cài đặt cluster ban đầu hoặc sau khi cài đặt CNI, hãy cân nhắc việc thiết lập lại cấu hình containerdcontainerd config default > /etc/containerd/config.toml as specified in
getting-started.md
Nếu bạn áp dụng thay đổi này, hãy đảm bảo khởi động lại containerd:
CRI-O sử dụng systemd cgroup driver mặc định, điều này hầu hết có hiệu quả. Để chuyển sang cgroup driver cgroupfs, chỉnh sửa /etc/crio/crio.conf hoặc đặt một drop-in configuration trong /etc/crio/crio.conf.d/02-cgroup-manager.conf, ví dụ:
Lưu ý cấu hình conmon_cgroup phải được thiết lập thành pod. Điều này thường cần thiết để đảm bảo cgroup driver của kubelet (thường được thực hiện bằng kubeadm) và CRI-O được đồng bộ.
Trong Kubernetes v1.28, bạn có thể bật tính năng alpha tự động phát hiện cgroup driver như một tính năng. Xem thêm chi tiết tại systemd cgroup driver.
CRI socket của CRI-O mặc định là /var/run/crio/crio.sock.
Thay đổi image sandbox (pause)
Bạn có thể thiết lập cấu hình sau trong CRI-O config
Cluster API: Một dự án con Kubernetes tập trung vào
việc cung cấp API và công cụ khai báo để đơn giản hóa việc cung cấp, nâng cấp và
vận hành nhiều cụm Kubernetes.
kops: Một công cụ cung cấp cụm tự động.
Đối với các hướng dẫn, thực hành tốt nhất, tùy chọn cấu hình và thông tin về
tiếp cận với cộng đồng, vui lòng kiểm tra
kOps website để biết chi tiết.
kubespray:
Một sự phối hợp của Ansible playbooks,
inventory,
các công cụ cung cấp, và kiến thức chuyên môn cho các tác vụ quản lý cấu hình
Hệ điều hành/cụm Kubernetes chung. Bạn có thể tiếp cận tới cộng đồng trên kênh Slack
#kubespray.
2.2.2.1 - Khởi tạo cụm với kubeadm
2.2.2.1.1 - Cài đặt kubeadm
Trang này hướng dẫn cách cài đặt hộp công cụ kubeadm.
Để biết thông tin về cách tạo một cụm với Kubeadm sau khi bạn đã thực hiện quy trình cài đặt này,
xem trang Tạo một cụm với kubeadm.
Trang installation guide này dành cho Kubernetes v1.37. Nếu bạn muốn sử dụng phiên bản Kubernetes khác, vui lòng tham khảo các trang sau đây thay vì:
Một máy chủ Linux tương thích. Dự án Kubernetes cung cấp những hướng dẫn chung cho các bản phân phối Linux
dựa trên Debian và Red Hat, và những bản phân phối không có trình quản lý gói.
2 GB RAM hoặc nhiều hơn cho mỗi máy (nếu ít hơn sẽ không đủ tài nguyên cho các ứng dụng của bạn).
2 CPU hoặc nhiều hơn cho các máy control plane.
Kết nối toàn mạng giữa tất cả các máy trong cụm (mạng public hoặc private đều được).
Mọi máy phải có hostname, địa chỉ MAC, và product_uuid duy nhất. Xem tại đây để biết thêm chi tiết.
Một số cổng được mở trên máy của bạn. Xem tại đây để biết thêm chi tiết.
Lưu ý:
Việc cài đặt kubeadm có thể được thực hiện thông qua các tệp nhị phân sử dụng liên kết động và giả sử hệ thống của bạn cung cấp glibc.
Giả định này hợp lý trên nhiều bản phân phối Linux (bao gồm Debian, Ubuntu, Fedora, CentOS, v.v...)
nhưng không phải luôn đúng đối với các bản phân phối nhẹ và tùy biến bởi mặc định chúng không có sẵn glibc, ví dụ Alpine Linux.
Kỳ vọng là bản phân phối hoặc bao gồm glibc hoặc có một
lớp tương thích
cung cấp các đặc trưng mong muốn.
Kiểm tra phiên bản OS
Lưu ý: Phần này liên kết đến các dự án bên thứ ba cung cấp chức năng được yêu cầu bởi Kubernetes. Tác giả dự án Kubernetes không chịu trách nhiệm về những dự án này, được liệt kê theo thứ tự chữ cái. Để thêm một dự án vào danh sách này, đọc hướng dẫn nội dung trước khi gửi thay đổi. Thêm thông tin.
Một cụm Kubernetes được tạo bởi kubeadm phụ thuộc vào phần mềm mà chúng sử dụng các chức năng kernel.
Phần mềm này bao gồm, nhưng không giới hạn ở
container runtime,
kubelet, và một plugin Container Network Interface.
Để giúp bạn tránh những lỗi không mong muốn khi sử dụng một phiên bản kernel không được hỗ trợ, kubeadm chạy kiểm tra pre-flight
SystemVerification. Quá trình kiểm tra này sẽ lỗi nếu phiên bản kernel không được hỗ trợ.
Bạn có thể chọn bỏ qua kiểm tra, nếu bạn biết rằng kernel của bạn
cung cấp các chức năng cần thiết, kể cả kubeadm không hỗ trợ phiên bản đó.
Xác nhận địa chỉ MAC và product_uuid là duy nhất cho từng node
Bạn có thể biết được địa chỉ MAC của network interfaces bằng câu lệnh ip link hoặc ifconfig -a
product_uuid có thể kiểm tra bằng câu lệnh sudo cat /sys/class/dmi/id/product_uuid
Rất có thể các thiết bị phần cứng sẽ có các địa chỉ duy nhất, mặc dù một vài máy ảo có thể có
các giá trị giống hệt nhau. Kubernetes sử dụng những giá trị đó để định danh duy nhất cho các node trong cụm.
Nếu các giá trị đó không là duy nhất cho từng node, quá trình cái đặt
có thể thất bại.
Kiểm tra network adapter
Nếu bạn có nhiều hơn một network adapter, và các thành phần Kubernetes của bạn không thể truy cập trên route
mặc định, chúng tôi khuyên bạn nên bổ sung (các) IP route để các địa chỉ cụm Kubernetes đi qua adpater thích hợp.
Kiểm tra các cổng cần thiết
Những cổng cần thiết
cần phải được mở để các thành phần Kubernetes giao tiếp với nhau.
Bạn có thể sử dụng công cụ như netcat để kiểm tra cổng có được mở hay không. Ví dụ:
nc 127.0.0.1 6443 -zv -w 2
Pod network plugin mà bạn sử dụng cũng có thể yêu cầu mở một số cổng nhất định.
Vì điều này khác nhau đối với từng pod network plugin, vui lòng xem
tài liệu của các plugin về (các) cổng cần thiết.
Cấu hình swap
Mặc định kubelet sẽ không thể khởi động nếu bộ nhớ swap được phát hiện trên một node.
Điều này có nghĩa rằng swap nên hoặc là tắt đi hoặc là được chấp nhận bởi kubelet.
Để chấp nhận swap, thêm failSwapOn: false vào cấu hình kubelet hoặc thông qua tham số dòng lệnh.
Lưu ý: thậm chí nếu failSwapOn: false được thêm, workload mặc định cũng không có quyền truy cập swap.
Điều này có thể được thay đổi bằng cách đặt swapBehavior, một lần nữa trong file cấu hình kubelet. Để sử dụng swap,
đặt một swapBehavior khác với giá trị mặc định NoSwap.
Xem Quản lý bộ nhớ swap để biết thêm chi tiết.
Để tắt swap, sudo swapoff -a có thể được sử dụng để tắt tạm thời.
Để làm cho thay đổi này duy trì mỗi khi tái khởi động, đảm bảo rằng swap được tắt trong
các file cấu hình như /etc/fstab, systemd.swap, phụ thuộc vào việc nó được cấu hình như thế nào trên hệ thống của bạn.
Cài đặt một container runtime
Để chạy các container trong các Pod, Kubernetes sử dụng một
container runtime.
Mặc định, Kubernetes sử dụng
Container Runtime Interface (CRI)
để giao tiếp với container runtime mà bạn chọn.
Nếu bạn không chỉ định một runtime, kubeadm tự động phát hiện một container runtime
đã cài đặt bằng cách quét qua một danh sách những endpoint đã biết.
Nếu có nhiều hoặc không có container runtime nào được phát hiện, kubeadm sẽ ném ra một lỗi
và sẽ yêu cầu bạn chỉ định một thứ bạn muốn sử dụng.
Docker Engine không triển khai CRI,
một thứ bắt buộc của container runtime để hoạt động với Kubernetes.
Vì lí do đó, một dịch vụ bổ sung cri-dockerd
phải được cài đặt. cri-dockerd là một dự án dựa trên sự hỗ trợ legacy built-in của
Docker Engine mà đã bị loại bỏ khỏi kubelet trong phiên bản 1.24.
Những bản bên dưới bao gồm những endpoint đã biết của những hệ điều hành được hỗ trợ:
Linux container runtimes
Runtime
Đường dẫn tới Unix domain socket
containerd
unix:///var/run/containerd/containerd.sock
CRI-O
unix:///var/run/crio/crio.sock
Docker Engine (using cri-dockerd)
unix:///var/run/cri-dockerd.sock
Windows container runtimes
Runtime
Đường dẫn tới Windows named pipe
containerd
npipe:////./pipe/containerd-containerd
Docker Engine (using cri-dockerd)
npipe:////./pipe/cri-dockerd
Cài đặt kubeadm, kubelet và kubectl
Bạn sẽ cài đặt các package này trên toàn bộ máy chủ của bạn:
kubeadm: lệnh khởi tạo cụm.
kubelet: thành phần chạy trên toàn bộ các máy trong cụm của bạn
và làm những việc như khởi chạy pod và container.
kubectl: tiện ích dòng lệnh để giao tiếp với cụm.
kubeadm sẽ không cài đặt hoặc quản lý kubelet và kubectl cho bạn, vì vậy bạn sẽ
cần phải đảm bảo rằng phiên bản của chúng giống với Kubernetes control plane bạn muốn
kubeadm cài cho bạn. Nếu bạn không làm vậu, rủi ro về sự chênh lệch phiên bản có thể xảy ra và
dẫn tới những hành vi lỗi, không mong muốn. Tuy nhiên, chênh lệch một phiên bản minor giữa
kubelet và control plane được chấp nhận, nhưng phiên bản kubelet không bao giờ vượt quá phiên bản API
server. Ví dụ, kubelet đang chạy 1.7.0 có thể tương thích hoàn toàn với API server phiên bản 1.8.0,
nhưng không có chiều ngược lại.
Những hướng dẫn này loại trừ tất cả các package của Kubernetes khỏi mọi sự nâng cấp hệ thống.
Bởi vì kubeadm và Kubernetes yêu cầu
đặc biệt chú ý khi nâng cấp.
Để biết thêm thông tin về chênh lệch phiên bản, xem:
Lưu ý: Các kho lưu trữ gói cũ (apt.kubernetes.io và yum.kubernetes.io) đã bị
lỗi thời và đóng băng từ ngày 13 tháng 9, 2023.
Sử dụng các kho lưu trữ mới được đặt tại pkgs.k8s.io
được khuyến nghị mạnh mẽ và yêu cầu để cài đặt các phiên bản Kubernetes phát hành sau ngày 13 tháng 9, 2023.
Các kho cũ đã lỗi thời, và nội dung của chúng, có thể bị xóa bất kỳ lúc nào trong tương lai và mà không có
thêm thông báo. Các kho lưu trữ mới cung cấp tải về cho các phiên bản Kubernetes bắt đầu từ v1.24.0.
Lưu ý:
Có một kho lưu trữ package chuyên dụng cho từng phiên bản minor của Kubernetes. Nếu bạn muốn cài đặt
một phiên bản minor khác v1.37, vui lòng xem hướng dẫn cài đặt cho
phiên bản minior bạn mong muốn.
Hướng dẫn này dành cho Kubernetes v1.37.
Cập nhật apt package index và cài đặt các package cần thiết để sử dụng kho lưu trữ apt của Kubernetes:
sudo apt-get update
# apt-transport-https có thể là một package giả; nếu vậy, bạn có thể bỏ qua package nàysudo apt-get install -y apt-transport-https ca-certificates curl gpg
Tải xuống khóa ký công khai cho các kho lưu trữ package của Kubernetes.
Toàn bộ các kho lưu trữ sử dụng chung khóa ký do vậy bạn có thể không cần quan tâm tới phiên bản trong URL:
# Nếu thư mục `/etc/apt/keyrings` không tồn tại, nó nên được tạo trước lệnh curl, đọc chú thích bên dưới.# sudo mkdir -p -m 755 /etc/apt/keyringscurl -fsSL https://pkgs.k8s.io/core:/stable:/v1.37/deb/Release.key | sudo gpg --dearmor -o /etc/apt/keyrings/kubernetes-apt-keyring.gpg
Lưu ý:
Trong những bản phát hành cũ hơn Debian 12 và Ubuntu 22.04, thư mục /etc/apt/keyrings mặc định không
tồn tại, và nó nên được tạo trước lệnh curl.
Thêm kho lưu trữ apt Kubernetes thích hợp. Vui lòng chú ý rằng kho lưu trữ này chỉ chứa những package
cho Kubernetes 1.37; đối với các phiên bản Kubernetes minor khác, bạn cần phải
thay đổi phiên bản Kubernetes minor trong URL để trùng với phiên bản minor bạn mong muốn
(bạn cũng nên kiểm tra lại rằng bạn đang đọc tài liệu cho phiên bản Kubernetes
mà bạn dự định cài đặt).
# Điều này sẽ ghi đè bất kỳ những cấu hình nào đang có trong /etc/apt/sources.list.d/kubernetes.listecho'deb [signed-by=/etc/apt/keyrings/kubernetes-apt-keyring.gpg] https://pkgs.k8s.io/core:/stable:/v1.37/deb/ /'| sudo tee /etc/apt/sources.list.d/kubernetes.list
Cập nhật apt package index, cài đặt kubelet, kubeadm và kubectl, và ghim lại phiên bản của chúng:
(Tùy chọn) Bật dịch vụ kubelet trước khi chạy kubeadm:
sudo systemctl enable --now kubelet
Đặt SELinux thành chế độ permissive:
Những hướng dẫn này dành cho Kubernetes 1.37.
# Đặt SELinux trong chế độ permissive (vô hiệu hóa nó một cách hiệu quả)sudo setenforce 0sudo sed -i 's/^SELINUX=enforcing$/SELINUX=permissive/' /etc/selinux/config
Chú ý:
Đặt SELinux trong chế độ permissive bằng cách chạy setenforce 0 và sed ...
vô hiệu hóa nó một cách hiệu quả. Điều này là bắt buộc để cho phép các container truy cập vào hệ thống file
của máy chủ; ví dụ, một vài network plugin của cụm yêu cầu điều này. Bạn phải
làm điều này cho đến khi sự hỗ trợ SELinux được cải thiện trong kubelet.
Bạn có thể để SELinux bật nếu bạn biết cách cấu hình nó nhưng điều đó có thể yêu cầu
các thiết lập không được hỗ trợ bởi kubeadm.
Thêm kho lưu trữ yum của Kubernetes. Tham số exclude trong
định nghĩa kho lưu trữ đảm bảo rằng các package liên quan tới Kubernetes
không được nâng cấp bởi việc chạy yum update vì có một quy trình đặc biệt cần
tuân theo để nâng cấp Kubernetes. Vui lòng chú ý rằng kho lưu trữ này
chỉ có các package cho Kubernetes 1.37; đối với
những phiên bản Kubernetes minor khác, bạn cần phải
thay đổi phiên bản Kubernetes minor trong URL để trùng với phiên bản minor bạn mong muốn
(bạn cũng nên kiểm tra lại rằng bạn đang đọc tài liệu cho phiên bản Kubernetes
mà bạn dự định cài đặt).
# Điều này sẽ ghi đè bất kỳ những cấu hình nào đang có trong /etc/yum.repos.d/kubernetes.repocat <<EOF | sudo tee /etc/yum.repos.d/kubernetes.repo
[kubernetes]
name=Kubernetes
baseurl=https://pkgs.k8s.io/core:/stable:/v1.37/rpm/
enabled=1
gpgcheck=1
gpgkey=https://pkgs.k8s.io/core:/stable:/v1.37/rpm/repodata/repomd.xml.key
exclude=kubelet kubeadm kubectl cri-tools kubernetes-cni
EOF
Một cách tùy chọn, bật dịch vụ kubelet trước khi chạy kubeadm:
sudo systemctl enable --now kubelet
Lưu ý:
Bản phân phối Linux Flatcar Container gắn thư mục /usr thành một hệ thống file chỉ đọc.
Xem hướng dẫn Khắc phục sự cố Kubeadm
để biết cách thiết lập một thư mục có thể ghi.
Bây giờ kubelet khởi động sau mỗi vài giây, vì nó đợi trong vòng lặp crashloop chờ
kubeadm bảo nó phải làm gì.
Cấu hình cgroup driver
Cả container runtime và kubelet có một thuộc tính gọi là
"cgroup driver", cái mà quan trọng
cho việc quản lý các cgroup trên các máy Linux.
Cảnh báo:
Làm cho khớp các cgroup driver của container runtime và kubelet là bắt buộc hoặc nếu không thì tiến trình kubelet sẽ lỗi.
2.2.2.1.2 - Các tùy chọn cho kiến trúc có tính Sẵn sàng cao
Trang này giải thích hai lựa chọn cho việc cấu hình kiến trúc cho các cụm Kubernetes có tính sẵn sàng cao (HA) của bạn.
Bạn có thể thiết lập một cụm HA:
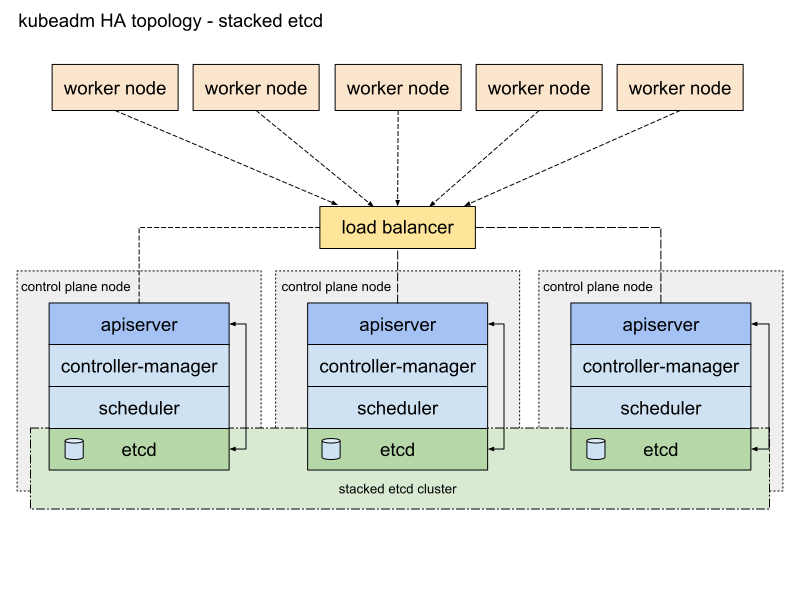
Với các control plane node xếp chồng, nơi các etcd node được đặt cùng vị trí với các control plane node
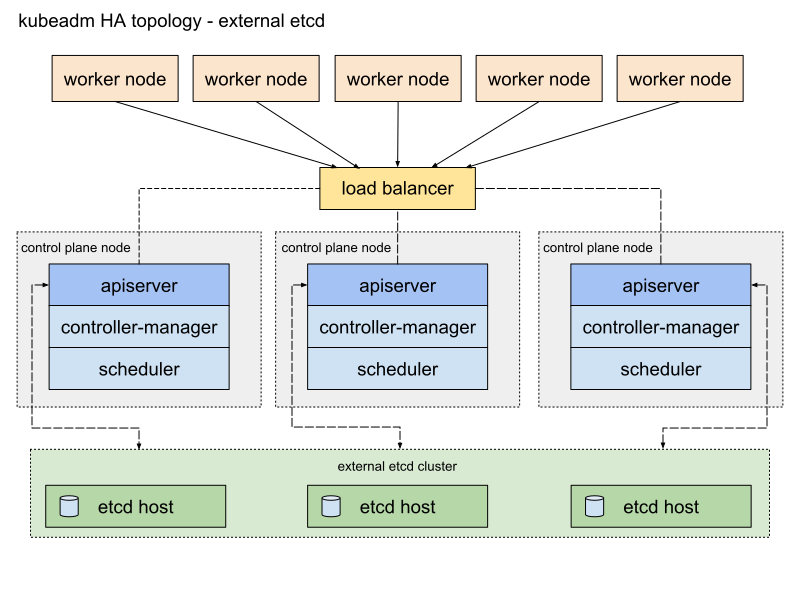
Với các etcd node bên ngoài, nơi etcd chạy trên từng node riêng biệt so với các control plane node
Bạn nên cân nhắc kỹ lưỡng những ưu điểm và nhược điểm của từng kiến trúc trước khi thiết lập một cụm HA.
Lưu ý:
kubeadm khởi tạo cụm etcd một cách tĩnh. Đọc
Hướng dẫn Phân cụm etcd
để biết thêm chi tiết.
Kiến trúc etcd xếp chồng
Một cụm HA xếp chồng là một kiến trúc nơi cụm lưu trữ
dữ liệu phân tán được cung cấp bởi etcd được xếp chồng lên đầu cụm được hình thành bởi các node được quản lý bởi
kubeadm chạy các thành phần control plane.
Mỗi control plane node chạy một instance kube-apiserver, kube-scheduler, và kube-controller-manager.
kube-apiserver được expose tới các worker node bằng một bộ cân bằng tải.
Mỗi control plane node tạo một etcd member cục bộ và etcd member này chỉ giao tiếp với
kube-apiserver của node đó. Tương tự áp dụng cho các instance kube-controller-manager
và kube-scheduler cục bộ.
Cấu trúc liên kết này kết hợp các control plane và các etcd member trên cùng một node. Điều này đơn giản hơn việc thiết lập một cụm
với các etcd node bên ngoài, và đơn giản hơn để quản lý replication.
Tuy nhiên, một cụm xếp chồng có nguy cơ lỗi hàng loạt. Nếu một node bị lỗi, cả một etcd member và một instance control
plane bị lỗi, và khả năng dự phòng bị ảnh hưởng. Bạn có thể giảm thiểu rủi ro này bằng cách bổ sung thêm control plane node.
Do đó, bạn nên chạy tối thiểu ba node control plane xếp chồng cho cụm HA.
Đây là kiến trúc mặc định trong kubeadm. Một etcd member cục bộ được tạo tự động
trên control plane node khi sử dụng kubeadm init và kubeadm join --control-plane.
Kiến trúc etcd bên ngoài
Một cụm HA với etcd bên ngoài là một kiến trúc
nơi cụm lưu trữ dữ liệu phân tán được cung cấp bởi etcd nằm ngoài cụm được hình thành bởi
các node chạy các thành phần control plane.
Giống như kiến trúc etcd xếp chồng, mỗi control plane node trong một kiến trúc etcd bên ngoài chạy
một instance kube-apiserver, kube-scheduler, và kube-controller-manager.
Và kube-apiserver được expose tới các worker node bằng một bộ cân bằng tải. Tuy nhiên,
các etcd member chạy trên từng host riêng biệt, và từng etcd host giao tiếp với
kube-apiserver của từng control plane node.
Kiến trúc này tách rời control plane và etcd member. Vì thế nó cung cấp một thiết lập HA trong đó
việc mất một control plane instance hoặc một etcd member có ít tác động hơn và không ảnh hưởng tới
khả năng dự phòng của cụm như kiến trúc HA xếp chồng.
Tuy nhiên, kiến trúc này yêu cầu gấp đôi số lượng host so với kiến trúc HA xếp chồng.
Yêu cầu tối thiểu ba host cho các control plane node và ba host cho các etcd node
cho một cụm HA với kiến trúc này.
2.2.2.1.3 - Tạo các cụm có tính Sẵn sàng cao với kubeadm
Trang này giải thích hai cách tiếp cận khác nhau để thiết lập một cụm Kubernetes sẵn sàng cao
sử dụng kubeadm:
Với các control plane node xếp chồng. Cách tiếp cận này yêu cầu ít cơ sở hạ tầng. Các etcd member
và control plane node nằm cùng vị trí.
Với một cụm etcd bên ngoài. Cách tiếp cận này yêu cầu nhiều cơ sở hạ tầng hơn. Các
control plane node và etcd member được tách biệt.
Trước khi tiến hành, bạn nên cân nhắc kỹ lưỡng cách tiếp cận nào đáp ứng tốt nhất nhu cầu của các ứng dụng
và môi trường của bạn. Các tùy chọn cho kiến trúc có tính Sẵn sàng cao
chỉ ra các ưu điểm và nhược điểm của từng cách đó.
Nếu bạn gặp phải các vấn đề khi thiết lập cụm HA, vui lòng phản ánh chúng
trong trình theo dõi vấn đề kubeadm.
Trang này không giải quyết việc chạy cụm của bạn trên một nhà cung cấp cloud. Trong một
môi trường cloud, không có cách tiếp cận nào được đề cập ở đây hoạt động với các đối tượng
Service loại LoadBalancer, hoặc với PersistentVolumes động.
Trước khi bạn bắt đầu
Những điều kiện tiên quyết dựa trên kiến trúc bạn chọn cho
control plane của cụm:
Bạn cần:
Ba hoặc nhiều hơn các máy đáp ứng các yêu cầu tối thiểu của kubeadm cho
các control plane node. Có một số lượng lẻ các control plane node có thể giúp
cho việc chọn leader trong trường hợp máy hoặc zone gặp lỗi.
Ba hoặc nhiều hơn các máy đáp ứng các yêu cầu tối thiểu của kubeadm cho
các control plane node. Có một số lượng lẻ các control plane node có thể giúp
cho việc chọn leader trong trường hợp máy hoặc zone gặp lỗi.
bao gồm một container runtime, đã được thiết lập và hoạt động.
Kết nối toàn mạng giữa các máy trong cụm (mạng public hoặc
private).
Đặc quyền superuser trên tất cả các máy sử dụng sudo.
Bạn có thể sử dụng một công cụ khác; hướng dẫn này sử dụng sudo trong các ví dụ.
Quyền truy cập SSH từ một thiết bị tới toàn bộ các node trong hệ thống.
kubeadm và kubelet đã được cài đặt trên toàn bộ các máy.
Và bạn cũng cần:
Ba hoặc nhiều các máy bổ sung, chúng sẽ trở thành các etcd member của cụm.
Yêu cầu một số lượng lẻ các member trong cụm etcd để đạt được
ngưỡng bầu cử tối ưu.
Những máy này cũng cần được cài đặt kubeadm và kubelet.
Những máy này cũng yêu cầu một container runtime đã được thiết lập và hoạt động.
Từng host cần có quyền read và fetch các image từ Kubernetes container image registry,
registry.k8s.io. Nếu bạn muốn triển khai một cụm HA trong đó các host không có
quyền pull image, điều này khả thi. Bạn cần phải đảm bảo rằng các container image cần thiết
có sẵn trên các host liên quan bằng một vài phương pháp khác.
Giao diện dòng lệnh
Để quản lý Kubernetes một khi cụm của bạn được thiết lập, bạn nên
cài đặt kubectl trên PC của bạn. Cài đặt
công cụ kubectl trên từng control plane node cũng hữu ích, vì nó có thể
giúp trong việc xử lý sự cố.
Những bước đầu tiên cho cả hai phương pháp
Tạo bộ cân bằng tải cho kube-apiserver
Lưu ý:
Có nhiều kiểu cấu hình cho các bộ cân bằng tải. Ví dụ dưới đây là một lựa chọn.
Những yêu cầu đối với cụm của bạn có thể cần một cấu hình khác.
Tạo một bộ cân bằng tải kube-apiserver với tên được phân giải tới DNS.
Trong một môi trường cloud bạn nên đặt các control plane node của bạn phía sau một
bộ cân bằng tải chuyển tiếp TCP. Bộ cân bằng tải này phân bổ lưu lượng tới toàn bộ
các control plane node khỏe mạnh trong danh sách target của nó. Kiểm tra sức khỏe
cho một apiserver là một kiểm tra TCP trên port mà kube-apiserver lắng nghe
(giá trị mặc định :6443).
Không nên sử dụng một địa chỉ IP một cách trực tiếp trong môi trường cloud.
Bộ cân bằng tải phải có khả năng giao tiếp với toàn bộ control plane node
trên port của apiserver. Nó cũng phải cho phép lưu lượng truy cập đến trên port
được nó lắng nghe.
Đảm bảo rằng địa chỉ của bộ cân bằng tải luôn khớp với
địa chỉ ControlPlaneEndpoint của kubeadm.
Thêm control plane node đầu tiên vào bộ cân bằng tải, và kiểm tra
kết nối:
nc -zv -w 2 <LOAD_BALANCER_IP> <PORT>
Một lỗi từ chối kết nối có thể xảy ra bởi vì API server vẫn chưa
chạy. Tuy nhiên, timeout có nghĩa là bộ cân bằng tải không thể giao tiếp
với control plane node. Nếu một timeout xảy ra, cấu hình lại bộ
cân bằng tải để có thể giao tiếp với control plane node.
Thêm các control plane node còn lại vào target group của bộ cân bằng tải.
Bạn có thể sử dụng cờ --kubernetes-version để chỉ định phiên bản Kubernetes mong muốn.
Khuyến nghị rằng các phiên bản của kubeadm, kubelet, kubectl và Kubernetes khớp với nhau.
Cờ --control-plane-endpoint nên được đặt thành địa chỉ hoặc DNS và port của bộ cân bằng tải.
Cờ --upload-certs được sử dụng để upload các chứng chỉ mà sẽ được chia sẻ
tới toàn bộ control-plane instance trong cụm. Nếu thay vào đó, bạn muốn copy các chứng chỉ tới toàn bộ
control-plane node một cách thủ công hoặc sử dụng các công cụ tự động, vui lòng bỏ qua cờ này và xem
phần Phân bổ chứng chỉ thủ công bên dưới.
Lưu ý:
Trong kubeadm init, các cờ --config và --certificate-key không thể kết hợp, vì nếu bạn muốn
sử dụng cấu hình kubeadm
bạn phải thêm trường certificateKey trong các vị trí cấu hình thích hợp
(dưới InitConfiguration và JoinConfiguration: controlPlane).
Lưu ý:
Một vài CNI network plugin yêu cầu cấu hình bổ sung, ví dụ chỉ định pod IP CIDR, trong khi những cái khác thì không.
Xem tài liệu CNI network.
Để thêm một pod CIDR sử dụng cờ --pod-network-cidr, hoặc nếu bạn đang sử dụng file cấu hình kubeadm
đặt trường podSubnet bên dưới đối tượng networking của ClusterConfiguration.
Output sẽ trông giống như dưới đây:
...
You can now join any number of control-plane node by running the following command on each as a root:
    kubeadm join 192.168.0.200:6443 --token 9vr73a.a8uxyaju799qwdjv --discovery-token-ca-cert-hash sha256:7c2e69131a36ae2a042a339b33381c6d0d43887e2de83720eff5359e26aec866 --control-plane --certificate-key f8902e114ef118304e561c3ecd4d0b543adc226b7a07f675f56564185ffe0c07

Please note that the certificate-key gives access to cluster sensitive data, keep it secret!
As a safeguard, uploaded-certs will be deleted in two hours; If necessary, you can use kubeadm init phase upload-certs to reload certs afterward.

Then you can join any number of worker nodes by running the following on each as root:
    kubeadm join 192.168.0.200:6443 --token 9vr73a.a8uxyaju799qwdjv --discovery-token-ca-cert-hash sha256:7c2e69131a36ae2a042a339b33381c6d0d43887e2de83720eff5359e26aec866
Copy output này ra một file text. Bạn sẽ cần nó sau này để join các node control plane và worker vào
cụm.
Khi cờ --upload-certs được sử dụng cùng kubeadm init, các chứng chỉ của control plane chính
được mã hóa và upload trong kubeadm-certs Secret.
Để upload lại các chứng chỉ và tạo ra một khóa giải mã mới, sử dụng lệnh sau đây trên một
control plane
node mà đã join vào cụm:
Bạn cũng có thể chỉ định một --certificate-key tùy chỉnh trong lúc init mà sau này có thể được sử dụng để join.
Để tạo ra một khóa như vậy bạn có thể sử dụng lệnh sau đây:
kubeadm certs certificate-key
Khóa của chứng chỉ là một chuỗi mã hóa hex, đó là một khóa AES có kích thước 32 byte.
Lưu ý:
kubeadm-certs Secret và khóa giải mã sẽ hết hạn sau hai giờ.
Chú ý:
Như đã nêu trong output của câu lệnh, khóa chứng chỉ cung cấp quyền truy cập tới dữ liệu nhạy cảm của cụm, hãy giữ nó bí mật!
Áp dụng CNI plugin mà bạn chọn:
Theo dõi các hướng dẫn
để cài đặt nhà cung cấp CNI. Chắc chắn rằng cấu hình tương ứng với Pod CIDR đã được chỉ định trong
file cấu hình kubeadm (nếu có).
Lưu ý:
Bạn phải chọn một network plugin phù hợp với trường hợp sử dụng của bạn và triển khai nó trước khi bạn chuyển sang bước tiếp theo.
Nếu bạn không làm điều đó, bạn sẽ không thể khởi chạy cụm của bạn đúng cách.
Nhập câu lệnh sau và xem các pod của các thành phần control plane bắt đầu chạy:
kubectl get pod -n kube-system -w
Các bước cho các control plane node còn lại
Đối với từng control plane node bổ sung bạn nên:
Thực thi lệnh join bạn nhận được bởi kubeadm init output trước đây trên node đầu tiên.
Nó sẽ trông giống như này:
Cờ --control-plane báo cho kubeadm join tạo một control plane mới.
Cờ --certificate-key ... sẽ download các chứng chỉ cho control plane
từ kubeadm-certs Secret trong cụm và được giải mã bằng khóa được cung cấp.
Bạn có thể join nhiều control-plane node đồng thời.
Các etcd node bên ngoài
Thiết lập một cụm với các etcd node bên ngoài giống như các thủ tục được sử dụng cho etcd xếp chồng
với ngoại lệ là bạn phải thiết lập etcd trước, và bạn sẽ thêm thông tin etcd
trong file cấu hình kubeadm.
Khởi tạo cụm etcd
Theo dõi những hướng dẫn này để khởi tạo cụm etcd.
Thay giá trị của CONTROL_PLANE bằng user@host của control-plane node đầu tiên.
Thiết lập control plane node đầu tiên
Tạo một file với tên kubeadm-config.yaml cùng với những nội dung sau đây:
---apiVersion:kubeadm.k8s.io/v1beta4kind:ClusterConfigurationkubernetesVersion:stablecontrolPlaneEndpoint:"LOAD_BALANCER_DNS:LOAD_BALANCER_PORT"# thay đổi cái này (xem bên dưới)etcd:external:endpoints:- https://ETCD_0_IP:2379# thay ETCD_0_IP thích hợp- https://ETCD_1_IP:2379# thay ETCD_1_IP thích hợp- https://ETCD_2_IP:2379# thay ETCD_2_IP thích hợpcaFile:/etc/kubernetes/pki/etcd/ca.crtcertFile:/etc/kubernetes/pki/apiserver-etcd-client.crtkeyFile:/etc/kubernetes/pki/apiserver-etcd-client.key
Lưu ý:
Sự khác nhau giữa etcd xếp chồng và etcd bên ngoài là thiết lập etcd bên ngoài yêu cầu
một file cấu hình với các etcd endpoint bên dưới đối tượng external của etcd.
Trong trường hợp của kiến trúc etcd xếp chồng, nó được quản lý tự động.
Thay các biến sau đây trong mẫu cấu hình bằng các giá trị thích hợp cho cụm của bạn:
LOAD_BALANCER_DNS
LOAD_BALANCER_PORT
ETCD_0_IP
ETCD_1_IP
ETCD_2_IP
Những bước sau đây tương tự với thiết lập etcd xếp chồng:
Chạy sudo kubeadm init --config kubeadm-config.yaml --upload-certs trên node này.
Viết output của các lệnh join được trả về vào một file text để sử dụng sau này.
Áp dụng CNI plugin mà bạn chọn.
Lưu ý:
Bạn phải chọn một network plugin phù hợp với trường hợp sử dụng của bạn và triển khai nó trước khi bạn chuyển sang bước tiếp theo.
Nếu bạn không làm điều đó, bạn sẽ không thể khởi chạy cụm của bạn đúng cách.
Các bước cho các control plane node còn lại
Các bước giống với thiết lập etcd xếp chồng:
Đảm bảo rằng control plane node đầu tiên được khởi tạo hoàn tất.
Join từng control plane node với lệnh join bạn lưu trong một file text. Bạn nên
join các control plane node lần lượt.
Đừng quên rằng khóa giải mã từ --certificate-key mặc định sẽ hết hạn sau hai giờ.
Những task phổ biến sau khi khởi tạo control plane
Cài đặt các worker
Các worker node có thể được join vào cụm với lệnh bạn lưu trước đó từ
output của lệnh kubeadm init:
Nếu bạn chọn không sử dụng kubeadm init với cờ --upload-certs điều đó có nghĩa là
bạn sẽ phải copy thủ công các chứng chỉ từ control plane node chính tới
các control plane node sắp join.
Có nhiều cách để làm điều đó. Cách dưới đây sử dụng ssh và scp:
SSH là cần thiết nếu bạn muốn điều khiển toàn bộ các node từ một máy đơn.
Cho phép ssh-agent trên thiết bị chính của bạn có quyền truy cập tới toàn bộ các node khác trong
hệ thống:
eval$(ssh-agent)
Thêm định danh SSH vào phiên:
ssh-add ~/.ssh/path_to_private_key
SSH giữa các node để kiểm tra kết nối hoạt động tốt.
Khi bạn SSH tới bất kỳ node nào, thêm cờ -A. Cờ này cho phép node mà bạn
đăng nhập qua SSH có quyền truy cập tới SSH agent trên PC của bạn. Cân nhắc các phương pháp
thay thế nếu bạn không hoàn toàn tin tưởng vào bảo mật của phiên người dùng của bạn trên node.
ssh -A 10.0.0.7
Khi bạn sử dụng sudo trên bất kỳ node nào, đảm bảo duy trì môi trường để SSH
chuyển tiếp các hoạt động:
sudo -E -s
Sau khi cấu hình SSH trên toàn bộ các node bạn nên chạy tập lệnh sau đây trên
control plane node đầu tiên sau khi chạy kubeadm init. Tập lệnh này sẽ copy các chứng chỉ từ
control plane node đầu tiên tới các control plane node khác:
Trong ví dụ dưới đây, thay CONTROL_PLANE_IPS với các địa chỉ IP của
các control plane node khác.
USER=ubuntu # có thể tùy chỉnhCONTROL_PLANE_IPS="10.0.0.7 10.0.0.8"for host in ${CONTROL_PLANE_IPS};do scp /etc/kubernetes/pki/ca.crt "${USER}"@$host:
scp /etc/kubernetes/pki/ca.key "${USER}"@$host:
scp /etc/kubernetes/pki/sa.key "${USER}"@$host:
scp /etc/kubernetes/pki/sa.pub "${USER}"@$host:
scp /etc/kubernetes/pki/front-proxy-ca.crt "${USER}"@$host:
scp /etc/kubernetes/pki/front-proxy-ca.key "${USER}"@$host:
scp /etc/kubernetes/pki/etcd/ca.crt "${USER}"@$host:etcd-ca.crt
# Bỏ qua dòng tiếp theo nếu bạn đang sử dụng etcd bên ngoài scp /etc/kubernetes/pki/etcd/ca.key "${USER}"@$host:etcd-ca.key
done
Chú ý:
Chỉ copy các chứng chỉ trong danh sách trên. kubeadm sẽ phụ trách việc sinh ra các chứng chỉ còn lại
cùng với các SAN cần thiết cho các control-plane instance sắp join. Nếu bạn copy toàn bộ các chứng chỉ do nhầm lẫn,
quá trình tạo các node bổ sung có thể thất bại do thiếu các SAN cần thiết.
Sau đó trên từng control plane node sắp join bạn phải chạy tập lệnh sau đây trước khi chạy kubeadm join.
Tập lệnh này sẽ di chuyển các chứng chỉ đã được copy trước đây từ thư mục home tới /etc/kubernetes/pki:
USER=ubuntu # có thể tùy chỉnhmkdir -p /etc/kubernetes/pki/etcd
mv /home/${USER}/ca.crt /etc/kubernetes/pki/
mv /home/${USER}/ca.key /etc/kubernetes/pki/
mv /home/${USER}/sa.pub /etc/kubernetes/pki/
mv /home/${USER}/sa.key /etc/kubernetes/pki/
mv /home/${USER}/front-proxy-ca.crt /etc/kubernetes/pki/
mv /home/${USER}/front-proxy-ca.key /etc/kubernetes/pki/
mv /home/${USER}/etcd-ca.crt /etc/kubernetes/pki/etcd/ca.crt
# Bỏ qua dòng tiếp theo nếu bạn đang sử dụng etcd bên ngoàimv /home/${USER}/etcd-ca.key /etc/kubernetes/pki/etcd/ca.key
2.2.2.1.4 - Thiết lập một cụm etcd có tính Sẵn sàng cao (High Availability) với kubeadm
Mặc định, kubeadm chạy một instance etcd cục bộ trên từng node control plane.
Bạn cũng có thể thiết lập cụm etcd bên ngoài và cung cấp các etcd instance trên
các máy chủ riêng biệt. Những sự khác biệt giữa hai cách tiếp cận này được trình bày
trong trang
Các tùy chọn cho kiến trúc có tính Sẵn sàng cao.
Tác vụ này hướng dẫn quy trình tạo một cụm etcd bên ngoài có tính sẵn sàng cao gồm
ba member mà kubeadm có thể sử dụng trong quá trình tạo cụm.
Trước khi bạn bắt đầu
Ba máy chủ có thể giao tiếp với nhau qua cổng TCP 2379 và 2380.
Tài liệu này giả định các cổng mặc định này. Tuy nhiên, chúng có thể được cấu hình
thông qua tệp cấu hình kubeadm.
Mỗi máy chủ phải có systemd và đã cài đặt một shell tương thích với bash.
Mỗi máy chủ phải có quyền truy cập vào Kubernetes container image registry (registry.k8s.io)
hoặc list/pull image etcd cần thiết bằng lệnh kubeadm config images list/pull. Hướng dẫn này
sẽ cài đặt các etcd instance dạng
static pods được quản lý bởi kubelet.
Một số công cụ để sao chép các file giữa các máy chủ. Ví dụ ssh và scp
có thể đáp ứng yêu cầu này.
Thiết lập cụm
Cách tiếp cận thông thường là tạo ra toàn bộ chứng chỉ trên một node và chỉ phân bổ
những file quan trọng tới các node khác.
Lưu ý:
kubeadm chứa tất cả các công cụ mã hóa cần thiết để tạo ra
các chứng chỉ được đề cập bên dưới; không cần các công cụ mã hóa nào khác cho ví dụ này.
Lưu ý:
Ví dụ bên dưới sử dụng dịa chỉ IPv4 nhưng bạn cũng có thể cấu hình kubeadm, kubelet và etcd
sử dụng địa chỉ IPv6. Dual-stack được hỗ trợ bởi một vài tùy chọn của Kubernetes, nhưng
không được etcd hỗ trợ. Xem thêm chi tiết về Kubernetes hỗ trợ dual-stack tại
Hỗ trợ Dual-stack với kubeadm.
Cấu hình kubelet để trở thành trình quản lý dịch vụ cho etcd.
Lưu ý:
Bạn phải thực hiện điều này trên toàn bộ các máy chủ chạy etcd.
Vì etcd sẽ được tạo ra trước tiên, bạn phải ghi đè độ ưu tiên dịch vụ bằng cách tạo ra một
unit file mới có độ ưu tiên cao hơn kubelet unit file mà kubeadm cung cấp.
cat << EOF > /etc/systemd/system/kubelet.service.d/kubelet.conf
# Thay thế "systemd" bằng giá trị cgroup driver của container runtime của bạn. Giá trị mặc định trong kubelet là "cgroupfs".
# Thay thế giá trị của "containerRuntimeEndpoint" bằng một container runtime khác nếu cần.
#
apiVersion: kubelet.config.k8s.io/v1beta1
kind: KubeletConfiguration
authentication:
anonymous:
enabled: false
webhook:
enabled: false
authorization:
mode: AlwaysAllow
cgroupDriver: systemd
address: 127.0.0.1
containerRuntimeEndpoint: unix:///var/run/containerd/containerd.sock
staticPodPath: /etc/kubernetes/manifests
EOFcat << EOF > /etc/systemd/system/kubelet.service.d/20-etcd-service-manager.conf
[Service]
ExecStart=
ExecStart=/usr/bin/kubelet --config=/etc/systemd/system/kubelet.service.d/kubelet.conf
Restart=always
EOFsystemctl daemon-reload
systemctl restart kubelet
Kiểm tra trạng thái kubelet để chắc chắn rằng nó đang chạy.
systemctl status kubelet
Tạo các file cấu hình cho kubeadm.
Tạo một file cấu hình kubeadm cho từng máy chủ mà có etcd member chạy trên đó
sử dụng tập lệnh dưới đây.
# Thay đổi HOST0, HOST1 và HOST2 với các IP của các máy của bạnexportHOST0=10.0.0.6
exportHOST1=10.0.0.7
exportHOST2=10.0.0.8
# Thay đổi NAME0, NAME1 và NAME2 bằng hostnames của các máy của bạnexportNAME0="infra0"exportNAME1="infra1"exportNAME2="infra2"# Tạo các thư mục tạm thời để lưu các file sẽ xuất hỉện trên các máy khácmkdir -p /tmp/${HOST0}/ /tmp/${HOST1}/ /tmp/${HOST2}/
HOSTS=(${HOST0}${HOST1}${HOST2})NAMES=(${NAME0}${NAME1}${NAME2})for i in "${!HOSTS[@]}";doHOST=${HOSTS[$i]}NAME=${NAMES[$i]}cat << EOF > /tmp/${HOST}/kubeadmcfg.yaml
---
apiVersion: "kubeadm.k8s.io/v1beta4"
kind: InitConfiguration
nodeRegistration:
name: ${NAME}
localAPIEndpoint:
advertiseAddress: ${HOST}
---
apiVersion: "kubeadm.k8s.io/v1beta4"
kind: ClusterConfiguration
etcd:
local:
serverCertSANs:
- "${HOST}"
peerCertSANs:
- "${HOST}"
extraArgs:
- name: initial-cluster
value: ${NAMES[0]}=https://${HOSTS[0]}:2380,${NAMES[1]}=https://${HOSTS[1]}:2380,${NAMES[2]}=https://${HOSTS[2]}:2380
- name: initial-cluster-state
value: new
- name: name
value: ${NAME}
- name: listen-peer-urls
value: https://${HOST}:2380
- name: listen-client-urls
value: https://${HOST}:2379
- name: advertise-client-urls
value: https://${HOST}:2379
- name: initial-advertise-peer-urls
value: https://${HOST}:2380
EOFdone
Tạo cơ quan cấp chứng chỉ (CA).
Nếu bạn đã có một CA, việc tiếp theo chỉ cần sao chép các file crt và
key của CA tới /etc/kubernetes/pki/etcd/ca.crt và
/etc/kubernetes/pki/etcd/ca.key. Sau khi các file đó được sao chép,
tiến hành các bước tiếp theo, "Tạo các chứng chỉ cho từng member member".
Nếu bạn chưa có CA nào, hãy chạy câu lệnh này trên $HOST0 (nơi bạn
tạo các file cấu hình cho kubeadm).
kubeadm init phase certs etcd-ca
Nó sẽ tạo ra hai file:
/etc/kubernetes/pki/etcd/ca.crt
/etc/kubernetes/pki/etcd/ca.key
Tạo các chứng chỉ cho từng member member.
kubeadm init phase certs etcd-server --config=/tmp/${HOST2}/kubeadmcfg.yaml
kubeadm init phase certs etcd-peer --config=/tmp/${HOST2}/kubeadmcfg.yaml
kubeadm init phase certs etcd-healthcheck-client --config=/tmp/${HOST2}/kubeadmcfg.yaml
kubeadm init phase certs apiserver-etcd-client --config=/tmp/${HOST2}/kubeadmcfg.yaml
cp -R /etc/kubernetes/pki /tmp/${HOST2}/
# Dọn dẹp các chứng chỉ không sử dụngfind /etc/kubernetes/pki -not -name ca.crt -not -name ca.key -type f -delete
kubeadm init phase certs etcd-server --config=/tmp/${HOST1}/kubeadmcfg.yaml
kubeadm init phase certs etcd-peer --config=/tmp/${HOST1}/kubeadmcfg.yaml
kubeadm init phase certs etcd-healthcheck-client --config=/tmp/${HOST1}/kubeadmcfg.yaml
kubeadm init phase certs apiserver-etcd-client --config=/tmp/${HOST1}/kubeadmcfg.yaml
cp -R /etc/kubernetes/pki /tmp/${HOST1}/
find /etc/kubernetes/pki -not -name ca.crt -not -name ca.key -type f -delete
kubeadm init phase certs etcd-server --config=/tmp/${HOST0}/kubeadmcfg.yaml
kubeadm init phase certs etcd-peer --config=/tmp/${HOST0}/kubeadmcfg.yaml
kubeadm init phase certs etcd-healthcheck-client --config=/tmp/${HOST0}/kubeadmcfg.yaml
kubeadm init phase certs apiserver-etcd-client --config=/tmp/${HOST0}/kubeadmcfg.yaml
# Không cần phải di chuyển các chứng chỉ vì chúng dành cho HOST0# Dọn dẹp các chứng chỉ không nên sao chép khỏi máy chủ nàyfind /tmp/${HOST2} -name ca.key -type f -delete
find /tmp/${HOST1} -name ca.key -type f -delete
Sao chép các chứng chỉ và các cấu hình kubeadm.
Các chứng chỉ này đã được tạo ra và bây giờ chúng cần được đưa tới từng máy chủ
tương ứng.
Bây giờ các chứng chỉ và cấu hình đã có, đã đến lúc tạo các manifest.
Trên mỗi máy chủ, hãy chạy lệnh kubeadm để tạo static manifest
cho etcd.
root@HOST0 $ kubeadm init phase etcd local --config=/tmp/${HOST0}/kubeadmcfg.yaml
root@HOST1 $ kubeadm init phase etcd local --config=$HOME/kubeadmcfg.yaml
root@HOST2 $ kubeadm init phase etcd local --config=$HOME/kubeadmcfg.yaml
Tùy chọn: Kiểm tra sức khỏe cụm.
Nếu etcdctl không có sẵn, bạn có thể chạy công cụ này trong một container image.
Bạn sẽ thực hiện điều đó trực tiếp với container runtime của mình bằng cách sử dụng
một công cụ như crictl run và không thông qua Kubernetes.
Đặt ${HOST0} bằng địa chỉ IP của máy chủ bạn đang kiểm tra.
Tiếp theo là gì
Một khi bạn đã có một cụm etcd với 3 member đang chạy, bạn có thể tiếp tục thiết lập
một control plane có tính sẵn sàng cao bằng
phương pháp etcd bên ngoài với kubeadm.
2.3 - Một số cách thức cài đặt tốt
3 - Các khái niệm
Phần Khái niệm giúp bạn tìm hiểu về các bộ phận của hệ thống Kubernetes và các khái niệm mà Kubernetes sử dụng để biểu diễn cụm cluster của bạn, đồng thời giúp bạn hiểu sâu hơn về cách thức hoạt động của Kubernetes.
3.1 - Deployments
Deployment quản lý một tập hợp các Pod để chạy một workload ứng dụng, thường là các ứng dụng không duy trì trạng thái.
Deployment cung cấp khả năng cập nhật dạng khai báo (declarative) cho các Pod và
ReplicaSet.
Bạn mô tả trạng thái mong muốn (desired state) trong một Deployment, và Vòng điều khiển (Controller) của Deployment sẽ thay đổi trạng thái thực tế sang trạng thái mong muốn với tốc độ được kiểm soát. Bạn có thể định nghĩa các Deployment để tạo ReplicaSet mới, hoặc để xóa các Deployment hiện có và tiếp nhận toàn bộ tài nguyên của chúng bằng các Deployment mới.
Lưu ý:
Không quản lý trực tiếp các ReplicaSet thuộc sở hữu của một Deployment. Hãy cân nhắc mở một issue trong repository chính của Kubernetes nếu trường hợp sử dụng của bạn không được đề cập bên dưới.
Trường hợp sử dụng
Sau đây là các trường hợp sử dụng điển hình của Deployment:
Khai báo trạng thái mới của các Pod bằng cách cập nhật PodTemplateSpec của Deployment. Một ReplicaSet mới được tạo ra, và Deployment dần dần scale up ReplicaSet mới đồng thời scale down ReplicaSet cũ, đảm bảo các Pod được thay thế với tốc độ được kiểm soát. Mỗi ReplicaSet mới sẽ cập nhật revision của Deployment.
Một Deployment tên là nginx-deployment được tạo, được chỉ định bởi trường
.metadata.name. Tên này sẽ trở thành cơ sở để đặt tên cho các ReplicaSet
và Pod được tạo sau đó. Xem Viết spec cho Deployment
để biết thêm chi tiết.
Deployment tạo một ReplicaSet, ReplicaSet này tạo ba Pod replica, được chỉ định bởi trường .spec.replicas.
Trường .spec.selector định nghĩa cách ReplicaSet được tạo ra tìm các Pod mà nó cần quản lý.
Trong trường hợp này, bạn chọn một label được định nghĩa trong Pod template (app: nginx).
Tuy nhiên, có thể sử dụng các quy tắc lựa chọn phức tạp hơn,
miễn là bản thân Pod template thỏa mãn quy tắc đó.
Lưu ý:
Trường .spec.selector.matchLabels là một map gồm các cặp {key,value}.
Một cặp {key,value} trong map matchLabels tương đương với một phần tử của matchExpressions,
có trường key là "key", operator là "In", và mảng values chỉ chứa "value".
Tất cả các yêu cầu, từ cả matchLabels và matchExpressions, đều phải được thỏa mãn thì mới khớp.
Trường .spec.template chứa các trường con sau:
Các Pod được gắn label app: nginx thông qua trường .metadata.labels.
Đặc tả của Pod template, hay trường .spec, chỉ ra rằng
các Pod chạy một container, nginx, container này chạy image nginx trên
Docker Hub ở phiên bản 1.14.2.
Tạo một container và đặt tên là nginx thông qua trường .spec.containers[0].name.
Trước khi bắt đầu, hãy đảm bảo cluster Kubernetes của bạn đang hoạt động.
Làm theo các bước dưới đây để tạo Deployment ở trên:
Chạy kubectl get deployments để kiểm tra xem Deployment đã được tạo hay chưa.
Nếu Deployment vẫn đang được tạo, kết quả sẽ tương tự như sau:
NAME               READY   UP-TO-DATE   AVAILABLE   AGE
nginx-deployment   0/3     0            0           1s
Khi bạn kiểm tra các Deployment trong cluster, các trường sau được hiển thị:
NAME liệt kê tên của các Deployment trong namespace.
READY hiển thị số replica của ứng dụng đang sẵn sàng phục vụ người dùng. Giá trị có dạng ready/desired.
UP-TO-DATE hiển thị số replica đã được cập nhật để đạt trạng thái mong muốn.
AVAILABLE hiển thị số replica của ứng dụng đang khả dụng cho người dùng.
AGE hiển thị khoảng thời gian ứng dụng đã chạy.
Lưu ý rằng số replica mong muốn là 3, theo trường .spec.replicas.
Để xem trạng thái rollout của Deployment, chạy kubectl rollout status deployment/nginx-deployment.
Kết quả tương tự như sau:
Waiting for rollout to finish: 2 out of 3 new replicas have been updated...
deployment "nginx-deployment" successfully rolled out
Chạy lại kubectl get deployments sau vài giây.
Kết quả tương tự như sau:
NAME               READY   UP-TO-DATE   AVAILABLE   AGE
nginx-deployment   3/3     3            3           18s
Lưu ý rằng Deployment đã tạo cả ba replica, và tất cả các replica đều đã được cập nhật (chứa Pod template mới nhất) và khả dụng.
Để xem ReplicaSet (rs) được tạo bởi Deployment, chạy kubectl get rs. Kết quả tương tự như sau:
NAME                          DESIRED   CURRENT   READY   AGE
nginx-deployment-75675f5897   3         3         3       18s
Kết quả của ReplicaSet hiển thị các trường sau:
NAME liệt kê tên của các ReplicaSet trong namespace.
DESIRED hiển thị số replica mong muốn của ứng dụng, được bạn định nghĩa khi tạo Deployment. Đây là trạng thái mong muốn.
CURRENT hiển thị số replica đang chạy.
READY hiển thị số replica của ứng dụng đang sẵn sàng phục vụ người dùng.
AGE hiển thị khoảng thời gian ứng dụng đã chạy.
Lưu ý rằng tên của ReplicaSet luôn có định dạng
[DEPLOYMENT-NAME]-[HASH]. Tên này sẽ trở thành cơ sở để đặt tên cho các Pod
được tạo ra.
Chuỗi HASH giống với label pod-template-hash trên ReplicaSet.
Để xem các label được tự động sinh ra cho mỗi Pod, chạy kubectl get pods --show-labels.
Kết quả tương tự như sau:
NAME                                READY     STATUS    RESTARTS   AGE       LABELS
nginx-deployment-75675f5897-7ci7o   1/1       Running   0          18s       app=nginx,pod-template-hash=75675f5897
nginx-deployment-75675f5897-kzszj   1/1       Running   0          18s       app=nginx,pod-template-hash=75675f5897
nginx-deployment-75675f5897-qqcnn   1/1       Running   0          18s       app=nginx,pod-template-hash=75675f5897
ReplicaSet được tạo đảm bảo rằng luôn có ba Pod nginx.
Lưu ý:
Bạn phải chỉ định một selector và label của Pod template phù hợp trong Deployment
(trong trường hợp này là app: nginx).
Không để label hoặc selector trùng lặp với các controller khác (bao gồm các Deployment và StatefulSet khác). Kubernetes không ngăn bạn làm điều đó, và nếu nhiều controller có selector trùng lặp, các controller đó có thể xung đột và hoạt động không như mong đợi.
Label pod-template-hash
Chú ý:
Không được thay đổi label này.
Label pod-template-hash được Deployment controller thêm vào mỗi ReplicaSet mà một Deployment tạo ra hoặc tiếp nhận (adopt).
Label này đảm bảo rằng các ReplicaSet con của một Deployment không bị trùng lặp. Nó được sinh ra bằng cách băm PodTemplate của ReplicaSet và sử dụng giá trị băm thu được làm giá trị label, được thêm vào selector của ReplicaSet, label của Pod template,
và vào mọi Pod hiện có mà ReplicaSet có thể đang quản lý.
Cập nhật một Deployment
Lưu ý:
Rollout của một Deployment được kích hoạt khi và chỉ khi Pod template của Deployment (tức là .spec.template)
bị thay đổi, ví dụ khi label hoặc image container của template được cập nhật. Các cập nhật khác, chẳng hạn như scale Deployment, sẽ không kích hoạt rollout.
Làm theo các bước dưới đây để cập nhật Deployment của bạn:
Hãy cập nhật các Pod nginx để sử dụng image nginx:1.16.1 thay cho image nginx:1.14.2.
kubectl set image deployment.v1.apps/nginx-deployment nginx=nginx:1.16.1
hoặc sử dụng lệnh sau:
kubectl set image deployment/nginx-deployment nginx=nginx:1.16.1
trong đó deployment/nginx-deployment chỉ định Deployment,
nginx chỉ định container sẽ được cập nhật và
nginx:1.16.1 chỉ định image mới cùng tag của nó.
Kết quả tương tự như sau:
deployment.apps/nginx-deployment image updated
Ngoài ra, bạn có thể edit Deployment và thay đổi .spec.template.spec.containers[0].image từ nginx:1.14.2 thành nginx:1.16.1:
kubectl edit deployment/nginx-deployment
Kết quả tương tự như sau:
deployment.apps/nginx-deployment edited
Để xem trạng thái rollout, chạy:
kubectl rollout status deployment/nginx-deployment
Kết quả tương tự như sau:
Waiting for rollout to finish: 2 out of 3 new replicas have been updated...
hoặc
deployment "nginx-deployment" successfully rolled out
Xem thêm chi tiết về Deployment đã được cập nhật:
Sau khi rollout thành công, bạn có thể xem Deployment bằng cách chạy kubectl get deployments.
Kết quả tương tự như sau:
NAME               READY   UP-TO-DATE   AVAILABLE   AGE
nginx-deployment   3/3     3            3           36s
Chạy kubectl get rs để thấy rằng Deployment đã cập nhật các Pod bằng cách tạo một ReplicaSet mới và scale nó
lên 3 replica, đồng thời scale ReplicaSet cũ xuống 0 replica.
kubectl get rs
Kết quả tương tự như sau:
NAME                          DESIRED   CURRENT   READY   AGE
nginx-deployment-1564180365   3         3         3       6s
nginx-deployment-2035384211   0         0         0       36s
Lúc này, chạy get pods sẽ chỉ hiển thị các Pod mới:
kubectl get pods
Kết quả tương tự như sau:
NAME                                READY     STATUS    RESTARTS   AGE
nginx-deployment-1564180365-khku8   1/1       Running   0          14s
nginx-deployment-1564180365-nacti   1/1       Running   0          14s
nginx-deployment-1564180365-z9gth   1/1       Running   0          14s
Lần tiếp theo khi muốn cập nhật các Pod này, bạn chỉ cần cập nhật lại Pod template của Deployment.
Deployment đảm bảo rằng chỉ một số lượng nhất định Pod bị ngừng hoạt động trong khi chúng đang được cập nhật. Theo mặc định,
nó đảm bảo rằng ít nhất 75% số Pod mong muốn đang chạy (tối đa 25% không khả dụng - max unavailable).
Deployment cũng đảm bảo rằng chỉ một số lượng nhất định Pod được tạo vượt quá số Pod mong muốn.
Theo mặc định, nó đảm bảo rằng tối đa 125% số Pod mong muốn đang chạy (vượt tối đa 25% - max surge).
Ví dụ, nếu quan sát kỹ Deployment ở trên, bạn sẽ thấy nó tạo một Pod mới trước,
sau đó xóa một Pod cũ, rồi tạo thêm một Pod mới khác. Nó không dừng các Pod cũ cho đến khi có đủ số lượng
Pod mới đã chạy, và không tạo Pod mới cho đến khi đủ số lượng Pod cũ đã bị dừng.
Nó đảm bảo rằng ít nhất 3 Pod khả dụng và tổng cộng tối đa 4 Pod khả dụng. Với
một Deployment có 4 replica, số lượng Pod sẽ nằm trong khoảng từ 3 đến 5.
Lấy thông tin chi tiết về Deployment của bạn:
kubectl describe deployments
Kết quả tương tự như sau:
Name:                   nginx-deployment
Namespace:              default
CreationTimestamp:      Thu, 30 Nov 2017 10:56:25 +0000
Labels:                 app=nginx
Annotations:            deployment.kubernetes.io/revision=2
Selector:               app=nginx
Replicas:               3 desired | 3 updated | 3 total | 3 available | 0 unavailable
StrategyType:           RollingUpdate
MinReadySeconds:        0
RollingUpdateStrategy:  25% max unavailable, 25% max surge
Pod Template:
  Labels:  app=nginx
   Containers:
    nginx:
      Image:        nginx:1.16.1
      Port:         80/TCP
      Environment:  <none>
      Mounts:       <none>
    Volumes:        <none>
  Conditions:
    Type           Status  Reason
    ----           ------  ------
    Available      True    MinimumReplicasAvailable
    Progressing    True    NewReplicaSetAvailable
  OldReplicaSets:  <none>
  NewReplicaSet:   nginx-deployment-1564180365 (3/3 replicas created)
  Events:
    Type    Reason             Age   From                   Message
    ----    ------             ----  ----                   -------
    Normal  ScalingReplicaSet  2m    deployment-controller  Scaled up replica set nginx-deployment-2035384211 to 3
    Normal  ScalingReplicaSet  24s   deployment-controller  Scaled up replica set nginx-deployment-1564180365 to 1
    Normal  ScalingReplicaSet  22s   deployment-controller  Scaled down replica set nginx-deployment-2035384211 to 2
    Normal  ScalingReplicaSet  22s   deployment-controller  Scaled up replica set nginx-deployment-1564180365 to 2
    Normal  ScalingReplicaSet  19s   deployment-controller  Scaled down replica set nginx-deployment-2035384211 to 1
    Normal  ScalingReplicaSet  19s   deployment-controller  Scaled up replica set nginx-deployment-1564180365 to 3
    Normal  ScalingReplicaSet  14s   deployment-controller  Scaled down replica set nginx-deployment-2035384211 to 0
Ở đây bạn thấy rằng khi tạo Deployment lần đầu, nó đã tạo một ReplicaSet (nginx-deployment-2035384211)
và scale trực tiếp lên 3 replica. Khi bạn cập nhật Deployment, nó tạo một ReplicaSet mới
(nginx-deployment-1564180365), scale lên 1 và chờ Pod đó chạy. Sau đó nó scale ReplicaSet cũ xuống
2 và scale ReplicaSet mới lên 2, sao cho luôn có ít nhất 3 Pod khả dụng và tối đa 4 Pod được tạo tại mọi thời điểm.
Sau đó nó tiếp tục scale up ReplicaSet mới và scale down ReplicaSet cũ, với cùng chiến lược rolling update.
Cuối cùng, bạn sẽ có 3 replica khả dụng trong ReplicaSet mới, và ReplicaSet cũ được scale xuống 0.
Lưu ý:
Kubernetes không tính các Pod đang dừng khi tính số lượng availableReplicas, giá trị này phải nằm trong khoảng
replicas - maxUnavailable đến replicas + maxSurge. Do đó, bạn có thể thấy có nhiều Pod hơn
dự kiến trong quá trình rollout, và tổng tài nguyên mà Deployment tiêu thụ lớn hơn replicas + maxSurge
cho đến khi terminationGracePeriodSeconds của các Pod đang dừng hết hạn.
Rollover (hay còn gọi là nhiều cập nhật diễn ra đồng thời)
Mỗi khi Deployment controller phát hiện một Deployment mới, một ReplicaSet sẽ được tạo để khởi chạy
các Pod mong muốn. Nếu Deployment được cập nhật, ReplicaSet hiện có đang kiểm soát các Pod có label
khớp với .spec.selector nhưng có template không khớp với .spec.template sẽ bị scale down. Cuối cùng, ReplicaSet
mới được scale lên .spec.replicas và tất cả các ReplicaSet cũ được scale xuống 0.
Nếu bạn cập nhật một Deployment trong khi một rollout đang diễn ra, Deployment sẽ tạo một ReplicaSet mới
theo bản cập nhật và bắt đầu scale up ReplicaSet đó, đồng thời rollover ReplicaSet mà nó đang scale up trước đó
-- nó sẽ thêm ReplicaSet đó vào danh sách các ReplicaSet cũ và bắt đầu scale down nó.
Ví dụ, giả sử bạn tạo một Deployment để tạo 5 replica của nginx:1.14.2,
nhưng sau đó cập nhật Deployment để tạo 5 replica của nginx:1.16.1, khi mới chỉ có 3
replica của nginx:1.14.2 được tạo. Trong trường hợp đó, Deployment ngay lập tức bắt đầu
dừng 3 Pod nginx:1.14.2 mà nó đã tạo, và bắt đầu tạo các Pod
nginx:1.16.1. Nó không đợi 5 replica của nginx:1.14.2 được tạo xong
rồi mới chuyển hướng.
Cập nhật label selector
Nhìn chung, việc cập nhật label selector không được khuyến khích, và bạn nên lên kế hoạch cho các selector từ trước.
Label selector của một Deployment là bất biến sau khi được tạo;
không thể cập nhật nó bằng kubectl patch, kubectl edit, kubectl apply, hay các công cụ như helm upgrade.
Nếu buộc phải thay đổi selector, bạn cần xóa Deployment rồi tạo lại.
Theo mặc định, việc xóa Deployment cũng xóa các Pod đang chạy của nó, gây ra downtime; hãy dùng
--cascade=orphan nếu bạn cần các Pod đó tiếp tục chạy trong khi tạo lại Deployment
(xem các hệ quả bên dưới).
Hãy hết sức thận trọng và đảm bảo bạn hiểu rõ các hệ quả sau:
Thêm: Khi bạn tạo một Deployment mới với selector hẹp hơn, Deployment mới bắt buộc phải có Pod template phù hợp.
Nếu bạn có một manifest sẵn có và sửa manifest đó để thu hẹp selector, bạn cần sửa metadata của Pod template bên trong Deployment đó, thêm các
label mới
cho khớp, nếu không API server sẽ trả về lỗi xác thực (validation error). Đây là một thay đổi không chồng lấn (non-overlapping):
Deployment mới sẽ không "thấy" các Pod cũ (vốn không có label mới), khiến ReplicaSet
cũ bị mồ côi (orphaned) và một ReplicaSet hoàn toàn mới được tạo ra.
Thay đổi giá trị: Thay đổi giá trị hiện có của một key trong selector (ví dụ, từ v1 thành v2)
dẫn đến hành vi giống như khi thêm (ReplicaSet cũ bị mồ côi và được tạo lại).
Xóa: Xóa một key hiện có khỏi selector của Deployment không yêu cầu bất kỳ thay đổi nào
đối với label của Pod template. Đây là một thay đổi chồng lấn (overlapping): selector mới, rộng hơn sẽ
khớp với các Pod cũ. Các ReplicaSet hiện có không bị mồ côi, và không có ReplicaSet mới nào được tạo,
nhưng lưu ý rằng label đã xóa vẫn tồn tại trong các Pod và ReplicaSet hiện có.
Bạn có thể dọn dẹp điều đó bằng cách kích hoạt một rollout cho Deployment.
Rollback một Deployment
Đôi khi, bạn có thể muốn rollback một Deployment; ví dụ, khi Deployment không ổn định, chẳng hạn như bị crash liên tục (crash looping).
Theo mặc định, toàn bộ lịch sử rollout của Deployment được lưu giữ trong hệ thống để bạn có thể rollback bất cứ lúc nào
(bạn có thể thay đổi điều này bằng cách sửa giới hạn lịch sử revision - revision history limit).
Lưu ý:
Revision của một Deployment được tạo khi rollout của Deployment được kích hoạt. Điều này có nghĩa là
revision mới được tạo khi và chỉ khi Pod template (.spec.template) của Deployment bị thay đổi,
ví dụ khi bạn cập nhật label hoặc image container của template. Các cập nhật khác, chẳng hạn như scale Deployment,
không tạo ra revision mới của Deployment, nhờ đó bạn có thể thực hiện đồng thời việc scale thủ công hoặc tự động.
Điều này có nghĩa là khi bạn rollback về một revision trước đó, chỉ phần Pod template của Deployment
được rollback.
Giả sử bạn gõ nhầm khi cập nhật Deployment, đặt tên image là nginx:1.161 thay vì nginx:1.16.1:
kubectl set image deployment/nginx-deployment nginx=nginx:1.161
Kết quả tương tự như sau:
deployment.apps/nginx-deployment image updated
Rollout bị kẹt. Bạn có thể xác minh điều này bằng cách kiểm tra trạng thái rollout:
kubectl rollout status deployment/nginx-deployment
Kết quả tương tự như sau:
Waiting for rollout to finish: 1 out of 3 new replicas have been updated...
Nhấn Ctrl-C để dừng theo dõi trạng thái rollout ở trên. Để biết thêm thông tin về các rollout bị kẹt,
đọc thêm tại đây.
Bạn thấy rằng số replica cũ (cộng số replica từ
nginx-deployment-1564180365 và nginx-deployment-2035384211) là 3, và số
replica mới (từ nginx-deployment-3066724191) là 1.
kubectl get rs
Kết quả tương tự như sau:
NAME                          DESIRED   CURRENT   READY   AGE
nginx-deployment-1564180365   3         3         3       25s
nginx-deployment-2035384211   0         0         0       36s
nginx-deployment-3066724191   1         1         0       6s
Xem các Pod đã được tạo, bạn sẽ thấy 1 Pod được tạo bởi ReplicaSet mới bị kẹt trong vòng lặp kéo image (image pull loop).
kubectl get pods
Kết quả tương tự như sau:
NAME                                READY     STATUS             RESTARTS   AGE
nginx-deployment-1564180365-70iae   1/1       Running            0          25s
nginx-deployment-1564180365-jbqqo   1/1       Running            0          25s
nginx-deployment-1564180365-hysrc   1/1       Running            0          25s
nginx-deployment-3066724191-08mng   0/1       ImagePullBackOff   0          6s
Lưu ý:
Deployment controller tự động dừng rollout lỗi và ngừng scale up ReplicaSet mới. Điều này phụ thuộc vào các tham số rollingUpdate (cụ thể là maxUnavailable) mà bạn đã chỉ định. Theo mặc định, Kubernetes đặt giá trị này là 25%.
Lấy mô tả của Deployment:
kubectl describe deployment
Kết quả tương tự như sau:
Name:           nginx-deployment
Namespace:      default
CreationTimestamp:  Tue, 15 Mar 2016 14:48:04 -0700
Labels:         app=nginx
Selector:       app=nginx
Replicas:       3 desired | 1 updated | 4 total | 3 available | 1 unavailable
StrategyType:       RollingUpdate
MinReadySeconds:    0
RollingUpdateStrategy:  25% max unavailable, 25% max surge
Pod Template:
  Labels:  app=nginx
  Containers:
   nginx:
    Image:        nginx:1.161
    Port:         80/TCP
    Host Port:    0/TCP
    Environment:  <none>
    Mounts:       <none>
  Volumes:        <none>
Conditions:
  Type           Status  Reason
  ----           ------  ------
  Available      True    MinimumReplicasAvailable
  Progressing    True    ReplicaSetUpdated
OldReplicaSets:     nginx-deployment-1564180365 (3/3 replicas created)
NewReplicaSet:      nginx-deployment-3066724191 (1/1 replicas created)
Events:
  FirstSeen LastSeen    Count   From                    SubObjectPath   Type        Reason              Message
  --------- --------    -----   ----                    -------------   --------    ------              -------
  1m        1m          1       {deployment-controller }                Normal      ScalingReplicaSet   Scaled up replica set nginx-deployment-2035384211 to 3
  22s       22s         1       {deployment-controller }                Normal      ScalingReplicaSet   Scaled up replica set nginx-deployment-1564180365 to 1
  22s       22s         1       {deployment-controller }                Normal      ScalingReplicaSet   Scaled down replica set nginx-deployment-2035384211 to 2
  22s       22s         1       {deployment-controller }                Normal      ScalingReplicaSet   Scaled up replica set nginx-deployment-1564180365 to 2
  21s       21s         1       {deployment-controller }                Normal      ScalingReplicaSet   Scaled down replica set nginx-deployment-2035384211 to 1
  21s       21s         1       {deployment-controller }                Normal      ScalingReplicaSet   Scaled up replica set nginx-deployment-1564180365 to 3
  13s       13s         1       {deployment-controller }                Normal      ScalingReplicaSet   Scaled down replica set nginx-deployment-2035384211 to 0
  13s       13s         1       {deployment-controller }                Normal      ScalingReplicaSet   Scaled up replica set nginx-deployment-3066724191 to 1
Để khắc phục điều này, bạn cần rollback về một revision ổn định trước đó của Deployment.
Kiểm tra lịch sử rollout của một Deployment
Làm theo các bước dưới đây để kiểm tra lịch sử rollout:
Đầu tiên, kiểm tra các revision của Deployment này:
kubectl rollout history deployment/nginx-deployment
CHANGE-CAUSE được sao chép từ annotation kubernetes.io/change-cause của Deployment sang các revision của nó khi chúng được tạo. Bạn có thể chỉ định thông điệp CHANGE-CAUSE bằng cách:
Gắn annotation cho Deployment bằng kubectl annotate deployment/nginx-deployment kubernetes.io/change-cause="image updated to 1.16.1"
Sửa manifest của tài nguyên một cách thủ công.
Sử dụng công cụ tự động đặt annotation.
Lưu ý:
Trong các phiên bản Kubernetes cũ hơn, bạn có thể dùng cờ --record với các lệnh kubectl để tự động điền trường CHANGE-CAUSE. Cờ này không còn được hỗ trợ (deprecated) và sẽ bị loại bỏ trong một bản phát hành tương lai.
Để xem chi tiết của từng revision, chạy:
kubectl rollout history deployment/nginx-deployment --revision=2
Để biết thêm chi tiết về các lệnh liên quan đến rollout, đọc kubectl rollout.
Deployment giờ đã được rollback về một revision ổn định trước đó. Như bạn thấy, một sự kiện DeploymentRollback
cho việc rollback về revision 2 được tạo ra từ Deployment controller.
Để kiểm tra xem việc rollback đã thành công và Deployment đang chạy như mong đợi hay chưa, chạy:
kubectl get deployment nginx-deployment
Kết quả tương tự như sau:
NAME               READY   UP-TO-DATE   AVAILABLE   AGE
nginx-deployment   3/3     3            3           30m
Lấy mô tả của Deployment:
kubectl describe deployment nginx-deployment
Kết quả tương tự như sau:
Name:                   nginx-deployment
Namespace:              default
CreationTimestamp:      Sun, 02 Sep 2018 18:17:55 -0500
Labels:                 app=nginx
Annotations:            deployment.kubernetes.io/revision=4
Selector:               app=nginx
Replicas:               3 desired | 3 updated | 3 total | 3 available | 0 unavailable
StrategyType:           RollingUpdate
MinReadySeconds:        0
RollingUpdateStrategy:  25% max unavailable, 25% max surge
Pod Template:
  Labels:  app=nginx
  Containers:
   nginx:
    Image:        nginx:1.16.1
    Port:         80/TCP
    Host Port:    0/TCP
    Environment:  <none>
    Mounts:       <none>
  Volumes:        <none>
Conditions:
  Type           Status  Reason
  ----           ------  ------
  Available      True    MinimumReplicasAvailable
  Progressing    True    NewReplicaSetAvailable
OldReplicaSets:  <none>
NewReplicaSet:   nginx-deployment-c4747d96c (3/3 replicas created)
Events:
  Type    Reason              Age   From                   Message
  ----    ------              ----  ----                   -------
  Normal  ScalingReplicaSet   12m   deployment-controller  Scaled up replica set nginx-deployment-75675f5897 to 3
  Normal  ScalingReplicaSet   11m   deployment-controller  Scaled up replica set nginx-deployment-c4747d96c to 1
  Normal  ScalingReplicaSet   11m   deployment-controller  Scaled down replica set nginx-deployment-75675f5897 to 2
  Normal  ScalingReplicaSet   11m   deployment-controller  Scaled up replica set nginx-deployment-c4747d96c to 2
  Normal  ScalingReplicaSet   11m   deployment-controller  Scaled down replica set nginx-deployment-75675f5897 to 1
  Normal  ScalingReplicaSet   11m   deployment-controller  Scaled up replica set nginx-deployment-c4747d96c to 3
  Normal  ScalingReplicaSet   11m   deployment-controller  Scaled down replica set nginx-deployment-75675f5897 to 0
  Normal  ScalingReplicaSet   11m   deployment-controller  Scaled up replica set nginx-deployment-595696685f to 1
  Normal  DeploymentRollback  15s   deployment-controller  Rolled back deployment "nginx-deployment" to revision 2
  Normal  ScalingReplicaSet   15s   deployment-controller  Scaled down replica set nginx-deployment-595696685f to 0
Giả sử horizontal Pod autoscaling đã được bật
trong cluster của bạn, bạn có thể thiết lập một autoscaler cho Deployment và chọn số lượng Pod tối thiểu và tối đa
mà bạn muốn chạy dựa trên mức sử dụng CPU của các Pod hiện có.
Các Deployment kiểu RollingUpdate hỗ trợ chạy nhiều phiên bản của một ứng dụng cùng một lúc. Khi bạn
hoặc một autoscaler scale một Deployment RollingUpdate đang ở giữa quá trình rollout (đang diễn ra
hoặc đang tạm dừng), Deployment controller sẽ phân bổ cân đối các replica bổ sung vào các ReplicaSet
đang hoạt động (các ReplicaSet có Pod) để giảm thiểu rủi ro. Điều này được gọi là scale theo tỷ lệ (proportional scaling).
Đảm bảo rằng 10 replica trong Deployment của bạn đang chạy.
kubectl get deploy
Kết quả tương tự như sau:
NAME                 DESIRED   CURRENT   UP-TO-DATE   AVAILABLE   AGE
nginx-deployment     10        10        10           10          50s
Bạn cập nhật sang một image mới mà không thể phân giải được từ bên trong cluster.
kubectl set image deployment/nginx-deployment nginx=nginx:sometag
Kết quả tương tự như sau:
deployment.apps/nginx-deployment image updated
Việc cập nhật image khởi động một rollout mới với ReplicaSet nginx-deployment-1989198191, nhưng rollout này bị chặn do
yêu cầu maxUnavailable mà bạn đã đề cập ở trên. Kiểm tra trạng thái rollout:
kubectl get rs
Kết quả tương tự như sau:
NAME                          DESIRED   CURRENT   READY     AGE
nginx-deployment-1989198191   5         5         0         9s
nginx-deployment-618515232    8         8         8         1m
Sau đó, một yêu cầu scale mới cho Deployment xuất hiện. Autoscaler tăng số replica của Deployment
lên 15. Deployment controller cần quyết định nơi để thêm 5 replica mới này. Nếu bạn không sử dụng
scale theo tỷ lệ, cả 5 replica sẽ được thêm vào ReplicaSet mới. Với scale theo tỷ lệ, bạn
phân bổ các replica bổ sung cho tất cả các ReplicaSet. Phần lớn hơn được chia cho các ReplicaSet có
nhiều replica nhất và phần nhỏ hơn được chia cho các ReplicaSet có ít replica hơn. Phần dư sẽ được thêm vào
ReplicaSet có nhiều replica nhất. Các ReplicaSet có 0 replica sẽ không được scale up.
Trong ví dụ trên, 3 replica được thêm vào ReplicaSet cũ và 2 replica được thêm vào
ReplicaSet mới. Quá trình rollout cuối cùng sẽ chuyển tất cả các replica sang ReplicaSet mới, với giả định
các replica mới hoạt động bình thường (healthy). Để xác nhận điều này, chạy:
kubectl get deploy
Kết quả tương tự như sau:
NAME                 DESIRED   CURRENT   UP-TO-DATE   AVAILABLE   AGE
nginx-deployment     15        18        7            8           7m
Trạng thái rollout xác nhận cách các replica được thêm vào mỗi ReplicaSet.
kubectl get rs
Kết quả tương tự như sau:
NAME                          DESIRED   CURRENT   READY     AGE
nginx-deployment-1989198191   7         7         0         7m
nginx-deployment-618515232    11        11        11        7m
Tạm dừng và tiếp tục rollout của một Deployment
Khi bạn cập nhật một Deployment, hoặc dự định cập nhật, bạn có thể tạm dừng các rollout
của Deployment đó trước khi kích hoạt một hoặc nhiều cập nhật. Khi
bạn đã sẵn sàng áp dụng các thay đổi đó, bạn tiếp tục các rollout cho
Deployment. Cách làm này cho phép bạn
áp dụng nhiều bản sửa lỗi trong khoảng thời gian giữa lúc tạm dừng và tiếp tục mà không kích hoạt các rollout không cần thiết.
Ví dụ, với một Deployment vừa được tạo:
Lấy thông tin chi tiết của Deployment:
kubectl get deploy
Kết quả tương tự như sau:
NAME      DESIRED   CURRENT   UP-TO-DATE   AVAILABLE   AGE
nginx     3         3         3            3           1m
Lấy trạng thái rollout:
kubectl get rs
Kết quả tương tự như sau:
NAME               DESIRED   CURRENT   READY     AGE
nginx-2142116321   3         3         3         1m
Tạm dừng bằng cách chạy lệnh sau:
kubectl rollout pause deployment/nginx-deployment
Kết quả tương tự như sau:
deployment.apps/nginx-deployment paused
Sau đó cập nhật image của Deployment:
kubectl set image deployment/nginx-deployment nginx=nginx:1.16.1
Kết quả tương tự như sau:
deployment.apps/nginx-deployment image updated
Lưu ý rằng không có rollout mới nào được bắt đầu:
kubectl rollout history deployment/nginx-deployment
Trạng thái ban đầu của Deployment trước khi tạm dừng rollout vẫn tiếp tục hoạt động, nhưng các cập nhật mới cho
Deployment sẽ không có tác dụng chừng nào rollout của Deployment còn đang bị tạm dừng.
Cuối cùng, tiếp tục rollout của Deployment và quan sát một ReplicaSet mới được tạo ra với tất cả các cập nhật mới:
NAME               DESIRED   CURRENT   READY     AGE
nginx-2142116321   0         0         0         2m
nginx-3926361531   3         3         3         28s
Lưu ý:
Bạn không thể rollback một Deployment đang bị tạm dừng cho đến khi bạn tiếp tục (resume) nó.
Trạng thái của Deployment
Một Deployment trải qua nhiều trạng thái khác nhau trong vòng đời của nó. Nó có thể đang tiến triển trong khi
rollout một ReplicaSet mới, có thể hoàn tất, hoặc có thể không tiến triển được.
Deployment đang tiến triển
Kubernetes đánh dấu một Deployment là đang tiến triển (progressing) khi một trong các tác vụ sau được thực hiện:
Deployment tạo một ReplicaSet mới.
Deployment đang scale up ReplicaSet mới nhất của nó.
Deployment đang scale down (các) ReplicaSet cũ hơn của nó.
Các Pod mới trở nên ready hoặc available (ready trong ít nhất MinReadySeconds).
Khi rollout chuyển sang trạng thái “progressing”, Deployment controller thêm một condition với các
thuộc tính sau vào .status.conditions của Deployment:
Bạn có thể theo dõi tiến trình của một Deployment bằng cách sử dụng kubectl rollout status.
Deployment hoàn tất
Kubernetes đánh dấu một Deployment là hoàn tất (complete) khi nó có các đặc điểm sau:
Tất cả các replica liên kết với Deployment đã được cập nhật lên phiên bản mới nhất mà bạn chỉ định, nghĩa là mọi
cập nhật bạn yêu cầu đều đã được hoàn thành.
Tất cả các replica liên kết với Deployment đều sẵn sàng (available).
Không có replica cũ nào của Deployment đang chạy.
Khi rollout chuyển sang trạng thái “complete”, Deployment controller đặt một condition với các
thuộc tính sau vào .status.conditions của Deployment:
type: Progressing
status: "True"
reason: NewReplicaSetAvailable
Condition Progressing này sẽ giữ giá trị trạng thái "True" cho đến khi một rollout mới
được khởi tạo. Condition này vẫn giữ nguyên ngay cả khi tính khả dụng của các replica thay đổi (điều
này thay vào đó sẽ ảnh hưởng đến condition Available).
Bạn có thể kiểm tra xem một Deployment đã hoàn tất hay chưa bằng cách sử dụng kubectl rollout status. Nếu rollout hoàn tất
thành công, kubectl rollout status trả về exit code bằng 0.
kubectl rollout status deployment/nginx-deployment
Kết quả tương tự như sau:
Waiting for rollout to finish: 2 of 3 updated replicas are available...
deployment "nginx-deployment" successfully rolled out
và exit status của kubectl rollout là 0 (thành công):
echo$?
0
Deployment thất bại
Deployment của bạn có thể bị kẹt khi cố gắng triển khai ReplicaSet mới nhất mà không bao giờ hoàn tất. Điều này có thể xảy ra
do một số yếu tố sau:
Không đủ quota
Readiness probe thất bại
Lỗi khi kéo image (image pull)
Không đủ quyền
Limit range
Cấu hình runtime của ứng dụng bị sai
Một cách để phát hiện tình trạng này là chỉ định một tham số thời hạn (deadline) trong spec của Deployment:
(.spec.progressDeadlineSeconds). .spec.progressDeadlineSeconds biểu thị
số giây mà Deployment controller chờ trước khi báo hiệu (trong trạng thái của Deployment) rằng
tiến trình của Deployment đã bị đình trệ.
Lệnh kubectl sau đây thiết lập spec với progressDeadlineSeconds để khiến controller báo cáo
việc rollout của Deployment không có tiến triển sau 10 phút:
Khi vượt quá thời hạn, Deployment controller sẽ thêm một DeploymentCondition với các
thuộc tính sau vào .status.conditions của Deployment:
type: Progressing
status: "False"
reason: ProgressDeadlineExceeded
Condition này cũng có thể thất bại sớm và khi đó được đặt giá trị trạng thái "False" vì các lý do như ReplicaSetCreateError.
Ngoài ra, thời hạn sẽ không còn được tính đến khi rollout của Deployment đã hoàn tất.
Kubernetes không thực hiện bất kỳ hành động nào đối với một Deployment bị đình trệ ngoài việc báo cáo một status condition với
reason: ProgressDeadlineExceeded. Các orchestrator cấp cao hơn có thể tận dụng điều này và hành động tương ứng, ví dụ
như rollback Deployment về phiên bản trước đó.
Lưu ý:
Nếu bạn tạm dừng rollout của một Deployment, Kubernetes không kiểm tra tiến trình so với thời hạn bạn đã chỉ định.
Bạn có thể an toàn tạm dừng rollout của một Deployment giữa chừng rồi tiếp tục mà không kích hoạt
condition vượt quá thời hạn.
Bạn có thể gặp phải các lỗi tạm thời với Deployment, do bạn đặt timeout quá thấp hoặc
do bất kỳ loại lỗi nào khác có thể được coi là tạm thời. Ví dụ, giả sử bạn
không đủ quota. Nếu bạn describe Deployment, bạn sẽ thấy phần sau:
kubectl describe deployment nginx-deployment
Kết quả tương tự như sau:
<...>
Conditions:
  Type            Status  Reason
  ----            ------  ------
  Available       True    MinimumReplicasAvailable
  Progressing     True    ReplicaSetUpdated
  ReplicaFailure  True    FailedCreate
<...>
Nếu bạn chạy kubectl get deployment nginx-deployment -o yaml, trạng thái của Deployment tương tự như sau:
Cuối cùng, khi vượt quá thời hạn tiến trình của Deployment, Kubernetes sẽ cập nhật trạng thái và
lý do (reason) của condition Progressing:
Conditions:
  Type            Status  Reason
  ----            ------  ------
  Available       True    MinimumReplicasAvailable
  Progressing     False   ProgressDeadlineExceeded
  ReplicaFailure  True    FailedCreate
Bạn có thể giải quyết vấn đề thiếu quota bằng cách scale down Deployment, scale down các
controller khác mà bạn đang chạy, hoặc tăng quota trong namespace của bạn. Nếu bạn đáp ứng các điều kiện
về quota và sau đó Deployment controller hoàn tất rollout của Deployment, bạn sẽ thấy
trạng thái của Deployment được cập nhật với một condition thành công (status: "True" và reason: NewReplicaSetAvailable).
Conditions:
  Type          Status  Reason
  ----          ------  ------
  Available     True    MinimumReplicasAvailable
  Progressing   True    NewReplicaSetAvailable
type: Available với status: "True" nghĩa là Deployment của bạn đạt mức khả dụng tối thiểu (minimum availability). Mức khả dụng tối thiểu được quyết định
bởi các tham số được chỉ định trong chiến lược triển khai (deployment strategy). type: Progressing với status: "True" nghĩa là Deployment của bạn
hoặc đang ở giữa quá trình rollout và đang tiến triển, hoặc đã hoàn tất tiến trình thành công và số lượng replica mới tối thiểu
cần thiết đã sẵn sàng (xem Reason của condition để biết chi tiết - trong trường hợp của chúng ta,
reason: NewReplicaSetAvailable nghĩa là Deployment đã hoàn tất).
Bạn có thể kiểm tra xem một Deployment có bị thất bại trong việc tiến triển hay không bằng cách sử dụng kubectl rollout status. kubectl rollout status
trả về exit code khác 0 nếu Deployment đã vượt quá thời hạn tiến trình.
kubectl rollout status deployment/nginx-deployment
Kết quả tương tự như sau:
Waiting for rollout to finish: 2 out of 3 new replicas have been updated...
error: deployment "nginx" exceeded its progress deadline
và exit status của kubectl rollout là 1 (cho biết có lỗi):
echo$?
1
Thao tác trên một Deployment thất bại
Tất cả các thao tác áp dụng cho một Deployment hoàn tất cũng áp dụng cho một Deployment thất bại. Bạn có thể scale up/down, rollback
về một revision trước đó, hoặc thậm chí tạm dừng nó nếu bạn cần áp dụng nhiều điều chỉnh cho Pod template của Deployment.
Chính sách dọn dẹp
Bạn có thể đặt trường .spec.revisionHistoryLimit trong một Deployment để chỉ định số lượng ReplicaSet cũ của
Deployment này mà bạn muốn giữ lại. Phần còn lại sẽ được thu gom rác (garbage-collected) ở chế độ nền. Theo mặc định,
giá trị này là 10.
Lưu ý:
Việc đặt tường minh trường này bằng 0 sẽ dẫn đến việc dọn sạch toàn bộ lịch sử của Deployment,
do đó Deployment đó sẽ không thể rollback.
Việc dọn dẹp chỉ bắt đầu sau khi Deployment đạt
trạng thái hoàn tất.
Nếu bạn đặt .spec.revisionHistoryLimit bằng 0, mọi rollout vẫn kích hoạt việc tạo một
ReplicaSet mới trước khi Kubernetes xóa ReplicaSet cũ.
Ngay cả khi giới hạn lịch sử revision khác 0, bạn vẫn có thể có nhiều ReplicaSet hơn giới hạn
mà bạn cấu hình. Ví dụ, nếu các Pod bị crash liên tục (crash looping) và có nhiều sự kiện rolling update
được kích hoạt theo thời gian, bạn có thể có nhiều ReplicaSet hơn
.spec.revisionHistoryLimit vì Deployment không bao giờ đạt trạng thái hoàn tất.
Canary deployment
Nếu bạn muốn rollout các bản phát hành (release) cho một nhóm nhỏ người dùng hoặc máy chủ bằng Deployment, bạn
có thể tạo nhiều Deployment, mỗi Deployment tương ứng với một bản phát hành, theo mô hình canary được mô tả trong
quản lý tài nguyên.
Giống như mọi cấu hình Kubernetes khác, một Deployment cần các trường .apiVersion, .kind và .metadata.
Để biết thông tin chung về cách làm việc với các file cấu hình, xem
triển khai ứng dụng,
cấu hình container, và sử dụng kubectl để quản lý tài nguyên.
Khi control plane tạo các Pod mới cho một Deployment, .metadata.name của
Deployment là một phần cơ sở để đặt tên cho các Pod đó. Tên của Deployment phải là một giá trị
DNS subdomain
hợp lệ, nhưng điều này có thể gây ra kết quả không mong muốn cho hostname của Pod. Để tương thích tốt nhất,
tên nên tuân theo các quy tắc chặt chẽ hơn của một
DNS label.
.spec.template và .spec.selector là các trường bắt buộc duy nhất của .spec.
.spec.template là một Pod template. Nó có schema giống hệt một Pod, ngoại trừ việc nó được lồng bên trong và không có apiVersion hay kind.
Ngoài các trường bắt buộc của một Pod, Pod template trong một Deployment phải chỉ định các
label và một restart policy phù hợp. Với label, hãy đảm bảo không trùng lặp với các controller khác. Xem selector.
.spec.replicas là một trường tùy chọn, chỉ định số lượng Pod mong muốn. Giá trị mặc định là 1.
Nếu bạn scale một Deployment thủ công, ví dụ qua kubectl scale deployment deployment --replicas=X, rồi sau đó cập nhật Deployment đó dựa trên một manifest
(ví dụ: bằng cách chạy kubectl apply -f deployment.yaml),
thì việc áp dụng manifest đó sẽ ghi đè lên việc scale thủ công mà bạn đã thực hiện trước đó.
Nếu một HorizontalPodAutoscaler (hoặc bất kỳ
API tương tự nào cho horizontal scaling) đang quản lý việc scale cho một Deployment, đừng đặt .spec.replicas.
Thay vào đó, hãy để
control plane của Kubernetes tự động quản lý
trường .spec.replicas.
Selector
.spec.selector là một trường bắt buộc, chỉ định một label selector
cho các Pod mà Deployment này nhắm tới.
.spec.selector phải khớp với .spec.template.metadata.labels, nếu không sẽ bị API từ chối.
Trong phiên bản API apps/v1, .spec.selector và .metadata.labels không mặc định lấy giá trị của .spec.template.metadata.labels nếu không được đặt. Vì vậy chúng phải được đặt một cách tường minh. Cũng lưu ý rằng trong apps/v1, .spec.selector là bất biến sau khi Deployment được tạo.
Một Deployment có thể dừng (terminate) các Pod có label khớp với selector nếu template của chúng khác
với .spec.template hoặc nếu tổng số lượng các Pod như vậy vượt quá .spec.replicas. Nó sẽ khởi chạy các Pod mới
với .spec.template nếu số lượng Pod ít hơn số lượng mong muốn.
Lưu ý:
Bạn không nên tạo các Pod khác có label khớp với selector này, dù là trực tiếp, bằng cách tạo
một Deployment khác, hay bằng cách tạo một controller khác như ReplicaSet hoặc ReplicationController. Nếu bạn
làm vậy, Deployment đầu tiên sẽ cho rằng chính nó đã tạo ra các Pod khác này. Kubernetes không ngăn bạn làm điều này.
Nếu bạn có nhiều controller có selector trùng lặp nhau, các controller đó sẽ tranh chấp với nhau
và sẽ không hoạt động đúng.
Strategy
.spec.strategy chỉ định chiến lược được sử dụng để thay thế các Pod cũ bằng các Pod mới.
.spec.strategy.type có thể là "Recreate" hoặc "RollingUpdate". "RollingUpdate" là
giá trị mặc định.
Recreate Deployment
Khi .spec.strategy.type==Recreate, tất cả các Pod hiện có sẽ bị dừng trước khi các Pod mới được tạo.
Lưu ý:
Điều này chỉ đảm bảo các Pod bị dừng trước khi tạo Pod mới đối với các lần nâng cấp. Nếu bạn nâng cấp một Deployment, tất cả các Pod
của revision cũ sẽ bị dừng ngay lập tức. Hệ thống chờ việc xóa thành công rồi mới tạo bất kỳ Pod nào của
revision mới. Nếu bạn xóa thủ công một Pod, vòng đời của nó do ReplicaSet kiểm soát và
Pod thay thế sẽ được tạo ngay lập tức (ngay cả khi Pod cũ vẫn đang ở trạng thái Terminating). Nếu bạn cần
đảm bảo "tối đa" (at most) cho các Pod của mình, bạn nên cân nhắc sử dụng một
StatefulSet.
Rolling Update Deployment
Deployment cập nhật các Pod theo kiểu rolling update
(scale down dần các ReplicaSet cũ và scale up ReplicaSet mới) khi .spec.strategy.type==RollingUpdate. Bạn có thể chỉ định maxUnavailable và maxSurge để kiểm soát
quá trình rolling update.
Max Unavailable
.spec.strategy.rollingUpdate.maxUnavailable là một trường tùy chọn, chỉ định số lượng Pod tối đa
có thể không khả dụng (unavailable) trong quá trình cập nhật. Giá trị có thể là một số tuyệt đối (ví dụ: 5)
hoặc tỷ lệ phần trăm của số Pod mong muốn (ví dụ: 10%). Số tuyệt đối được tính từ tỷ lệ phần trăm bằng cách
làm tròn xuống. Giá trị này không thể bằng 0 nếu .spec.strategy.rollingUpdate.maxSurge bằng 0. Giá trị mặc định là 25%.
Ví dụ, khi giá trị này được đặt là 30%, ReplicaSet cũ có thể được scale down xuống còn 70% số Pod
mong muốn ngay khi rolling update bắt đầu. Khi các Pod mới đã sẵn sàng, ReplicaSet cũ có thể được scale
down thêm, tiếp theo là scale up ReplicaSet mới, đảm bảo rằng tổng số Pod khả dụng
tại mọi thời điểm trong quá trình cập nhật luôn ít nhất bằng 70% số Pod mong muốn.
Max Surge
.spec.strategy.rollingUpdate.maxSurge là một trường tùy chọn, chỉ định số lượng Pod tối đa
có thể được tạo vượt quá số lượng Pod mong muốn. Giá trị có thể là một số tuyệt đối (ví dụ: 5) hoặc
tỷ lệ phần trăm của số Pod mong muốn (ví dụ: 10%). Giá trị này không thể bằng 0 nếu maxUnavailable bằng 0. Số tuyệt đối
được tính từ tỷ lệ phần trăm bằng cách làm tròn lên. Giá trị mặc định là 25%.
Ví dụ, khi giá trị này được đặt là 30%, ReplicaSet mới có thể được scale up ngay khi
rolling update bắt đầu, sao cho tổng số Pod cũ và mới không vượt quá 130% số Pod
mong muốn. Khi các Pod cũ đã bị dừng, ReplicaSet mới có thể được scale up thêm, đảm bảo rằng
tổng số Pod đang chạy tại mọi thời điểm trong quá trình cập nhật tối đa là 130% số Pod mong muốn.
Dưới đây là một số ví dụ về Rolling Update Deployment sử dụng maxUnavailable và maxSurge:
.spec.progressDeadlineSeconds là một trường tùy chọn, chỉ định số giây bạn muốn
chờ Deployment tiến triển trước khi hệ thống báo cáo rằng Deployment đã
không tiến triển được - được thể hiện dưới dạng một condition với type: Progressing, status: "False".
và reason: ProgressDeadlineExceeded trong trạng thái của tài nguyên. Deployment controller sẽ tiếp tục
thử lại Deployment. Giá trị mặc định là 600.
Nếu được chỉ định, trường này cần lớn hơn .spec.minReadySeconds.
Min Ready Seconds
.spec.minReadySeconds là một trường tùy chọn, chỉ định số giây tối thiểu mà một Pod mới
được tạo phải ở trạng thái ready mà không có container nào bị crash, để được coi là available (khả dụng).
Giá trị mặc định là 0 (Pod sẽ được coi là available ngay khi nó ready). Để tìm hiểu thêm về thời điểm
một Pod được coi là ready, xem Container Probes.
Các Pod đang dừng (terminating)
TRẠNG THÁI TÍNH NĂNG:Beta since Kubernetes v1.35; enabled by default
Các Pod chuyển sang trạng thái đang dừng do bị xóa hoặc do scale down có thể mất nhiều thời gian để dừng hẳn, và có thể tiêu tốn
thêm tài nguyên trong khoảng thời gian đó. Do đó, tổng số Pod có thể tạm thời vượt quá
.spec.replicas. Bạn có thể theo dõi các Pod đang dừng bằng trường .status.terminatingReplicas của Deployment.
Revision History Limit
Lịch sử revision của một Deployment được lưu trữ trong các ReplicaSet mà nó kiểm soát.
.spec.revisionHistoryLimit là một trường tùy chọn, chỉ định số lượng ReplicaSet cũ được giữ lại
để cho phép rollback. Các ReplicaSet cũ này tiêu tốn tài nguyên trong etcd và làm rối kết quả của kubectl get rs. Cấu hình của mỗi revision Deployment được lưu trữ trong các ReplicaSet của nó; do đó, một khi ReplicaSet cũ bị xóa, bạn sẽ mất khả năng rollback về revision đó của Deployment. Theo mặc định, 10 ReplicaSet cũ sẽ được giữ lại, tuy nhiên giá trị lý tưởng của trường này phụ thuộc vào tần suất và độ ổn định của các Deployment mới.
Cụ thể hơn, việc đặt trường này bằng 0 có nghĩa là tất cả các ReplicaSet cũ có 0 replica sẽ bị dọn dẹp.
Trong trường hợp này, không thể hoàn tác (undo) một rollout mới của Deployment, vì lịch sử revision của nó đã bị dọn dẹp.
Paused
.spec.paused là một trường boolean tùy chọn dùng để tạm dừng và tiếp tục một Deployment. Điểm khác biệt duy nhất giữa
một Deployment đang tạm dừng và một Deployment không bị tạm dừng là mọi thay đổi đối với PodTemplateSpec của Deployment
đang tạm dừng sẽ không kích hoạt rollout mới chừng nào nó còn đang bị tạm dừng. Theo mặc định, một Deployment không bị tạm dừng khi
được tạo.
Cung cấp một ứng dụng đang chạy trong cluster của bạn qua một endpoint duy nhất hướng ra bên ngoài, ngay cả khi workload được chia thành nhiều backend.
Trong Kubernetes, Service là một cách để thể hiện ứng dụng đang chạy trong một tập các Pods dưới dạng dịch vụ mạng.
Một mục tiêu chính của Service trong Kubernetes là bạn không cần sửa đổi ứng dụng hiện có
để dùng một cơ chế service discovery xa lạ.
Bạn có thể chạy code trong các Pod, dù đó là code được thiết kế cho thế giới cloud-native hay
một ứng dụng cũ mà bạn đã container hóa. Bạn dùng Service để cung cấp tập Pod đó
trên mạng, nhờ vậy các client có thể tương tác với nó.
Nếu bạn dùng một Deployment để chạy ứng dụng,
Deployment đó có thể tạo và hủy các Pod một cách linh hoạt. Từ thời điểm này sang thời điểm khác,
bạn không biết có bao nhiêu Pod trong số đó đang hoạt động và khỏe mạnh; thậm chí bạn có thể không biết
tên của các Pod khỏe mạnh đó.
Các Pod trong Kubernetes được tạo và hủy
để khớp với trạng thái mong muốn của cluster. Pod là tài nguyên tạm thời (bạn không nên
kỳ vọng rằng một Pod riêng lẻ là đáng tin cậy và bền vững).
Mỗi Pod có địa chỉ IP riêng (Kubernetes yêu cầu các plugin mạng đảm bảo điều này).
Với một Deployment nhất định trong cluster, tập Pod đang chạy tại một thời điểm
có thể khác với tập Pod chạy ứng dụng đó ngay sau đó.
Điều này dẫn đến một vấn đề: nếu một tập Pod (gọi là "backend") cung cấp
chức năng cho các Pod khác (gọi là "frontend") bên trong cluster,
làm thế nào để các frontend tìm ra và theo dõi được địa chỉ IP cần kết nối tới,
để frontend có thể sử dụng phần backend của workload?
Đó là lúc Service xuất hiện.
Service trong Kubernetes
Service API, một phần của Kubernetes, là một lớp trừu tượng giúp bạn cung cấp các nhóm
Pod qua mạng. Mỗi đối tượng Service định nghĩa một tập logic các endpoint (thường
các endpoint này là Pod) cùng với một chính sách về cách cho phép truy cập các pod đó.
Ví dụ, hãy xem xét một backend xử lý hình ảnh stateless đang chạy với
3 bản sao. Các bản sao đó có thể thay thế cho nhau—frontend không quan tâm chúng dùng
backend nào. Mặc dù các Pod thực tế tạo nên tập backend có thể thay đổi, các
client frontend không cần biết điều đó, cũng không cần tự theo dõi
tập backend.
Lớp trừu tượng Service cho phép sự tách rời (decoupling) này.
Tập Pod mà một Service nhắm tới thường được xác định
bởi một selector mà bạn
định nghĩa.
Để tìm hiểu các cách khác để định nghĩa endpoint cho Service,
xem Service không có selector.
Nếu workload của bạn giao tiếp qua HTTP, bạn có thể chọn dùng một
Ingress để kiểm soát cách lưu lượng web
đến được workload đó.
Ingress không phải là một loại Service, nhưng nó đóng vai trò điểm vào cho
cluster của bạn. Ingress cho phép bạn gom các quy tắc định tuyến vào một tài nguyên duy nhất, để
bạn có thể cung cấp nhiều thành phần của workload, chạy riêng biệt trong
cluster, phía sau một listener duy nhất.
API Gateway dành cho Kubernetes
cung cấp thêm các khả năng ngoài Ingress và Service. Bạn có thể thêm Gateway vào cluster -
đây là một họ các API mở rộng, được triển khai bằng
CustomResourceDefinition -
rồi dùng chúng để cấu hình quyền truy cập tới các dịch vụ mạng đang chạy trong cluster.
Service discovery theo kiểu cloud-native
Nếu ứng dụng của bạn có thể dùng Kubernetes API cho service discovery,
bạn có thể truy vấn API server
để lấy các EndpointSlice tương ứng. Kubernetes cập nhật các EndpointSlice của một Service
mỗi khi tập Pod trong Service đó thay đổi.
Với các ứng dụng không phải native, Kubernetes cung cấp các cách để đặt một cổng mạng hoặc bộ cân bằng tải (load
balancer) giữa ứng dụng của bạn và các Pod backend.
Dù bằng cách nào, workload của bạn đều có thể dùng các cơ chế service discovery
này để tìm đích mà nó muốn kết nối tới.
Định nghĩa một Service
Service là một đối tượng
(giống như Pod hay ConfigMap là đối tượng). Bạn có thể tạo,
xem hoặc sửa đổi định nghĩa Service bằng Kubernetes API. Thông thường
bạn dùng một công cụ như kubectl để thực hiện các lệnh gọi API đó thay bạn.
Ví dụ, giả sử bạn có một tập Pod, mỗi Pod lắng nghe trên cổng TCP 9376
và được gắn label app.kubernetes.io/name=MyApp. Bạn có thể định nghĩa một Service để
công bố listener TCP đó:
Áp dụng manifest này sẽ tạo một Service mới tên là "my-service" với
loại Service mặc định là ClusterIP. Service này
nhắm tới cổng TCP 9376 trên bất kỳ Pod nào có label app.kubernetes.io/name: MyApp.
Kubernetes gán cho Service này một địa chỉ IP (cluster IP),
mà cơ chế địa chỉ IP ảo sử dụng. Để biết thêm chi tiết về cơ chế đó,
hãy đọc IP ảo và Service Proxy.
Controller của Service đó liên tục quét tìm các Pod
khớp với selector của nó, rồi thực hiện mọi cập nhật cần thiết cho tập
EndpointSlice của Service.
Một Service có thể ánh xạ bất kỳport đến nào tới một targetPort. Theo mặc định và
để thuận tiện, targetPort được đặt cùng giá trị với trường
port.
Định nghĩa cổng
Định nghĩa cổng trong Pod có tên, và bạn có thể tham chiếu các tên này trong
thuộc tính targetPort của một Service. Ví dụ, ta có thể gắn targetPort
của Service với cổng của Pod theo cách sau:
Cách này vẫn hoạt động ngay cả khi Service có một tập Pod hỗn hợp dùng cùng một
tên đã cấu hình, với cùng một giao thức mạng nhưng ở các số cổng
khác nhau. Điều này mang lại nhiều sự linh hoạt khi triển khai và phát triển
các Service của bạn. Ví dụ, bạn có thể thay đổi số cổng mà các Pod cung cấp
trong phiên bản tiếp theo của phần mềm backend mà không làm gián đoạn client.
Giao thức mặc định của Service là
TCP; bạn cũng có thể
dùng bất kỳ giao thức được hỗ trợ nào khác.
Vì nhiều Service cần cung cấp nhiều hơn một cổng, Kubernetes hỗ trợ
nhiều định nghĩa cổng cho một Service.
Mỗi định nghĩa cổng có thể có cùng protocol, hoặc khác nhau.
Service không có selector
Service thường trừu tượng hóa việc truy cập tới các Pod Kubernetes nhờ selector,
nhưng khi được dùng cùng một tập đối tượng
EndpointSlice
tương ứng và không có selector, Service có thể trừu tượng hóa các loại backend khác,
kể cả những backend chạy bên ngoài cluster.
Ví dụ:
Bạn muốn có một cluster cơ sở dữ liệu bên ngoài trong môi trường production, nhưng trong
môi trường test bạn dùng các cơ sở dữ liệu của riêng mình.
Bạn muốn trỏ Service của mình tới một Service trong một
Namespace khác hoặc trên một cluster khác.
Bạn đang chuyển (migrate) một workload sang Kubernetes. Trong lúc đánh giá cách tiếp cận,
bạn chỉ chạy một phần backend trong Kubernetes.
Trong bất kỳ trường hợp nào ở trên, bạn đều có thể định nghĩa một Service mà không chỉ định
selector để khớp với Pod. Ví dụ:
Vì Service này không có selector, các đối tượng EndpointSlice
tương ứng sẽ không được tạo tự động. Bạn có thể ánh xạ Service
tới địa chỉ mạng và cổng nơi nó đang chạy bằng cách thêm thủ công một đối tượng
EndpointSlice. Ví dụ:
apiVersion:discovery.k8s.io/v1kind:EndpointSlicemetadata:name:my-service-1# theo quy ước, dùng tên của Service# làm tiền tố cho tên của EndpointSlicelabels:# Bạn nên đặt label "kubernetes.io/service-name".# Đặt giá trị của nó khớp với tên của Servicekubernetes.io/service-name:my-serviceaddressType:IPv4ports:- name:http# nên khớp với tên của cổng Service đã định nghĩa ở trênappProtocol:httpprotocol:TCPport:9376endpoints:- addresses:- "10.4.5.6"- addresses:- "10.1.2.3"
EndpointSlice tùy chỉnh
Khi bạn tạo một đối tượng EndpointSlice cho một Service, bạn có thể
dùng bất kỳ tên nào cho EndpointSlice đó. Mỗi EndpointSlice trong một namespace phải có
tên duy nhất. Bạn liên kết một EndpointSlice với một Service bằng cách đặt
labelkubernetes.io/service-name
trên EndpointSlice đó.
Lưu ý:
IP của endpoint không được là: loopback (127.0.0.0/8 với IPv4, ::1/128 với IPv6), hoặc
link-local (169.254.0.0/16 và 224.0.0.0/24 với IPv4, fe80::/64 với IPv6).
Địa chỉ IP của endpoint không thể là cluster IP của các Service Kubernetes khác,
vì kube-proxy không hỗ trợ IP ảo
làm đích đến.
Với một EndpointSlice do chính bạn tạo, hoặc được tạo trong code của bạn,
bạn cũng nên chọn một giá trị cho label
endpointslice.kubernetes.io/managed-by.
Nếu bạn tự viết code controller để quản lý EndpointSlice, hãy cân nhắc dùng một
giá trị tương tự như "my-domain.example/name-of-controller". Nếu bạn dùng một công cụ
bên thứ ba, hãy dùng tên của công cụ đó viết thường toàn bộ, và thay khoảng trắng cùng các dấu
câu khác bằng dấu gạch ngang (-).
Nếu mọi người trực tiếp dùng một công cụ như kubectl để quản lý EndpointSlice,
hãy dùng một tên mô tả việc quản lý thủ công này, chẳng hạn "staff" hoặc
"cluster-admins". Bạn nên
tránh dùng giá trị dành riêng "controller", vì giá trị này xác định các EndpointSlice
do chính control plane của Kubernetes quản lý.
Truy cập một Service không có selector
Việc truy cập một Service không có selector hoạt động giống như khi nó có selector.
Trong ví dụ về Service không có selector,
lưu lượng được định tuyến tới một trong hai endpoint được định nghĩa trong
manifest EndpointSlice: một kết nối TCP tới 10.1.2.3 hoặc 10.4.5.6, trên cổng 9376.
Lưu ý:
Kubernetes API server không cho phép proxy tới các endpoint không được ánh xạ tới
pod. Các thao tác như kubectl port-forward service/<service-name> forwardedPort:servicePort khi service không có
selector sẽ thất bại do ràng buộc này. Điều này ngăn Kubernetes API server
bị dùng làm proxy tới các endpoint mà bên gọi có thể không có quyền truy cập.
Service ExternalName là một trường hợp đặc biệt của Service, không có
selector và dùng tên DNS thay thế. Để biết thêm thông tin, xem
phần ExternalName.
EndpointSlice
TRẠNG THÁI TÍNH NĂNG:GA since Kubernetes v1.21
EndpointSlice là các đối tượng
đại diện cho một tập con (một slice) của các endpoint mạng đứng sau một Service.
Cluster Kubernetes của bạn theo dõi số lượng endpoint mà mỗi EndpointSlice đại diện.
Nếu một Service có nhiều endpoint đến mức chạm tới một ngưỡng, thì
Kubernetes sẽ thêm một EndpointSlice trống khác và lưu thông tin endpoint mới
vào đó.
Theo mặc định, Kubernetes tạo một EndpointSlice mới khi tất cả các EndpointSlice hiện có
đều chứa ít nhất 100 endpoint. Kubernetes không tạo EndpointSlice mới
cho đến khi cần thêm một endpoint nữa.
Xem EndpointSlice để biết thêm
thông tin về API này.
Endpoints (không còn được hỗ trợ)
TRẠNG THÁI TÍNH NĂNG:Đã lỗi thời since Kubernetes v1.33
EndpointSlice API là bước phát triển tiếp theo của API
Endpoints
cũ hơn. Endpoints API không còn được hỗ trợ này có một số vấn đề so với
EndpointSlice:
Nó không hỗ trợ cluster dual-stack.
Nó không chứa thông tin cần thiết để hỗ trợ các tính năng mới hơn, chẳng hạn như
trafficDistribution.
Nó sẽ cắt bớt danh sách endpoint nếu danh sách quá dài để chứa trong một đối tượng duy nhất.
Vì vậy, tất cả client được khuyến nghị dùng
EndpointSlice API thay vì Endpoints.
Endpoint vượt quá sức chứa
Kubernetes giới hạn số lượng endpoint có thể chứa trong một đối tượng Endpoints
duy nhất. Khi một Service có hơn 1000 endpoint phía sau, Kubernetes
cắt bớt dữ liệu trong đối tượng Endpoints. Vì một Service có thể được liên kết
với nhiều hơn một EndpointSlice, giới hạn 1000 endpoint phía sau chỉ
ảnh hưởng đến Endpoints API cũ (legacy).
Trong trường hợp đó, Kubernetes chọn tối đa 1000 endpoint backend khả dĩ để lưu
vào đối tượng Endpoints, và đặt một
chú thích (annotation) trên Endpoints:
endpoints.kubernetes.io/over-capacity: truncated.
Control plane cũng gỡ bỏ chú thích đó nếu số lượng Pod backend giảm xuống dưới 1000.
Lưu lượng vẫn được gửi tới các backend, nhưng mọi cơ chế cân bằng tải dựa vào
Endpoints API cũ chỉ gửi lưu lượng tới tối đa 1000 endpoint trong số các endpoint phía sau hiện có.
Cũng vì giới hạn API đó, bạn không thể cập nhật thủ công một Endpoints để có hơn 1000 endpoint.
Giao thức ứng dụng
TRẠNG THÁI TÍNH NĂNG:GA since Kubernetes v1.20
Trường appProtocol cung cấp một cách để chỉ định giao thức ứng dụng cho
từng cổng của Service. Trường này được dùng làm gợi ý để các bản triển khai (implementation) cung cấp
hành vi phong phú hơn cho các giao thức mà chúng hiểu.
Giá trị của trường này được phản ánh sang các đối tượng
Endpoints và EndpointSlice tương ứng.
Trường này tuân theo cú pháp label chuẩn của Kubernetes. Giá trị hợp lệ là một trong các loại sau:
Với một số Service, bạn cần cung cấp nhiều hơn một cổng.
Kubernetes cho phép bạn cấu hình nhiều định nghĩa cổng trên một đối tượng Service.
Khi dùng nhiều cổng cho một Service, bạn phải đặt tên cho tất cả các cổng
để chúng không bị nhầm lẫn.
Ví dụ:
Cũng như tên trong Kubernetes nói chung, tên cổng
chỉ được chứa ký tự chữ và số viết thường và -. Tên cổng cũng
phải bắt đầu và kết thúc bằng một ký tự chữ hoặc số.
Ví dụ, các tên 123-abc và web là hợp lệ, nhưng 123_abc và -web thì không.
Loại Service
Với một số phần của ứng dụng (ví dụ, frontend), bạn có thể muốn cung cấp
Service trên một địa chỉ IP bên ngoài, có thể truy cập được từ bên ngoài
cluster.
Các loại Service trong Kubernetes cho phép bạn chỉ định loại Service mà bạn muốn.
Cung cấp Service trên một IP nội bộ của cluster. Chọn giá trị này
khiến Service chỉ có thể truy cập được từ bên trong cluster. Đây là
giá trị mặc định nếu bạn không chỉ định rõ type cho Service.
Bạn có thể cung cấp Service ra internet công cộng bằng một
Ingress hoặc một
Gateway.
Cung cấp Service trên IP của mỗi Node tại một cổng tĩnh (NodePort).
Để node port sẵn sàng, Kubernetes thiết lập một địa chỉ cluster IP,
giống như khi bạn yêu cầu một Service có type: ClusterIP.
Cung cấp Service ra bên ngoài bằng một bộ cân bằng tải bên ngoài. Kubernetes
không trực tiếp cung cấp thành phần cân bằng tải; bạn phải tự cung cấp, hoặc
tích hợp cluster Kubernetes của bạn với một nhà cung cấp dịch vụ đám mây (cloud provider).
Ánh xạ Service tới nội dung của trường externalName (ví dụ,
tới hostname api.foo.bar.example). Việc ánh xạ này cấu hình máy chủ DNS của cluster
trả về một bản ghi CNAME với giá trị hostname bên ngoài đó.
Không có bất kỳ hình thức proxy nào được thiết lập.
Trường type trong Service API được thiết kế theo dạng chức năng lồng nhau - mỗi cấp
bổ sung thêm vào cấp trước. Tuy nhiên có một ngoại lệ đối với thiết kế lồng nhau này. Bạn có thể
định nghĩa một Service LoadBalancer bằng cách
tắt việc cấp phát NodePort cho bộ cân bằng tải.
type: ClusterIP
Loại Service mặc định này gán một địa chỉ IP từ một nhóm (pool) địa chỉ IP mà
cluster của bạn đã dành riêng cho mục đích đó.
Một số loại Service khác được xây dựng dựa trên loại ClusterIP làm
nền tảng.
Nếu bạn định nghĩa một Service có .spec.clusterIP được đặt thành "None" thì
Kubernetes sẽ không gán địa chỉ IP. Xem headless Service
để biết thêm thông tin.
Tự chọn địa chỉ IP
Bạn có thể chỉ định địa chỉ cluster IP của riêng mình như một phần của yêu cầu tạo
Service. Để làm điều này, hãy đặt trường .spec.clusterIP. Ví dụ, khi bạn
đã có sẵn một bản ghi DNS muốn tái sử dụng, hoặc có các hệ thống cũ (legacy)
được cấu hình cho một địa chỉ IP cụ thể và khó cấu hình lại.
Địa chỉ IP bạn chọn phải là một địa chỉ IPv4 hoặc IPv6 hợp lệ nằm trong
dải CIDR service-cluster-ip-range được cấu hình cho API server.
Nếu bạn cố tạo một Service với giá trị địa chỉ clusterIP không hợp lệ, API
server sẽ trả về mã trạng thái HTTP 422 để báo rằng có vấn đề.
Đọc tránh xung đột
để tìm hiểu cách Kubernetes giúp giảm rủi ro và tác động khi hai Service khác nhau
cùng cố dùng một địa chỉ IP.
type: NodePort
Nếu bạn đặt trường type thành NodePort, control plane của Kubernetes
cấp phát một cổng từ dải được chỉ định bởi cờ --service-node-port-range (mặc định: 30000-32767).
Mỗi node proxy cổng đó (cùng một số cổng trên mọi Node) vào Service của bạn.
Service của bạn báo cáo cổng đã được cấp phát trong trường .spec.ports[*].nodePort.
Dùng NodePort cho bạn sự tự do trong việc thiết lập giải pháp cân bằng tải của riêng mình,
cấu hình các môi trường mà Kubernetes chưa hỗ trợ đầy đủ, hoặc thậm chí
cung cấp trực tiếp địa chỉ IP của một hay nhiều node.
Với một Service node port, Kubernetes cấp phát thêm một cổng (TCP, UDP hoặc
SCTP, khớp với giao thức của Service). Mọi node trong cluster tự cấu hình
để lắng nghe trên cổng được gán đó và chuyển tiếp lưu lượng tới một trong các endpoint
sẵn sàng (ready) liên kết với Service đó. Bạn có thể kết nối tới Service type: NodePort
từ bên ngoài cluster bằng cách kết nối tới bất kỳ node nào với giao thức phù hợp
(ví dụ: TCP) và cổng phù hợp (cổng đã được gán cho Service đó).
Tự chọn cổng
Nếu bạn muốn một số cổng cụ thể, bạn có thể chỉ định giá trị trong trường nodePort.
Control plane sẽ cấp phát cổng đó cho bạn hoặc báo rằng
giao dịch API đã thất bại.
Điều này có nghĩa là bạn cần tự xử lý các xung đột cổng có thể xảy ra.
Bạn cũng phải dùng một số cổng hợp lệ, nằm trong dải được cấu hình
cho NodePort.
Dưới đây là một manifest mẫu cho Service có type: NodePort chỉ định
một giá trị NodePort (trong ví dụ này là 30007):
apiVersion:v1kind:Servicemetadata:name:my-servicespec:type:NodePortselector:app.kubernetes.io/name:MyAppports:- port:80# Theo mặc định và để thuận tiện, `targetPort` được đặt cùng# giá trị với trường `port`.targetPort:80# Trường tùy chọn# Theo mặc định và để thuận tiện, control plane của Kubernetes# sẽ cấp phát một cổng từ một dải (mặc định: 30000-32767)nodePort:30007
Dành riêng dải NodePort để tránh xung đột
Chính sách gán cổng cho các Service NodePort áp dụng cho cả trường hợp gán tự động và
gán thủ công. Khi người dùng muốn tạo một Service NodePort
dùng một cổng cụ thể, cổng đích có thể xung đột với một cổng khác đã được gán.
Để tránh vấn đề này, dải cổng cho các Service NodePort được chia thành hai băng (band).
Việc gán cổng động mặc định dùng băng trên, và có thể dùng băng dưới khi
băng trên đã hết. Khi đó người dùng có thể cấp phát từ băng dưới với rủi ro xung đột cổng thấp hơn.
Khi dùng dải NodePort mặc định 30000-32767, các băng được phân chia như sau:
Khi dùng kube-proxy ở chế độ
iptables, theo mặc định các Service NodePort
khả dụng trên tất cả IP của node. Khi dùng chế độ
nftables, theo mặc định chúng chỉ
khả dụng trên IP chính của node (hoặc các IP chính dual-stack).
Bạn có thể thay đổi tập IP của node mà các Service NodePort khả dụng bằng
cờ --nodeport-addresses của kube-proxy, hoặc trường nodePortAddresses tương đương
trong file cấu hình kube-proxy.
Cờ này chấp nhận một danh sách các khối IP phân tách bằng dấu phẩy (ví dụ 10.0.0.0/8, 192.0.2.0/25) hoặc một
hay nhiều từ khóa sau:
primary - địa chỉ IPv4 và/hoặc IPv6 chính của node, theo đối tượng Node.
(Đây là giá trị mặc định cho chế độ nftables.)
localhost - các địa chỉ loopback của node (127.0.0.0/8, ::1/128).
all - tất cả địa chỉ. (Đây là giá trị mặc định cho chế độ iptables và ipvs.)
Ví dụ, nếu bạn khởi động kube-proxy với cờ --nodeport-addresses=192.168.0.0/24,
thì kube-proxy sẽ cố tìm một địa chỉ IP cục bộ thuộc subnet đó trên mỗi node, và chỉ phục vụ
các Service NodePort qua IP đó.
Service type: NodePort qua localhost
Các cơ chế mà service proxy dùng để triển khai Service NodePort không phải lúc nào cũng
hỗ trợ cung cấp Service NodePort trên localhost. Với kube-proxy:
Khi dùng chế độ iptables, với giá trị --nodeport-addresses có bao gồm
127.0.0.1, các Service NodePort sẽ khả dụng trên 127.0.0.1. Tuy nhiên, điều này
yêu cầu bật một sysctl của kernel (route_localnet) có thể gây ra tác dụng phụ
thiếu an toàn trong một số cluster. Có thể tắt NodePort localhost của IPTables bằng cách truyền
--iptables-localhost-nodeports false cho kube-proxy, hoặc bằng cách đặt
--nodeport-addresses thành một dải không bao gồm 127.0.0.1.
Khi dùng chế độ ipvs, hoặc chế độ iptables trong cluster IPv6 single-stack, Service
NodePort không khả dụng trên localhost.
TRẠNG THÁI TÍNH NĂNG:Alpha since Kubernetes v1.37; disabled by default
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the KubeProxyNFTablesLocalhostNodePorts feature gate for all relevant components in your cluster.
Khi dùng chế độ nftables, Service NodePort sẽ khả dụng trên localhost khi
feature gate KubeProxyNFTablesLocalhostNodePorts được bật, và
--nodeport-addresses được đặt thành một giá trị có bao gồm rõ ràng localhost.
(Chỉ đặt thành all sẽ không bật Service NodePort trên localhost.) Điều này
được triển khai bằng cách chuyển hướng các kết nối NodePort localhost qua một proxy userspace,
nên không hiệu quả bằng việc proxy service thông thường.
Các plugin mạng bên thứ ba có bản triển khai service proxy riêng có thể hỗ trợ hoặc
không hỗ trợ NodePort trên localhost; hãy tham khảo tài liệu của các plugin đó.
type: LoadBalancer
Trên các nhà cung cấp dịch vụ đám mây hỗ trợ bộ cân bằng tải bên ngoài, việc đặt trường type
thành LoadBalancer sẽ cấp phát một bộ cân bằng tải cho Service của bạn.
Việc tạo bộ cân bằng tải thực tế diễn ra bất đồng bộ, và
thông tin về bộ cân bằng tải được cấp phát sẽ được công bố trong trường
.status.loadBalancer của Service.
Ví dụ:
Lưu lượng từ bộ cân bằng tải bên ngoài được chuyển tới các Pod backend. Nhà cung cấp
dịch vụ đám mây quyết định cách cân bằng tải.
Để triển khai một Service type: LoadBalancer, Kubernetes thường bắt đầu
bằng cách thực hiện các thay đổi tương đương với việc bạn yêu cầu một Service
type: NodePort. Sau đó, thành phần cloud-controller-manager cấu hình bộ cân bằng tải
bên ngoài để chuyển tiếp lưu lượng tới node port đã được gán đó.
Bạn có thể cấu hình một Service có cân bằng tải để
bỏ qua việc gán node port, với điều kiện
bản triển khai của nhà cung cấp dịch vụ đám mây hỗ trợ điều này.
Một số nhà cung cấp dịch vụ đám mây cho phép bạn chỉ định loadBalancerIP. Trong những trường hợp đó, bộ cân bằng tải được tạo
với loadBalancerIP do người dùng chỉ định. Nếu trường loadBalancerIP không được chỉ định,
bộ cân bằng tải sẽ được thiết lập với một địa chỉ IP tạm thời. Nếu bạn chỉ định loadBalancerIP
nhưng nhà cung cấp dịch vụ đám mây của bạn không hỗ trợ tính năng này, trường loadbalancerIP mà bạn
đặt sẽ bị bỏ qua.
Lưu ý:
Trường .spec.loadBalancerIP của Service đã không còn được hỗ trợ từ Kubernetes v1.24.
Trường này được đặc tả chưa đầy đủ và ý nghĩa của nó khác nhau giữa các bản triển khai.
Nó cũng không thể hỗ trợ mạng dual-stack. Trường này có thể bị loại bỏ trong một phiên bản API tương lai.
Nếu bạn đang tích hợp với một nhà cung cấp hỗ trợ chỉ định (các) địa chỉ IP của bộ cân bằng tải
cho Service thông qua một chú thích (riêng của nhà cung cấp), bạn nên chuyển sang cách đó.
Nếu bạn đang viết code tích hợp bộ cân bằng tải với Kubernetes, hãy tránh dùng trường này.
Bạn có thể tích hợp với Gateway thay vì Service, hoặc bạn
có thể tự định nghĩa các chú thích (riêng của nhà cung cấp) trên Service để chỉ định thông tin tương đương.
Ảnh hưởng của tình trạng hoạt động (liveness) của node tới lưu lượng bộ cân bằng tải
Kiểm tra sức khỏe (health check) của bộ cân bằng tải đóng vai trò then chốt đối với các ứng dụng hiện đại. Chúng được dùng để
xác định máy chủ nào (máy ảo, hoặc địa chỉ IP) mà bộ cân bằng tải nên
điều phối lưu lượng tới. Kubernetes API không định nghĩa cách triển khai kiểm tra sức khỏe
cho các bộ cân bằng tải do Kubernetes quản lý, thay vào đó các nhà cung cấp dịch vụ đám mây
(và những người viết code tích hợp) sẽ quyết định hành vi. Kiểm tra sức khỏe
của bộ cân bằng tải được sử dụng rộng rãi trong bối cảnh hỗ trợ trường
externalTrafficPolicy của Service.
Bộ cân bằng tải với nhiều loại giao thức
This is a stable feature in Kubernetes, and has been since the 1.26 release. You can no longer toggle this feature (the associated feature gate has been removed).
Theo mặc định, với các Service loại LoadBalancer, khi có nhiều hơn một cổng được định nghĩa, tất cả
các cổng phải có cùng giao thức, và giao thức đó phải được
nhà cung cấp dịch vụ đám mây hỗ trợ.
Feature gate MixedProtocolLBService (được bật mặc định cho kube-apiserver kể từ v1.24) cho phép dùng
các giao thức khác nhau cho các Service loại LoadBalancer khi có nhiều hơn một cổng được định nghĩa.
Lưu ý:
Tập giao thức có thể dùng cho các Service có cân bằng tải do nhà cung cấp
dịch vụ đám mây của bạn định nghĩa; họ có thể áp đặt các hạn chế ngoài những gì Kubernetes API quy định.
Tắt cấp phát NodePort cho bộ cân bằng tải
TRẠNG THÁI TÍNH NĂNG:GA since Kubernetes v1.24
Bạn có thể tùy chọn tắt việc cấp phát node port cho Service type: LoadBalancer bằng cách đặt
trường spec.allocateLoadBalancerNodePorts thành false. Chỉ nên dùng cách này cho các bản triển khai bộ cân bằng tải
định tuyến lưu lượng trực tiếp tới pod thay vì dùng node port. Theo mặc định, spec.allocateLoadBalancerNodePorts
là true và các Service loại LoadBalancer sẽ tiếp tục cấp phát node port. Nếu spec.allocateLoadBalancerNodePorts
được đặt thành false trên một Service hiện có đã được cấp phát node port, các node port đó sẽ không được tự động thu hồi.
Bạn phải xóa rõ ràng mục nodePorts trong từng cổng của Service để thu hồi các node port đó.
Chỉ định class cho bản triển khai bộ cân bằng tải
TRẠNG THÁI TÍNH NĂNG:GA since Kubernetes v1.24
Với một Service có type được đặt thành LoadBalancer, trường .spec.loadBalancerClass
cho phép bạn dùng một bản triển khai bộ cân bằng tải khác với mặc định của nhà cung cấp dịch vụ đám mây.
Theo mặc định, .spec.loadBalancerClass không được đặt và Service loại LoadBalancer
sẽ dùng bản triển khai bộ cân bằng tải mặc định của nhà cung cấp dịch vụ đám mây nếu
cluster được cấu hình với một nhà cung cấp dịch vụ đám mây thông qua cờ
--cloud-provider của thành phần.
Nếu bạn chỉ định .spec.loadBalancerClass, hệ thống giả định rằng có một bản triển khai bộ cân bằng tải
khớp với class đã chỉ định đang theo dõi các Service.
Mọi bản triển khai bộ cân bằng tải mặc định (ví dụ, bản do
nhà cung cấp dịch vụ đám mây cung cấp) sẽ bỏ qua các Service có đặt trường này.
spec.loadBalancerClass chỉ có thể được đặt trên Service loại LoadBalancer.
Một khi đã đặt, giá trị này không thể thay đổi.
Giá trị của spec.loadBalancerClass phải là một định danh dạng label,
với tiền tố tùy chọn như "internal-vip" hoặc "example.com/internal-vip".
Các tên không có tiền tố được dành riêng cho người dùng cuối.
Chế độ địa chỉ IP của bộ cân bằng tải
Với một Service type: LoadBalancer, controller có thể đặt .status.loadBalancer.ingress.ipMode.
.status.loadBalancer.ingress.ipMode chỉ định cách IP của bộ cân bằng tải hoạt động.
Trường này chỉ có thể được chỉ định khi trường .status.loadBalancer.ingress.ip cũng được chỉ định.
Có hai giá trị khả dĩ cho .status.loadBalancer.ingress.ipMode: "VIP" và "Proxy".
Giá trị mặc định là "VIP", nghĩa là lưu lượng được chuyển tới node
với đích được đặt là IP và cổng của bộ cân bằng tải.
Có hai trường hợp khi đặt giá trị này thành "Proxy", tùy thuộc vào cách bộ cân bằng tải
của nhà cung cấp dịch vụ đám mây chuyển lưu lượng:
Nếu lưu lượng được chuyển tới node rồi được DNAT tới pod, đích sẽ được đặt là IP và node port của node;
Nếu lưu lượng được chuyển trực tiếp tới pod, đích sẽ được đặt là IP và cổng của pod.
Các bản triển khai Service có thể dùng thông tin này để điều chỉnh việc định tuyến lưu lượng.
Bộ cân bằng tải nội bộ
Trong một môi trường hỗn hợp, đôi khi cần định tuyến lưu lượng từ các Service bên trong cùng một
khối địa chỉ mạng (ảo).
Trong môi trường DNS split-horizon, bạn sẽ cần hai Service để có thể định tuyến cả lưu lượng bên ngoài
lẫn bên trong tới các endpoint của mình.
Để thiết lập một bộ cân bằng tải nội bộ, hãy thêm một trong các chú thích sau vào Service
tùy theo nhà cung cấp dịch vụ đám mây mà bạn đang dùng:
Service loại ExternalName ánh xạ một Service tới một tên DNS, chứ không phải tới một selector thông thường như
my-service hay cassandra. Bạn chỉ định các Service này bằng tham số spec.externalName.
Ví dụ, định nghĩa Service sau ánh xạ
Service my-service trong namespace prod tới my.database.example.com:
Service type: ExternalName chấp nhận một chuỗi địa chỉ IPv4,
nhưng xử lý chuỗi đó như một tên DNS gồm các chữ số,
chứ không phải như một địa chỉ IP (tuy nhiên internet không cho phép những tên như vậy trong DNS).
Các Service có tên bên ngoài trông giống địa chỉ
IPv4 sẽ không được các máy chủ DNS phân giải.
Nếu bạn muốn ánh xạ trực tiếp một Service tới một địa chỉ IP cụ thể, hãy cân nhắc dùng
headless Service.
Khi tra cứu host my-service.prod.svc.cluster.local, DNS Service của cluster
trả về một bản ghi CNAME với giá trị my.database.example.com. Việc truy cập
my-service hoạt động giống như các Service khác nhưng có điểm khác biệt
quan trọng là việc chuyển hướng diễn ra ở mức DNS thay vì qua proxy hay
chuyển tiếp. Nếu sau này bạn quyết định chuyển cơ sở dữ liệu vào trong cluster, bạn
có thể khởi chạy các Pod của nó, thêm các selector hoặc endpoint phù hợp, và thay đổi
type của Service.
Chú ý:
Bạn có thể gặp khó khăn khi dùng ExternalName với một số giao thức phổ biến, bao gồm HTTP và HTTPS.
Nếu bạn dùng ExternalName thì hostname mà các client bên trong cluster sử dụng sẽ khác với
tên mà ExternalName tham chiếu tới.
Với các giao thức sử dụng hostname, sự khác biệt này có thể dẫn đến lỗi hoặc phản hồi không mong muốn.
Các yêu cầu HTTP sẽ có header Host: mà máy chủ gốc không nhận ra;
các máy chủ TLS sẽ không thể cung cấp chứng chỉ khớp với hostname mà client đã kết nối tới.
Headless Service
Đôi khi bạn không cần cân bằng tải và một IP Service duy nhất. Trong
trường hợp này, bạn có thể tạo cái gọi là headless Service, bằng cách chỉ định rõ
"None" cho địa chỉ cluster IP (.spec.clusterIP).
Bạn có thể dùng headless Service để giao tiếp với các cơ chế service discovery khác
mà không bị ràng buộc vào cách triển khai của Kubernetes.
Với headless Service, cluster IP không được cấp phát, kube-proxy không xử lý
các Service này, và nền tảng không thực hiện cân bằng tải hay proxy cho chúng.
Headless Service cho phép client kết nối trực tiếp tới bất kỳ Pod nào mà nó muốn. Các headless Service không
cấu hình route và chuyển tiếp gói tin bằng
địa chỉ IP ảo và proxy; thay vào đó, headless Service báo cáo
địa chỉ IP endpoint của từng pod thông qua các bản ghi DNS nội bộ, được phục vụ qua
dịch vụ DNS của cluster.
Để định nghĩa một headless Service, bạn tạo một Service với .spec.type được đặt thành ClusterIP (cũng là giá trị mặc định của type),
và đặt thêm .spec.clusterIP thành None.
Giá trị chuỗi None là một trường hợp đặc biệt và không giống với việc để trống trường .spec.clusterIP.
Cách DNS được cấu hình tự động phụ thuộc vào việc Service có định nghĩa selector hay không:
Có selector
Với các headless Service có định nghĩa selector, endpoints controller tạo
các EndpointSlice trong Kubernetes API, và sửa đổi cấu hình DNS để trả về
các bản ghi A hoặc AAAA (địa chỉ IPv4 hoặc IPv6) trỏ trực tiếp tới các Pod đứng sau Service.
Không có selector
Với các headless Service không định nghĩa selector, control plane
không tạo các đối tượng EndpointSlice. Tuy nhiên, hệ thống DNS sẽ tìm và cấu hình
một trong hai:
Bản ghi DNS A / AAAA cho tất cả địa chỉ IP của các endpoint sẵn sàng của Service,
với mọi loại Service ngoài ExternalName.
Với endpoint IPv4, hệ thống DNS tạo bản ghi A.
Với endpoint IPv6, hệ thống DNS tạo bản ghi AAAA.
Khi bạn định nghĩa một headless Service không có selector, port phải
khớp với targetPort.
Tìm kiếm Service
Với các client chạy bên trong cluster, Kubernetes hỗ trợ hai cách chính để
tìm một Service: biến môi trường và DNS.
Biến môi trường
Khi một Pod chạy trên một Node, kubelet thêm một tập biến môi trường
cho mỗi Service đang hoạt động. Nó thêm các biến {SVCNAME}_SERVICE_HOST và {SVCNAME}_SERVICE_PORT,
trong đó tên Service được viết hoa và dấu gạch ngang được chuyển thành dấu gạch dưới.
Ví dụ, Service redis-primary cung cấp cổng TCP 6379 và đã được
cấp phát địa chỉ cluster IP 10.0.0.11 sẽ tạo ra các biến môi trường
sau:
Khi bạn có một Pod cần truy cập một Service, và bạn đang dùng
phương pháp biến môi trường để công bố cổng và cluster IP cho các Pod
client, bạn phải tạo Service trước khi các Pod client được tạo ra.
Nếu không, các biến môi trường của những Pod client đó sẽ không được điền giá trị.
Nếu bạn chỉ dùng DNS để tìm cluster IP của một Service, bạn không cần
lo lắng về vấn đề thứ tự này.
Kubernetes cũng hỗ trợ và cung cấp các biến tương thích với tính năng
"legacy container links" của Docker Engine.
Bạn có thể đọc makeLinkVariables
để xem cách tính năng này được triển khai trong Kubernetes.
DNS
Bạn có thể (và gần như luôn luôn nên) thiết lập một dịch vụ DNS cho cluster Kubernetes
bằng một add-on.
Một máy chủ DNS nhận biết cluster (cluster-aware), chẳng hạn CoreDNS, theo dõi Kubernetes API để phát hiện
các Service mới và tạo một tập bản ghi DNS cho mỗi Service. Nếu DNS đã được bật
trên toàn bộ cluster thì tất cả các Pod sẽ tự động phân giải được
Service theo tên DNS của chúng.
Ví dụ, nếu bạn có một Service tên là my-service trong namespace
Kubernetes my-ns, control plane và DNS Service cùng phối hợp
tạo một bản ghi DNS cho my-service.my-ns. Các Pod trong namespace my-ns
sẽ có thể tìm thấy service bằng cách tra cứu tên my-service
(my-service.my-ns cũng hoạt động).
Các Pod trong namespace khác phải dùng tên đầy đủ my-service.my-ns. Những tên này
sẽ được phân giải thành cluster IP được gán cho Service.
Kubernetes cũng hỗ trợ bản ghi DNS SRV (Service) cho các cổng có tên. Nếu
Service my-service.my-ns có một cổng tên là http với giao thức được đặt thành
TCP, bạn có thể thực hiện truy vấn DNS SRV cho _http._tcp.my-service.my-ns để tìm
số cổng của http, cũng như địa chỉ IP.
Máy chủ DNS của Kubernetes là cách duy nhất để truy cập các Service ExternalName.
Bạn có thể tìm thêm thông tin về việc phân giải ExternalName trong
DNS cho Service và Pod.
Trang IP ảo và Service Proxy giải thích
cơ chế mà Kubernetes dùng để cung cấp một Service qua một địa chỉ IP ảo.
Chính sách lưu lượng
Bạn có thể đặt các trường .spec.internalTrafficPolicy và .spec.externalTrafficPolicy
để kiểm soát cách Kubernetes định tuyến lưu lượng tới các backend khỏe mạnh (“ready”).
Trường .spec.trafficDistribution cung cấp một cách khác để tác động tới việc định tuyến
lưu lượng trong một Service Kubernetes. Trong khi chính sách lưu lượng tập trung vào các đảm bảo
ngữ nghĩa chặt chẽ, phân phối lưu lượng cho phép bạn thể hiện các ưu tiên
(chẳng hạn định tuyến tới các endpoint gần hơn về mặt topo mạng). Điều này có thể giúp tối ưu
hiệu năng, chi phí, hoặc độ tin cậy. Trong Kubernetes 1.37,
các giá trị sau được hỗ trợ:
PreferSameZone
Thể hiện ưu tiên định tuyến lưu lượng tới các endpoint nằm trong cùng
zone với client.
PreferSameNode
Thể hiện ưu tiên định tuyến lưu lượng tới các endpoint nằm trên cùng
node với client.
PreferClose (không còn được hỗ trợ)
Đây là một alias cũ của PreferSameZone, có ngữ nghĩa
kém rõ ràng hơn.
Nếu trường này không được đặt, bản triển khai sẽ áp dụng chiến lược định tuyến mặc định của nó.
Nếu bạn muốn đảm bảo rằng các kết nối từ một client cụ thể luôn được chuyển tới
cùng một Pod, bạn có thể cấu hình session affinity dựa trên địa chỉ IP
của client. Đọc session affinity
để tìm hiểu thêm.
IP bên ngoài (External IP)
TRẠNG THÁI TÍNH NĂNG:Đã lỗi thời since Kubernetes v1.36
Tất cả người dùng nên bắt đầu chuyển dần khỏi externalIPs.
Thay vào đó, hãy cân nhắc dùng một controller bộ cân bằng tải bên ngoài hoặc một bản triển khai
Gateway API.
Nếu có các IP bên ngoài định tuyến tới một hoặc nhiều node của cluster, các Service Kubernetes
có thể được cung cấp trên các externalIPs đó. Khi lưu lượng mạng đi vào cluster với
IP bên ngoài (là IP đích) và cổng khớp với Service đó, các quy tắc và route
mà Kubernetes đã cấu hình sẽ đảm bảo lưu lượng được định tuyến tới một trong các endpoint
của Service đó.
Khi định nghĩa một Service, bạn có thể chỉ định externalIPs cho bất kỳ
loại Service nào.
Trong ví dụ dưới đây, client có thể truy cập Service tên "my-service" qua TCP,
tại "198.51.100.32:80" (được tính từ .spec.externalIPs[] và .spec.ports[].port).
Kubernetes là một nền tảng nguồn mở, khả chuyển, có thể mở rộng để quản lý các ứng dụng được đóng gói và các service, giúp thuận lợi trong việc cấu hình và tự động hoá việc triển khai ứng dụng. Kubernetes là một hệ sinh thái lớn và phát triển nhanh chóng. Các dịch vụ, sự hỗ trợ và công cụ có sẵn rộng rãi.
Chúng ta hãy xem tại sao Kubernetes rất hữu ích bằng cách quay ngược thời gian.
Thời đại triển khai theo cách truyền thống:
Ban đầu, các ứng dụng được chạy trên các máy chủ vật lý. Không có cách nào để xác định ranh giới tài nguyên cho các ứng dụng trong máy chủ vật lý và điều này gây ra sự cố phân bổ tài nguyên. Ví dụ, nếu nhiều ứng dụng cùng chạy trên một máy chủ vật lý, có thể có những trường hợp một ứng dụng sẽ chiếm phần lớn tài nguyên hơn và kết quả là các ứng dụng khác sẽ hoạt động kém đi. Một giải pháp cho điều này sẽ là chạy từng ứng dụng trên một máy chủ vật lý khác nhau. Nhưng giải pháp này không tối ưu vì tài nguyên không được sử dụng đúng mức và rất tốn kém cho các tổ chức để có thể duy trì nhiều máy chủ vật lý như vậy.
Thời đại triển khai ảo hóa: Như một giải pháp, ảo hóa đã được giới thiệu. Nó cho phép bạn chạy nhiều Máy ảo (VM) trên CPU của một máy chủ vật lý. Ảo hóa cho phép các ứng dụng được cô lập giữa các VM và cung cấp mức độ bảo mật vì thông tin của một ứng dụng không thể được truy cập tự do bởi một ứng dụng khác.
Ảo hóa cho phép sử dụng tốt hơn các tài nguyên trong một máy chủ vật lý và cho phép khả năng mở rộng tốt hơn vì một ứng dụng có thể được thêm hoặc cập nhật dễ dàng, giảm chi phí phần cứng và hơn thế nữa. Với ảo hóa, bạn có thể có một tập hợp các tài nguyên vật lý dưới dạng một cụm các máy ảo sẵn dùng.
Mỗi VM là một máy tính chạy tất cả các thành phần, bao gồm cả hệ điều hành riêng của nó, bên trên phần cứng được ảo hóa.
Thời đại triển khai Container: Các container tương tự như VM, nhưng chúng có tính cô lập để chia sẻ Hệ điều hành (HĐH) giữa các ứng dụng. Do đó, container được coi là nhẹ (lightweight). Tương tự như VM, một container có hệ thống tệp (filesystem), CPU, bộ nhớ, process space, v.v. Khi chúng được tách rời khỏi cơ sở hạ tầng bên dưới, chúng có thể khả chuyển (portable) trên cloud hoặc các bản phân phối Hệ điều hành.
Các container đã trở nên phổ biến vì chúng có thêm nhiều lợi ích, chẳng hạn như:
Tạo mới và triển khai ứng dụng Agile: gia tăng tính dễ dàng và hiệu quả của việc tạo các container image so với việc sử dụng VM image.
Phát triển, tích hợp và triển khai liên tục: cung cấp khả năng build và triển khai container image thường xuyên và đáng tin cậy với việc rollbacks dễ dàng, nhanh chóng.
Phân biệt giữa Dev và Ops: tạo các images của các application container tại thời điểm build/release thay vì thời gian triển khai, do đó phân tách các ứng dụng khỏi hạ tầng.
Khả năng quan sát không chỉ hiển thị thông tin và các metric ở mức Hệ điều hành, mà còn cả application health và các tín hiệu khác.
Tính nhất quán về môi trường trong suốt quá trình phát triển, testing và trong production: Chạy tương tự trên laptop như trên cloud.
Tính khả chuyển trên cloud và các bản phân phối HĐH: Chạy trên Ubuntu, RHEL, CoreOS, on-premises, Google Kubernetes Engine và bất kì nơi nào khác.
Quản lý tập trung ứng dụng: Tăng mức độ trừu tượng từ việc chạy một Hệ điều hành trên phần cứng ảo hóa sang chạy một ứng dụng trên một HĐH bằng logical resources.
Các micro-services phân tán, elastic: ứng dụng được phân tách thành các phần nhỏ hơn, độc lập và thể được triển khai và quản lý một cách linh hoạt - chứ không phải một app nguyên khối (monolithic).
Cô lập các tài nguyên: dự đoán hiệu năng ứng dụng
Sử dụng tài nguyên: hiệu quả
Tại sao bạn cần Kubernetes và nó có thể làm những gì?
Các container là một cách tốt để đóng gói và chạy các ứng dụng của bạn. Trong môi trường production, bạn cần quản lý các container chạy các ứng dụng và đảm bảo rằng không có khoảng thời gian downtime. Ví dụ, nếu một container bị tắt đi, một container khác cần phải khởi động lên. Điều này sẽ dễ dàng hơn nếu được xử lý bởi một hệ thống.
Đó là cách Kubernetes đến với chúng ta. Kubernetes cung cấp cho bạn một framework để chạy các hệ phân tán một cách mạnh mẽ. Nó đảm nhiệm việc nhân rộng và chuyển đổi dự phòng cho ứng dụng của bạn, cung cấp các mẫu deployment và hơn thế nữa. Ví dụ, Kubernetes có thể dễ dàng quản lý một triển khai canary cho hệ thống của bạn.
Kubernetes cung cấp cho bạn:
Service discovery và cân bằng tải Kubernetes có thể expose một container sử dụng DNS hoặc địa chỉ IP của riêng nó. Nếu lượng traffic truy cập đến một container cao, Kubernetes có thể cân bằng tải và phân phối lưu lượng mạng (network traffic) để việc triển khai được ổn định.
Điều phối bộ nhớ Kubernetes cho phép bạn tự động mount một hệ thống lưu trữ mà bạn chọn, như local storages, public cloud providers, v.v.
Tự động rollouts và rollbacks Bạn có thể mô tả trạng thái mong muốn cho các container được triển khai dùng Kubernetes và nó có thể thay đổi trạng thái thực tế sang trạng thái mong muốn với tần suất được kiểm soát. Ví dụ, bạn có thể tự động hoá Kubernetes để tạo mới các container cho việc triển khai của bạn, xoá các container hiện có và áp dụng tất cả các resource của chúng vào container mới.
Đóng gói tự động Bạn cung cấp cho Kubernetes một cluster gồm các node mà nó có thể sử dụng để chạy các tác vụ được đóng gói (containerized task). Bạn cho Kubernetes biết mỗi container cần bao nhiêu CPU và bộ nhớ (RAM). Kubernetes có thể điều phối các container đến các node để tận dụng tốt nhất các resource của bạn.
Tự phục hồi Kubernetes khởi động lại các containers bị lỗi, thay thế các container, xoá các container không phản hồi lại cấu hình health check do người dùng xác định và không cho các client biết đến chúng cho đến khi chúng sẵn sàng hoạt động.
Quản lý cấu hình và bảo mật Kubernetes cho phép bạn lưu trữ và quản lý các thông tin nhạy cảm như: password, OAuth token và SSH key. Bạn có thể triển khai và cập nhật lại secret và cấu hình ứng dụng mà không cần build lại các container image và không để lộ secret trong cấu hình stack của bạn.
Kubernetes không phải là gì?
Kubernetes không phải là một hệ thống PaaS (Nền tảng như một Dịch vụ) truyền thống, toàn diện. Do Kubernetes hoạt động ở tầng container chứ không phải ở tầng phần cứng, nó cung cấp một số tính năng thường áp dụng chung cho các dịch vụ PaaS, như triển khai, nhân rộng, cân bằng tải, ghi nhật ký và giám sát. Tuy nhiên, Kubernetes không phải là cấu trúc nguyên khối và các giải pháp mặc định này là tùy chọn và có thể cắm được (pluggable).
Kubernetes:
Không giới hạn các loại ứng dụng được hỗ trợ. Kubernetes nhằm mục đích hỗ trợ một khối lượng công việc cực kỳ đa dạng, bao gồm cả stateless, stateful và xử lý dữ liệu. Nếu một ứng dụng có thể chạy trong một container, nó sẽ chạy rất tốt trên Kubernetes.
Không triển khai mã nguồn và không build ứng dụng của bạn. Quy trình CI/CD được xác định bởi tổ chức cũng như các yêu cầu kỹ thuật.
Không cung cấp các service ở mức ứng dụng, như middleware (ví dụ, các message buses), các framework xử lý dữ liệu (ví dụ, Spark), cơ sở dữ liệu (ví dụ, MySQL), bộ nhớ cache, cũng như hệ thống lưu trữ của cluster (ví dụ, Ceph). Các thành phần như vậy có thể chạy trên Kubernetes và/hoặc có thể được truy cập bởi các ứng dụng chạy trên Kubernetes thông qua các cơ chế di động, chẳng hạn như Open Service Broker.
Không bắt buộc các giải pháp ghi lại nhật ký (logging), giám sát (monitoring) hoặc cảnh báo (alerting). Nó cung cấp một số sự tích hợp như proof-of-concept, và cơ chế để thu thập và xuất các số liệu.
Không cung cấp, không bắt buộc một cấu hình ngôn ngữ/hệ thống (ví dụ: Jsonnet). Nó cung cấp một API khai báo có thể được targeted bởi các hình thức khai báo tùy ý.
Không cung cấp cũng như áp dụng bất kỳ cấu hình toàn diện, bảo trì, quản lý hoặc hệ thống tự phục hồi.
Ngoài ra, Kubernetes không phải là một hệ thống điều phối đơn thuần. Trong thực tế, nó loại bỏ sự cần thiết của việc điều phối. Định nghĩa kỹ thuật của điều phối là việc thực thi một quy trình công việc được xác định: đầu tiên làm việc A, sau đó là B rồi sau chót là C. Ngược lại, Kubernetes bao gồm một tập các quy trình kiểm soát độc lập, có thể kết hợp, liên tục điều khiển trạng thái hiện tại theo trạng thái mong muốn đã cho. Nó không phải là vấn đề làm thế nào bạn có thể đi được từ A đến C. Kiểm soát tập trung cũng không bắt buộc. Điều này dẫn đến một hệ thống dễ sử dụng hơn, mạnh mẽ hơn, linh hoạt hơn và có thể mở rộng.
Trong các hệ thống phân tán, Kubernetes sử dụng cơ chế leases (giữ quyền tạm thời) để khóa tài nguyên dùng chung và điều phối hoạt động giữa các thành phần trong cụm. Trong Kubernetes, lease được biểu diễn bằng các đối tượng Lease thuộc API group coordination.k8s.ioAPI Group, Những đối tượng này đóng vai trò quan trọng trong hệ thống, ví dụ như theo dõi trạng thái node (heartbeat) và cơ chế bầu chọn leader giữa các thành phần nội bộ.
Node heartbeats
Kubernetes sử dụng Lease API để truyền tín hiệu heartbeat từ kubelet về Kubernetes API server. Với mỗi đối tượng Node, sẽ có một đối tượng Lease tương ứng (có cùng tên) nằm trong namespace kube-node-lease. Ở tầng bên dưới, mỗi lần kubelet gửi heartbeat thực chất là một lệnh update lên đối tượng Lease, cập nhật trường spec.renewTime. Control plane của Kubernetes sẽ dựa vào dấu thời gian trong trường này để xác định node đó còn hoạt động hay không.
Kubernetes cũng sử dụng Lease để đảm bảo rằng chỉ một phiên bản duy nhất của một thành phần có thể hoạt động tại một thời điểm.
Cơ chế này được áp dụng cho các thành phần của control plane như kube-controller-manager và kube-scheduler trong các cấu hình HA (High Availability) — nơi chỉ một phiên bản của thành phần đó được phép hoạt động chính, còn các phiên bản còn lại sẽ ở chế độ chờ.
Đọc thêm tại coordinated leader election để tìm hiểu cách Kubernetes sử dụng Lease API để chọn phiên bản nào sẽ đóng vai trò leader.
API server identity
TRẠNG THÁI TÍNH NĂNG:Beta since Kubernetes v1.26; enabled by default
Từ phiên bản Kubernetes v1.26, mỗi kube-apiserver sẽ sử dụng Lease API để công bố danh tính của mình với phần còn lại của hệ thống.Mặc dù việc này chưa mang lại lợi ích trực tiếp, nhưng nó cung cấp một cơ chế để các thành phần khác có thể phát hiện được có bao nhiêu phiên bản kube-apiserver đang hoạt động trong control plane. Việc tồn tại các Lease của kube-apiserver giúp chuẩn bị cho các tính năng trong tương lai, nơi các kube-apiserver có thể cần phối hợp hoạt động với nhau.
Bạn có thể kiểm tra các Lease này trong namespace kube-system, với tên theo dạng apiserver-<sha256-hash>. Hoặc sử dụng label để lọc apiserver.kubernetes.io/identity=kube-apiserver:
kubectl -n kube-system get lease -l apiserver.kubernetes.io/identity=kube-apiserver
NAME                                        HOLDER                                                                           AGE
apiserver-07a5ea9b9b072c4a5f3d1c3702        apiserver-07a5ea9b9b072c4a5f3d1c3702_0c8914f7-0f35-440e-8676-7844977d3a05        5m33s
apiserver-7be9e061c59d368b3ddaf1376e        apiserver-7be9e061c59d368b3ddaf1376e_84f2a85d-37c1-4b14-b6b9-603e62e4896f        4m23s
apiserver-1dfef752bcb36637d2763d1868        apiserver-1dfef752bcb36637d2763d1868_c5ffa286-8a9a-45d4-91e7-61118ed58d2e        4m43s
Chuỗi SHA256 hash được sử dụng trong tên của đối tượng Lease được tính dựa trên hostname của hệ điều hành mà kube-apiserver nhìn thấy. Do đó, mỗi kube-apiserver cần được cấu hình với một hostname duy nhất trong cụm Kubernetes để tránh xung đột.
Khi có một instance mới của kube-apiserver được khởi động và sử dụng cùng hostname với một instance trước đó, nó sẽ tiếp quản Lease đã có sẵn bằng cách ghi đè holder identity, thay vì tạo một Lease mới.Bạn có thể kiểm tra hostname mà kube-apiserver đang sử dụng bằng cách tra nhãn kubernetes.io/hostname trên node hoặc pod tương ứng:
kubectl -n kube-system get lease apiserver-07a5ea9b9b072c4a5f3d1c3702 -o yaml
Các Lease đã hết hạn từ những kube-apiserver không còn tồn tại sẽ được thu gom tự động (garbage collect) bởi các kube-apiserver mới sau 1 giờ.
Bạn có thể tắt cơ chế Lease định danh của API server bằng cách vô hiệu hóa feature gate APIServerIdentity.
Xem thêm tại feature gate.
Workloads
Bạn có thể tự định nghĩa và sử dụng Lease cho chính workload của mình.
Ví dụ: bạn có thể chạy một controller tùy chỉnh, trong đó một bản sao chính (primary hoặc leader) sẽ thực hiện các thao tác mà các bản sao còn lại không thực hiện.
Bạn định nghĩa một đối tượng Lease để các bản sao của controller có thể chọn hoặc bầu chọn ra leader, sử dụng Kubernetes API để phối hợp hoạt động.
Nếu bạn sử dụng Lease, cách thực hiện tốt là đặt tên Lease sao cho dễ liên kết với sản phẩm hoặc thành phần sử dụng nó.
Ví dụ: nếu bạn có một thành phần tên là Example Foo, thì nên đặt Lease là example-foo.
Nếu người vận hành cluster hoặc người dùng cuối có thể triển khai nhiều phiên bản của cùng một thành phần, hãy chọn một tiền tố tên riêng biệt và áp dụng một cơ chế (chẳng hạn như hash của tên Deployment) để tránh trùng tên Lease.
Bạn cũng có thể sử dụng một cách tiếp cận khác, miễn là đạt được mục tiêu chung:
các phần mềm khác nhau không gây xung đột với nhau khi sử dụng Lease.
3.4.2 - Các khái niệm nền tảng của Cloud Controller Manager
Khái niệm Cloud Controller Manager (CCM) (để tránh nhầm lẫn với bản binary build cùng tên) được định nghĩa riêng biệt để cho phép các bên cung cấp dịch vụ cloud và thành phần chính của Kubernetes phát triển độc lập với nhau. CCM chạy đồng thời với những thành phần khác thuộc máy chủ của một cluster như Controller Manager của Kubernetes, API server, và Scheduler. Nó cũng có thể đóng vai trò như một addon cho Kubernetes.
Cloud Controller Manager này được thiết kế dựa trên cơ chế plugin nhằm cho phép các bên Cloud Provider có thể tích hợp với Kubernetes một cách dễ dàng thông qua các plugin này. Đã có những bản kế hoạch được thiết kế sẵn nhằm mục đích hỗ trợ những cloud provider thay đổi từ mô hình cũ sang mô hình mới đi chung với CCM.
Tài liệu này thảo luận về những khái niệm đằng sau một CCM và đưa ra những chi tiết về chức năng liên quan của nó.
Dưới đây là kiến trúc của một Kubernetes cluster khi không đi cùng với Cloud Controller Manager:
Thiết kế
Trong sơ đồ trên, Kubernetes và nhà cung cấp dịch vụ cloud được tích hợp thông qua một số thành phần sau:
Kubelet
Kubernetes Controller Manager
Kubernetes API server
CCM hợp nhất tất cả các logic phụ thuộc trên một nền tàng Cloud từ 3 thành phần trên để tạo thành một điểm tích hợp duy nhất với hệ thống Cloud. Sơ đồ kiến trúc khi đi kèm với CCM sẽ trở thành:
Các thành phần của CCM
Cloud Controller Manager phân nhỏ một số chức năng của Kubernetes controller manager (KCM) và chạy nó như một tiến trình tách biệt. Cụ thể hơn, nó phân nhỏ những controller trong Kubernetes Controller Manager phụ thuộc vào Cloud. Kubernetes Controller Manager sẽ có những controller nhỏ hơn:
Node controller
Volume controller
Route controller
Service controller
Tại phiên bản 1.9, CCM thực hiện chạy những controller sau từ trong danh sách trên:
Node controller
Route controller
Service controller
Lưu ý:
Volume controller được bỏ ra khỏi Cloud Controller Manager. Do độ phức tạp lớn ảnh hướng và sẽ tốn nhiều thời gian cũng như nhân lực không đáp ứng đủ cho việc tách hẳn tầng logic liên quan tới Volume từ những bên cung cấp dịch vụ, và quyết định cuối cùng là sẽ không triển khai quản lý Volume như một phần của CCM.
Kết hoạch ban đầu của dự án là hỗ trợ Volume sử dụng Cloud Controller Manager để áp dụng những Flex Volume linh hoạt nhằm dễ dàng tích hợp bổ sung thêm. Tuy nhiên, một giải pháp khác cũng đang được lên kế hoạch để thay thế Flex Volume được biết là CSI.
Sau khi xem xét về khía cạnh này, chúng tôi quyết định sẽ có một khoảng thời gian nghỉ trước khi CSI trở nên sẵn sàng cho việc sử dụng.
Chức năng của Cloud Controller Manager
CCM thừa hưởng những tính năng của nó từ các thành phần trong Kubernetes phụ thuộc vào các Cloud Provider. Phần kế tiếp sẽ giới thiệu những thành phần này.
1. Kubernetes Conntroller Manager
Phần lớn các tính năng của CCM bắt nguồn từ Kubernetes controller manager. Như đã đề cập ở phần trước, CCM bao gồm:
Node controller
Route controller
Service controller
Node controller
Node controller có vai trò khởi tạo một Node bằng cách thu thập thông tin về những Node đang chạy trong cluster từ các cloud provider.
Node controller sẽ thực hiện những chức năng sau:
Khởi tạo một Node với các nhãn region/zone.
Khởi tạo một Node với những thông tin được cung cấp từ cloud, ví dụ như loại máy và kích cỡ.
Thu thập địa chỉ mạng của Node và hostname.
Trong trường hợp một Node không có tín hiệu phản hồi, Node controller sẽ kiểm tra xem Node này có thực sự xóa khỏi hệ thống cloud hay chưa. Nếu Node đó không còn tồn tại trên cloud, controller sẽ xóa Node đó khỏi Kubernetes cluster.
Route controller
Route controller đóng vai trò cấu hình định tuyến trong nằm trong hệ thống cloud để các container trên các Node khác nhau trong Kubernetes cluster có thể giao tiếp với nhau. Route controller hiện chỉ đáp ứng được cho các Google Compute Engine cluster.
Service controller
Service controller lắng nghe các sự kiện tạo mới, cập nhật và xoá bỏ một service. Dựa trên trạng thái hiện tại của các vụ trên Kubernetes, nó cấu hình các dịch vụ cân bằng tải trên cloud (như ELB của AWS, Google Load Balancer, hay Oracle Cloud Infrastructure LB) nhằm phản ánh trạng thái của các Service trên Kubernetes. Ngoài ra, nó đảm bảo những service backends cho các dịch vụ cần bằng tải trên cloud được cập nhật
2. Kubelet
Node controller bao gồm một số tính năng phụ thuộc vào tầng cloud của Kubelet. Trước khi có CCM, Kubelet đảm nhận vai trò khởi tạo một Node với thông tin chi tiết từ cloud như địa chỉ IP, region hay instance type. Với CCM, vai trò này được CCM đảm nhận thay cho Kubelet.
Với mô hình mới này, Kubelet sẽ khởi tạo một Node nhưng không đi kèm với những thông tin từ cloud. Tuy nhiên, nó sẽ thêm vào một dấu Taint để đánh dấu Node sẽ không được lập lịch cho tới khi CCM khởi tạo xong Node này với những thông tin cụ thể cung cấp từ Cloud, sau đó nó sẽ xóa những dấu chờ này.
Cơ chế Plugin
CCM sử dụng interface trong ngôn ngữ Go cho phép triển khai trên bất kì hệ thống cloud nào cũng có thể plugged in. Cụ thể hơn, nó sử dụng CloudProvider Interface được định nghĩa ở đây.
Cách triển khai của bốn controller được nêu ở trên, và một số được thực hiện như giao diện chung cho các bên cung cấp dịch vụ cloud, sẽ ở trong lõi (core) của Kubernetes. Việc triển khai dành riêng cho từng cloud provider sẽ được xây dựng bên ngoài lõi (core) và triển khai các giao diện được xác định bên trong lõi.
Hướng dẫn chi tiết cho việc cấu hình và chạy CCM được cung cấp tại đây.
3.4.3 - Kubernetes - Khả năng tự phục hồi (Self-Healing)
Kubernetes được thiết kế với khả năng tự phục hồi giúp duy trì tình trạng khỏe mạnh và tính khả dụng của các workload.
Nó tự động thay thế các container bị lỗi, lập lịch lại các workload khi node trở nên không khả dụng, và đảm bảo rằng trạng thái mong muốn của hệ thống được duy trì.
Khả năng tự phục hồi
Khởi động lại ở cấp độ container: Nếu một container bên trong Pod bị lỗi, Kubernetes sẽ khởi động lại nó dựa trên restartPolicy.
Thay thế replica: Nếu một Pod trong Deployment hoặc StatefulSet bị lỗi, Kubernetes sẽ tạo một Pod thay thế để duy trì số lượng replica được chỉ định.
Nếu một Pod thuộc DaemonSet bị lỗi, control plane sẽ
tạo một Pod thay thế để chạy trên cùng node đó.
Phục hồi persistent storage: Nếu một node đang chạy Pod với PersistentVolume (PV) được gắn kết, và node đó bị lỗi, Kubernetes có thể gắn lại volume vào Pod mới trên node khác.
Cân bằng tải cho Service: Nếu một Pod đằng sau Service bị lỗi, Kubernetes sẽ tự động loại bỏ nó khỏi endpoint của Service để chỉ định tuyến traffic đến các Pod khỏe mạnh.
Dưới đây là một số thành phần chính cung cấp khả năng tự phục hồi của Kubernetes:
kubelet: Đảm bảo rằng các container đang chạy, và khởi động lại những container bị lỗi.
ReplicaSet, StatefulSet và DaemonSet controller: Duy trì số lượng replica Pod mong muốn.
PersistentVolume controller: Quản lý việc gắn kết và tháo gỡ volume cho các stateful workload.
Những điều cần cân nhắc
Lỗi Storage: Nếu một persistent volume trở nên không khả dụng, có thể cần các bước phục hồi thủ công.
Lỗi Ứng dụng: Kubernetes có thể khởi động lại container, nhưng các vấn đề ứng dụng cơ bản phải được giải quyết riêng biệt.
Đọc về node autoscaling. Node autoscaling
cũng cung cấp khả năng tự phục hồi tự động nếu hoặc khi các node bị lỗi trong cluster của bạn.
3.4.4 - Proxy Đa Phiên Bản (Mixed Version Proxy)
TRẠNG THÁI TÍNH NĂNG:Beta since Kubernetes v1.36; enabled by default
Kubernetes 1.37 giới thiệu một tính năng alpha cho phép
API Server
proxy các yêu cầu tài nguyên đến các API server ngang hàng khác. Tính năng này đặc biệt hữu ích khi trong một cụm có nhiều API server đang chạy các phiên bản Kubernetes khác nhau (ví dụ: trong quá trình nâng cấp cụm kéo dài sang phiên bản mới).
Điều này giúp quản trị viên của cluster cấu hình các cluster có độ sẵn sàng cao (high availability) có thể được nâng cấp một cách an toàn hơn, bằng cách chuyển hướng các yêu cầu tài nguyên (trong thời gian nâng cấp) đến đúng kube-api server. Cơ chế proxy này giúp người dùng tránh gặp lỗi 404 (Not Found) không mong muốn do quá trình nâng cấp gây ra.
Cơ chế này được gọi là Proxy Đa Phiên Bản.
Bật tính năng Proxy Đa Phiên Bản
Đảm bảo rằng cờ feature gateUnknownVersionInteroperabilityProxy đã được bật khi khởi động
API Server:
kube-apiserver \
--feature-gates=UnknownVersionInteroperabilityProxy=true\
# các tham số dòng lệnh bắt buộc cho tính năng này--peer-ca-file=<đường dẫn đến CA cert của kube-apiserver>
--proxy-client-cert-file=<đường dẫn đến chứng chỉ proxy của aggregator>,
--proxy-client-key-file=<đường dẫn đến khóa proxy của aggregator>,
--requestheader-client-ca-file=<đường dẫn đến CA cert của aggregator>,
# requestheader-allowed-names có thể để trống để chấp nhận mọi Common Name--requestheader-allowed-names=<các Common Name hợp lệ để xác minh chứng chỉ proxy client>,
# các cờ tuỳ chọn cho tính năng này--peer-advertise-ip=<Địa chỉ IP của kube-apiserver này để peer sử dụng khi proxy> --peer-advertise-port=<Cổng mà kube-apiserver này mở để peer sử dụng khi proxy>
# …và các cờ khác như thường lệ
Kết nối và xác thực giữa các API server
API server nguồn tái sử dụng các cờ xác thực client cho API server hiện có là --proxy-client-cert-file và --proxy-client-key-file để trình bày danh tính của nó, danh tính này sẽ được kube-apiserver đích (destination kube-apiserver) xác minh. API server đích sẽ xác thực kết nối từ phía đối tác dựa trên cấu hình được chỉ định thông qua tham số dòng lệnh --requestheader-client-ca-file.
Để xác thực chứng chỉ phục vụ (serving cert) của API server đích, bạn cần cấu hình một gói chứng chỉ CA bằng cách cung cấp tham số dòng lệnh --peer-ca-file cho API server nguồn.
Cấu hình kết nối tới peer API server
Để khai báo địa chỉ mạng của một API server mà các peer sẽ sử dụng để proxy yêu cầu, sử dụng các tham số --peer-advertise-ip và --peer-advertise-port, hoặc khai báo trong tệp cấu hình của API server.
Nếu không khai báo các cờ này, kube-apiserver sẽ mặc định sử dụng giá trị từ --advertise-address hoặc --bind-address. Nếu các tham số này cũng không được cấu hình, địa chỉ giao diện mạng mặc định của máy chủ sẽ được dùng.
Cơ chế proxy giữa các phiên bản khác nhau
Khi proxy đa phiên bản được bật, aggregation layer sẽ tải một bộ lọc đặc biệt với các hành vi sau:
Khi một API server nhận được yêu cầu tài nguyên mà nó không thể xử lý (do chưa hỗ trợ API đó hoặc API bị tắt), nó sẽ tìm cách proxy yêu cầu đến một API server ngang hàng có thể xử lý yêu cầu đó.
Việc này được thực hiện bằng cách xác định các nhóm / phiên bản / tài nguyên API mà server hiện tại không nhận biết, rồi chuyển tiếp yêu cầu tới một peer có thể xử lý được.
Nếu API server peer gặp lỗi khi phản hồi, API server nguồn sẽ trả về lỗi 503 ("Service Unavailable").
Cách hoạt động bên trong
Khi một API server nhận yêu cầu tài nguyên, nó kiểm tra xem API server nào có thể xử lý yêu cầu đó. Việc kiểm tra này dựa trên API StorageVersion nội bộ.
Nếu tài nguyên đã được API server nhận biết (ví dụ: GET /api/v1/pods/some-pod), yêu cầu sẽ được xử lý tại chỗ.
Nếu không có đối tượng StorageVersion nào tương ứng với tài nguyên yêu cầu (ví dụ: GET /my-api/v1/my-resource) nhưng APIService tương ứng được cấu hình để proxy đến một API server mở rộng, thì yêu cầu sẽ được xử lý theo luồng proxy mở rộng.
Nếu có một đối tượng StorageVersion hợp lệ cho tài nguyên được yêu cầu (ví dụ: GET /batch/v1/jobs) và API server đang cố xử lý yêu cầu đó (gọi là handling API server) đã tắt nhóm API batch, thì handling API server sẽ truy xuất danh sách các API server ngang hàng (peer API servers) có phục vụ nhóm API / phiên bản / tài nguyên tương ứng (trong trường hợp này là api/batch/v1) dựa trên thông tin từ đối tượng StorageVersion đã truy xuất. Sau đó, handling API server sẽ chuyển tiếp (proxy) yêu cầu đến một trong những kube-apiserver ngang hàng phù hợp, vốn có khả năng xử lý tài nguyên được yêu cầu.
Nếu không có peer nào khả dụng cho nhóm / phiên bản / tài nguyên đó, API server sẽ trả lại lỗi 404 ("Not Found").
Nếu có peer phù hợp nhưng không phản hồi (do lỗi mạng, hoặc thông tin về peer chưa được đăng ký đúng lúc), thì API server sẽ trả về lỗi 503 ("Service Unavailable").
3.5 - Secrets
Trang này đang được dịch. Vui lòng xem phiên bản tiếng Anh để biết thông tin mới nhất.
3.6 - Container
Công nghệ đóng gói một ứng dụng cùng với các thành phần phụ thuộc mà ứng dụng cần khi chạy.
Trang này trình bày về container và container image, cũng như cách sử dụng chúng trong vận hành và phát triển giải pháp.
Từ container được dùng với nhiều nghĩa khác nhau. Mỗi khi dùng từ này, bạn hãy kiểm tra xem người nghe có hiểu theo cùng một định nghĩa với bạn hay không.
Mỗi container mà bạn chạy đều có thể tái lập (repeatable); việc chuẩn hóa bằng cách đóng gói kèm
các thành phần phụ thuộc giúp bạn nhận được cùng một hành vi ở bất cứ nơi nào bạn
chạy container đó.
Container tách rời ứng dụng khỏi hạ tầng máy chủ (host) bên dưới.
Điều này giúp việc triển khai trở nên dễ dàng hơn trên các môi trường đám mây hoặc hệ điều hành khác nhau.
Mỗi node trong một cluster
Kubernetes chạy các container tạo nên các
Pod được gán cho node đó.
Các container trong một Pod luôn được đặt cùng vị trí (co-located) và lập lịch cùng nhau (co-scheduled) để chạy trên cùng một node.
Container image
Một container image là một gói phần mềm
sẵn sàng để chạy, chứa mọi thứ cần thiết để chạy một ứng dụng:
mã chương trình và mọi runtime mà nó cần, các thư viện ứng dụng và thư viện hệ thống,
cùng với giá trị mặc định cho mọi thiết lập thiết yếu.
Container được thiết kế theo hướng stateless và
bất biến:
bạn không nên thay đổi
mã của một container đang chạy. Nếu bạn có một ứng dụng đã được container hóa
và muốn thay đổi nó, quy trình đúng là build một image mới
có chứa thay đổi đó, sau đó tạo lại container để khởi động từ
image đã được cập nhật.
Container runtime
Một thành phần cơ bản mà ủy quyền cho Kubernetes chạy các container một cách có hiệu quả.
Nó chịu trách nhiệm quản lý việc thực thi và vòng đời của các container trong môi trường Kubernetes.
Thông thường, bạn có thể để cluster tự chọn container runtime mặc định
cho một Pod. Nếu bạn cần dùng nhiều hơn một container runtime trong cluster,
bạn có thể chỉ định RuntimeClass
cho Pod để đảm bảo rằng Kubernetes chạy các container đó bằng một
container runtime cụ thể.
Bạn cũng có thể dùng RuntimeClass để chạy các Pod khác nhau với cùng một container
runtime nhưng với các thiết lập khác nhau.
3.6.1 - Image
Một container image là dữ liệu nhị phân đóng gói một ứng dụng cùng toàn bộ
các thành phần phụ thuộc phần mềm của nó. Container image là các gói phần mềm có thể thực thi, có thể chạy
độc lập và có những giả định được xác định rất rõ ràng về môi trường runtime của chúng.
Thông thường, bạn tạo một container image cho ứng dụng của mình và push nó lên một registry
trước khi tham chiếu tới nó trong một Pod.
Trang này trình bày tổng quan về khái niệm container image.
Lưu ý:
Nếu bạn đang tìm các container image cho một bản phát hành
Kubernetes (chẳng hạn v1.37, bản phát hành minor mới nhất),
hãy truy cập Tải xuống Kubernetes.
Tên image
Container image thường được đặt tên như pause, example/mycontainer hoặc kube-apiserver.
Image cũng có thể bao gồm hostname của registry; ví dụ: fictional.registry.example/imagename,
và có thể có cả số cổng; ví dụ: fictional.registry.example:10443/imagename.
Nếu bạn không chỉ định hostname của registry, Kubernetes sẽ giả định rằng bạn muốn dùng Docker public registry.
Bạn có thể thay đổi hành vi này bằng cách thiết lập một image registry mặc định trong
cấu hình của container runtime.
Sau phần tên image, bạn có thể thêm tag hoặc digest (giống như khi dùng với các lệnh
như docker hoặc podman). Tag giúp bạn phân biệt các phiên bản khác nhau trong cùng một loạt image.
Digest là định danh duy nhất cho một phiên bản cụ thể của image. Digest là giá trị băm (hash) của nội dung image,
và không thể thay đổi. Tag có thể được chuyển sang trỏ tới các image khác, nhưng digest thì cố định.
Tag của image gồm các chữ cái thường và chữ hoa, chữ số, dấu gạch dưới (_),
dấu chấm (.) và dấu gạch ngang (-). Một tag có thể dài tối đa 128 ký tự, và phải
tuân theo mẫu regex sau: [a-zA-Z0-9_][a-zA-Z0-9._-]{0,127}.
Bạn có thể đọc thêm và tìm regex dùng để kiểm tra tính hợp lệ trong
OCI Distribution Specification.
Nếu bạn không chỉ định tag, Kubernetes sẽ giả định rằng bạn muốn dùng tag latest.
Digest của image gồm một thuật toán băm (chẳng hạn sha256) và một giá trị băm. Ví dụ:
sha256:1ff6c18fbef2045af6b9c16bf034cc421a29027b800e4f9b68ae9b1cb3e9ae07.
Bạn có thể tìm thêm thông tin về định dạng digest trong
OCI Image Specification.
Một số ví dụ về tên image mà Kubernetes có thể sử dụng:
busybox — Chỉ có tên image, không có tag hay digest. Kubernetes sẽ dùng Docker
public registry và tag latest. Tương đương với docker.io/library/busybox:latest.
busybox:1.32.0 — Tên image kèm tag. Kubernetes sẽ dùng Docker
public registry. Tương đương với docker.io/library/busybox:1.32.0.
registry.k8s.io/pause:latest — Tên image với registry tùy chỉnh và tag latest.
registry.k8s.io/pause:3.5 — Tên image với registry tùy chỉnh và tag không phải latest.
registry.k8s.io/pause@sha256:1ff6c18fbef2045af6b9c16bf034cc421a29027b800e4f9b68ae9b1cb3e9ae07 —
Tên image kèm digest.
registry.k8s.io/pause:3.5@sha256:1ff6c18fbef2045af6b9c16bf034cc421a29027b800e4f9b68ae9b1cb3e9ae07 —
Tên image kèm tag và digest. Khi pull image, chỉ digest được sử dụng.
Cập nhật image
Khi bạn tạo lần đầu một Deployment,
StatefulSet, Pod, hoặc đối tượng
khác có chứa PodTemplate, và chính sách pull (pull policy) không được chỉ định rõ ràng,
thì theo mặc định, chính sách pull của tất cả các container trong Pod đó sẽ được đặt thành
IfNotPresent. Chính sách này khiến
kubelet bỏ qua việc pull một
image nếu image đó đã tồn tại.
Chính sách pull image
imagePullPolicy của một container và tag của image cùng ảnh hưởng tới thời điểmkubelet cố gắng pull
(tải xuống) image được chỉ định.
Dưới đây là danh sách các giá trị bạn có thể đặt cho imagePullPolicy và tác dụng
của từng giá trị:
IfNotPresent
image chỉ được pull nếu nó chưa có sẵn ở máy cục bộ.
Always
mỗi khi kubelet khởi chạy một container, kubelet yêu cầu
container runtime
pull image. Container runtime liên hệ với registry, phân giải
tag hoặc tên image thành một
digest,
và tải xuống các layer chưa được lưu đệm (cache) ở máy cục bộ.
Nếu tất cả các layer đã có sẵn, container runtime sẽ dùng image
đã được cache mà không tải lại. Bản thân kubelet không kiểm tra
xem image đã được cache ở máy cục bộ hay chưa; kubelet luôn giao việc này cho container
runtime.
Never
kubelet không cố gắng tải image. Nếu bằng cách nào đó image đã có sẵn
ở máy cục bộ, kubelet sẽ cố gắng khởi động container; nếu không, quá trình khởi động sẽ thất bại.
Xem image được pull sẵn để biết thêm chi tiết.
Nhờ cơ chế cache của container runtime, ngay cả
imagePullPolicy: Always cũng hoạt động hiệu quả, miễn là registry luôn truy cập được ổn định.
Container runtime có thể nhận biết rằng các layer của image đã tồn tại trên node
nên không cần tải xuống lại.
Lưu ý:
Bạn nên tránh dùng tag :latest khi triển khai container trong môi trường production vì
khi đó sẽ khó theo dõi phiên bản nào của image đang chạy hơn và khó rollback
đúng cách hơn.
Thay vào đó, hãy chỉ định một tag có ý nghĩa như v1.42.0 và/hoặc một digest.
Để đảm bảo Pod luôn dùng cùng một phiên bản của container image, bạn có thể chỉ định
digest của image;
thay <image-name>:<tag> bằng <image-name>@<digest>
(ví dụ, image@sha256:45b23dee08af5e43a7fea6c4cf9c25ccf269ee113168c19722f87876677c5cb2).
Khi dùng tag của image, nếu image registry thay đổi phần mã mà tag của image đó
đại diện, bạn có thể gặp tình trạng lẫn lộn giữa các Pod chạy mã cũ và mã mới. Digest của image
định danh duy nhất một phiên bản cụ thể của image, vì vậy Kubernetes sẽ chạy cùng một mã mỗi khi
khởi động một container với tên image và digest đó. Việc chỉ định image bằng digest
sẽ cố định mã mà bạn chạy, nhờ đó thay đổi ở registry không thể gây ra tình trạng lẫn lộn phiên bản như vậy.
Có những admission controller của bên thứ ba
có thể thay đổi (mutate) các Pod (và PodTemplate) khi chúng được tạo, sao cho
workload đang chạy được xác định dựa trên digest của image thay vì tag.
Điều đó có thể hữu ích nếu bạn muốn đảm bảo toàn bộ workload của mình
đang chạy cùng một mã, bất kể tag ở registry thay đổi thế nào.
Chính sách pull image mặc định
Khi bạn (hoặc một controller) gửi một Pod mới tới API server, cluster của bạn sẽ đặt
trường imagePullPolicy khi thỏa mãn các điều kiện cụ thể sau:
nếu bạn bỏ qua trường imagePullPolicy và chỉ định digest cho
container image, imagePullPolicy sẽ tự động được đặt thành IfNotPresent.
nếu bạn bỏ qua trường imagePullPolicy và tag của container image là
:latest, imagePullPolicy sẽ tự động được đặt thành Always.
nếu bạn bỏ qua trường imagePullPolicy và không chỉ định tag cho
container image, imagePullPolicy sẽ tự động được đặt thành Always.
nếu bạn bỏ qua trường imagePullPolicy và chỉ định một tag cho container
image không phải là :latest, imagePullPolicy sẽ tự động được đặt thành
IfNotPresent.
Lưu ý:
Giá trị imagePullPolicy của container luôn được đặt khi đối tượng
được tạo lần đầu, và không được cập nhật nếu tag hoặc digest của image thay đổi sau đó.
Ví dụ, nếu bạn tạo một Deployment với image có tag không phải là
:latest, và sau đó cập nhật image của Deployment đó sang tag :latest,
trường imagePullPolicy sẽ không chuyển thành Always. Bạn phải tự thay đổi
chính sách pull của bất kỳ đối tượng nào sau khi nó được tạo lần đầu.
Bắt buộc pull image
Nếu bạn muốn luôn bắt buộc pull, bạn có thể làm theo một trong các cách sau:
Đặt imagePullPolicy của container thành Always.
Bỏ qua imagePullPolicy và dùng :latest làm tag cho image cần dùng;
Kubernetes sẽ đặt chính sách thành Always khi bạn gửi Pod.
Bỏ qua imagePullPolicy và tag cho image cần dùng;
Kubernetes sẽ đặt chính sách thành Always khi bạn gửi Pod.
Khi kubelet bắt đầu tạo các container cho một Pod bằng container runtime,
có thể container sẽ ở trạng thái Waiting
do ImagePullBackOff.
Trạng thái ImagePullBackOff có nghĩa là container không thể khởi động vì Kubernetes
không thể pull container image (vì những lý do như tên image không hợp lệ, hoặc pull
từ một registry riêng tư mà không có imagePullSecret). Phần BackOff cho biết
Kubernetes sẽ tiếp tục thử pull image, với độ trễ back-off tăng dần.
Kubernetes tăng độ trễ giữa các lần thử cho tới khi đạt giới hạn được biên dịch sẵn,
là 300 giây (5 phút).
Pull image theo runtime class
TRẠNG THÁI TÍNH NĂNG:Alpha since Kubernetes v1.29; disabled by default
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the RuntimeClassInImageCriApi feature gate for all relevant components in your cluster.
Kubernetes có hỗ trợ ở mức alpha cho việc pull image dựa trên RuntimeClass của Pod.
Nếu bạn bật feature gateRuntimeClassInImageCriApi,
kubelet sẽ tham chiếu container image bằng một bộ (tuple) gồm tên image và runtime handler
thay vì chỉ dùng tên image hoặc digest.
Container runtime
của bạn có thể điều chỉnh hành vi dựa trên runtime handler được chọn.
Pull image dựa trên runtime class hữu ích cho các container chạy trên máy ảo (VM), chẳng hạn
container Windows Hyper-V.
Pull image tuần tự và song song
Theo mặc định, kubelet pull các image một cách tuần tự. Nói cách khác, tại mỗi thời điểm kubelet chỉ gửi
một yêu cầu pull image tới image service. Các yêu cầu pull image
khác phải đợi cho tới khi yêu cầu đang được xử lý hoàn tất.
Mỗi node đưa ra quyết định pull image một cách độc lập. Ngay cả khi bạn dùng chế độ pull image
tuần tự, hai node khác nhau vẫn có thể pull cùng một image song song.
Nếu bạn muốn bật pull image song song, bạn có thể đặt trường
serializeImagePulls thành false trong cấu hình kubelet.
Khi serializeImagePulls được đặt thành false, các yêu cầu pull image sẽ được gửi ngay tới image service,
và nhiều image sẽ được pull cùng lúc.
Khi bật pull image song song, hãy đảm bảo rằng image service của container
runtime có thể xử lý việc pull image song song.
Kubelet không bao giờ pull nhiều image song song cho cùng một Pod. Ví dụ,
nếu bạn có một Pod gồm một init container và một container ứng dụng, việc pull image
cho hai container này sẽ không diễn ra song song. Tuy nhiên, nếu bạn có hai
Pod dùng các image khác nhau, và tính năng pull image song song được bật,
kubelet sẽ pull các image song song cho hai Pod khác nhau đó.
Số lượng pull image song song tối đa
TRẠNG THÁI TÍNH NĂNG:GA since Kubernetes v1.35
Khi serializeImagePulls được đặt thành false, theo mặc định kubelet không giới hạn
số lượng image tối đa được pull cùng lúc. Nếu bạn muốn
giới hạn số lượng pull image song song, bạn có thể đặt trường maxParallelImagePulls
trong cấu hình kubelet. Khi maxParallelImagePulls được đặt thành n, chỉ n
image có thể được pull cùng lúc, và mọi lượt pull image vượt quá n sẽ phải
đợi cho tới khi ít nhất một lượt pull image đang diễn ra hoàn tất.
Việc giới hạn số lượng pull image song song giúp tránh việc pull image tiêu tốn
quá nhiều băng thông mạng hoặc I/O ổ đĩa, khi pull image song song được bật.
Bạn có thể đặt maxParallelImagePulls thành một số dương lớn hơn hoặc
bằng 1. Nếu bạn đặt maxParallelImagePulls lớn hơn hoặc bằng 2,
bạn phải đặt serializeImagePulls thành false. Kubelet sẽ không khởi động được
nếu thiết lập maxParallelImagePulls không hợp lệ.
Image đa kiến trúc với image index
Ngoài việc cung cấp các image nhị phân, một container registry cũng có thể cung cấp một
container image index.
Một image index có thể trỏ tới nhiều image manifest
cho các phiên bản dành riêng cho từng kiến trúc của một container. Ý tưởng là bạn có thể có
một tên cho image (ví dụ: pause, example/mycontainer, kube-apiserver)
và cho phép các hệ thống khác nhau tải về đúng image nhị phân cho kiến trúc
máy mà chúng đang sử dụng.
Dự án Kubernetes thường tạo container image cho các bản phát hành của mình với
tên có hậu tố -$(ARCH). Để tương thích ngược, hãy tạo
các image cũ hơn kèm hậu tố. Ví dụ, một image có tên pause sẽ là
một image đa kiến trúc chứa manifest cho tất cả các kiến trúc được hỗ trợ,
trong khi pause-amd64 sẽ là phiên bản tương thích ngược cho các cấu hình cũ hơn,
hoặc cho các file YAML có tên image kèm hậu tố được viết cứng (hardcode).
Sử dụng registry riêng tư
Registry riêng tư (private registry) có thể yêu cầu xác thực thì mới khám phá và/hoặc pull
được image từ đó.
Thông tin xác thực (credential) có thể được cung cấp theo nhiều cách:
Tất cả các Pod đều có thể dùng bất kỳ image nào đã được cache trên một node.
Yêu cầu quyền root trên tất cả các node để thiết lập.
Phần mở rộng riêng của nhà cung cấp hoặc phần mở rộng cục bộ
Nếu bạn đang dùng một cấu hình node tùy chỉnh, bạn (hoặc nhà cung cấp đám mây của bạn) có thể
tự triển khai cơ chế xác thực node với container registry.
Các tùy chọn này được giải thích chi tiết hơn ở bên dưới.
Chỉ định imagePullSecrets trên một Pod
Lưu ý:
Đây là cách được khuyến nghị để chạy các container dựa trên image
trong registry riêng tư.
Kubernetes hỗ trợ chỉ định khóa của container image registry trên một Pod.
Tất cả imagePullSecrets phải là các Secret tồn tại trong cùng
Namespace với
Pod. Các Secret này phải có kiểu kubernetes.io/dockercfg hoặc kubernetes.io/dockerconfigjson.
Cấu hình node để xác thực với registry riêng tư
Hướng dẫn cụ thể về cách thiết lập thông tin xác thực phụ thuộc vào container runtime và registry mà bạn
chọn sử dụng. Bạn nên tham khảo tài liệu của giải pháp mà bạn dùng để có thông tin chính xác nhất.
Để xem ví dụ về cách cấu hình một container image registry riêng tư, hãy xem tác vụ
Pull một Image từ Registry riêng tư.
Ví dụ đó sử dụng một registry riêng tư trên Docker Hub.
Kubelet credential provider cho việc pull image có xác thực
Bạn có thể cấu hình kubelet để gọi một plugin dạng tệp nhị phân (binary) nhằm lấy
thông tin xác thực registry cho một container image một cách động. Đây là cách mạnh mẽ và linh hoạt nhất
để lấy thông tin xác thực cho registry riêng tư, nhưng cũng đòi hỏi phải cấu hình ở cấp kubelet
để bật.
Kỹ thuật này đặc biệt hữu ích khi chạy các static Pod
cần container image được lưu trữ trong registry riêng tư.
Bạn không thể dùng ServiceAccount hoặc
Secret để cung cấp thông tin xác thực cho registry riêng tư
trong đặc tả của một static Pod, vì static Pod không thể
tham chiếu tới các tài nguyên API khác trong đặc tả của mình.
Cách diễn giải config.json khác nhau giữa bản triển khai Docker gốc
và cách diễn giải của Kubernetes. Trong Docker, các key trong auths
chỉ có thể chỉ định URL gốc, trong khi Kubernetes cho phép cả URL dạng glob lẫn
đường dẫn khớp theo tiền tố. Hạn chế duy nhất là các mẫu glob (*) phải
bao gồm dấu chấm (.) cho mỗi subdomain. Số lượng subdomain được khớp
phải bằng số lượng mẫu glob (*.), ví dụ:
*.kubernetes.io sẽ không khớp với kubernetes.io, nhưng sẽ khớp với
abc.kubernetes.io.
*.*.kubernetes.io sẽ không khớp với abc.kubernetes.io, nhưng sẽ khớp với
abc.def.kubernetes.io.
prefix.*.io sẽ khớp với prefix.kubernetes.io.
*-good.kubernetes.io sẽ khớp với prefix-good.kubernetes.io.
Điều này có nghĩa là một config.json như sau là hợp lệ:
Các thao tác pull image sẽ chuyển thông tin xác thực tới CRI container runtime cho mọi
mẫu hợp lệ. Ví dụ, các tên container image sau sẽ được khớp
thành công:
my-registry.example/images
my-registry.example/images/my-image
my-registry.example/images/another-image
sub.my-registry.example/images/my-image
Tuy nhiên, các tên container image sau sẽ không được khớp:
a.sub.my-registry.example/images/my-image
a.b.sub.my-registry.example/images/my-image
Kubelet thực hiện pull image tuần tự với từng thông tin xác thực tìm được. Điều này
có nghĩa là config.json cũng có thể có nhiều mục cho các đường dẫn khác nhau:
Khi đó, nếu một container chỉ định image my-registry.example/images/subpath/my-image
cần được pull, kubelet sẽ thử tải image bằng cả hai nguồn
xác thực nếu một trong hai nguồn thất bại.
Image được pull sẵn
Lưu ý:
Cách này phù hợp nếu bạn có thể kiểm soát cấu hình node. Nó
sẽ không hoạt động ổn định nếu nhà cung cấp đám mây của bạn quản lý các node và tự động
thay thế chúng.
Theo mặc định, kubelet cố gắng pull từng image từ registry được chỉ định.
Tuy nhiên, nếu thuộc tính imagePullPolicy của container được đặt thành IfNotPresent hoặc Never,
thì image cục bộ sẽ được sử dụng (tương ứng là ưu tiên dùng hoặc chỉ dùng image cục bộ).
Nếu bạn muốn dựa vào các image được pull sẵn để thay thế cho việc xác thực với registry,
bạn phải đảm bảo tất cả các node trong cluster đều có cùng các image được pull sẵn.
Cách này có thể được dùng để tải trước một số image nhằm tăng tốc độ hoặc làm phương án thay thế cho
việc xác thực với registry riêng tư.
Tương tự như cách dùng kubelet credential provider,
các image được pull sẵn cũng phù hợp để khởi chạy
các static Pod phụ thuộc
vào image được lưu trữ trong registry riêng tư.
Lưu ý:
TRẠNG THÁI TÍNH NĂNG:Beta since Kubernetes v1.35; enabled by default
Đảm bảo xác minh thông tin xác thực khi pull image
TRẠNG THÁI TÍNH NĂNG:Beta since Kubernetes v1.35; enabled by default
Nếu feature gate KubeletEnsureSecretPulledImages được bật cho cluster của bạn,
Kubernetes sẽ kiểm tra thông tin xác thực của mọi image cần thông tin xác thực
để pull, ngay cả khi image đó đã có sẵn trên node. Việc kiểm tra này
đảm bảo rằng những image trong yêu cầu của Pod chưa từng được pull thành công
bằng thông tin xác thực được cung cấp sẽ phải được pull lại từ registry.
Ngoài ra, các lượt pull image dùng lại cùng thông tin xác thực
đã từng pull image thành công trước đó sẽ không cần pull lại từ
registry mà được kiểm tra cục bộ, không cần truy cập registry
(với điều kiện image có sẵn ở máy cục bộ).
Việc này được điều khiển bởi trường imagePullCredentialsVerificationPolicy trong
cấu hình Kubelet.
Cấu hình này quy định khi nào phải xác minh thông tin xác thực pull image nếu
image đã có sẵn trên node:
NeverVerify: Mô phỏng hành vi khi feature gate này bị tắt.
Nếu image có sẵn ở máy cục bộ, thông tin xác thực pull image sẽ không được xác minh.
NeverVerifyPreloadedImages: Các image được pull bên ngoài kubelet sẽ không được xác minh,
nhưng tất cả các image khác sẽ được xác minh thông tin xác thực. Đây là hành vi mặc định.
NeverVerifyAllowListedImages: Các image được pull bên ngoài kubelet và có trong
preloadedImagesVerificationAllowlist được chỉ định trong cấu hình kubelet sẽ không được xác minh.
AlwaysVerify: Tất cả các image sẽ được xác minh thông tin xác thực
trước khi có thể được sử dụng.
Việc xác minh này áp dụng cho image được pull sẵn,
image được pull bằng secret ở cấp node, và image được pull bằng secret ở cấp Pod.
Lưu ý:
Trong trường hợp xoay vòng thông tin xác thực (credential rotation), thông tin xác thực trước đây đã dùng để pull image
sẽ tiếp tục được xác minh mà không cần truy cập registry. Thông tin xác thực mới hoặc đã được xoay vòng
sẽ yêu cầu image phải được pull lại từ registry.
Bật KubeletEnsureSecretPulledImages lần đầu tiên
Khi KubeletEnsureSecretPulledImages được bật lần đầu tiên, dù là
do nâng cấp kubelet hay do bật tính năng một cách tường minh, nếu kubelet có thể
truy cập bất kỳ image nào vào thời điểm đó, tất cả các image này sẽ được coi là đã được pull sẵn. Điều này xảy ra
vì trong trường hợp này kubelet không có bản ghi nào về việc các image đã được pull.
Kubelet chỉ có thể bắt đầu tạo bản ghi pull image khi một image bất kỳ được
pull lần đầu tiên.
Nếu đây là điều bạn lo ngại, bạn nên dọn khỏi các node tất cả những image không nên
được coi là pull sẵn trước khi bật tính năng này.
Lưu ý rằng việc xóa thư mục chứa các bản ghi pull image cũng sẽ có tác dụng
tương tự khi kubelet khởi động lại, cụ thể là các image đang được container runtime cache trên các node
đều sẽ được coi là đã được pull sẵn.
Tạo Secret bằng cấu hình Docker
Bạn cần biết tên người dùng, mật khẩu registry và địa chỉ email client để xác thực
với registry, cũng như hostname của registry đó.
Chạy lệnh sau, thay các giá trị giữ chỗ bằng giá trị phù hợp:
Nếu bạn đã có sẵn file thông tin xác thực Docker thì thay vì dùng lệnh
ở trên, bạn có thể import file thông tin xác thực đó thành một
Secret của Kubernetes.
Tạo Secret dựa trên thông tin xác thực Docker hiện có
giải thích cách thiết lập việc này.
Cách này đặc biệt hữu ích nếu bạn đang dùng nhiều container registry
riêng tư, vì kubectl create secret docker-registry tạo ra một Secret
chỉ hoạt động với một registry riêng tư duy nhất.
Lưu ý:
Pod chỉ có thể tham chiếu tới image pull secret trong namespace của chính nó,
vì vậy quy trình này cần được thực hiện một lần cho mỗi namespace.
Tham chiếu imagePullSecrets trên một Pod
Bây giờ, bạn có thể tạo các pod tham chiếu tới secret đó bằng cách thêm phần imagePullSecrets
vào định nghĩa Pod. Mỗi mục trong mảng imagePullSecrets chỉ có thể
tham chiếu tới một Secret trong cùng namespace.
Chuyển dữ liệu nhạy cảm vào một tài nguyên Secret, thay vì đóng gói nó trong image.
Một cluster nhiều tenant (multi-tenant), trong đó mỗi tenant cần registry riêng tư của riêng mình.
Đảm bảo admission controller AlwaysPullImages
đang hoạt động. Nếu không, tất cả các Pod của tất cả các tenant đều có khả năng truy cập vào mọi image.
Chạy một registry riêng tư có yêu cầu phân quyền.
Tạo thông tin xác thực registry cho mỗi tenant, lưu vào một Secret, và phân phối
Secret đó tới namespace của mọi tenant.
Sau đó, tenant thêm Secret đó vào imagePullSecrets của mỗi namespace.
Nếu bạn cần truy cập nhiều registry, bạn có thể tạo một Secret cho mỗi registry.
Kubelet credential provider tích hợp sẵn kiểu cũ
Trong các phiên bản Kubernetes cũ hơn, kubelet được tích hợp trực tiếp với thông tin xác thực
của nhà cung cấp đám mây. Điều này cho phép lấy thông tin xác thực
cho các image registry một cách động.
Có ba bản triển khai tích hợp sẵn của kubelet credential provider:
ACR (Azure Container Registry), ECR (Elastic Container Registry),
và GCR (Google Container Registry).
Kể từ phiên bản 1.26 của Kubernetes, cơ chế cũ này đã bị loại bỏ,
vì vậy bạn cần thực hiện một trong hai cách:
cấu hình kubelet image credential provider trên mỗi node; hoặc
chỉ định thông tin xác thực pull image bằng imagePullSecrets và ít nhất một Secret.
Trang này mô tả các tài nguyên có sẵn cho các Containers trong môi trường Container.
Môi trường container
Môi trường Container trong Kubernetes cung cấp một số tài nguyên quan trọng cho Container:
Một hệ thống tệp tin (filesystem), là sự kết hợp của một image và một hoặc nhiều volumes.
Thông tin về chính container đó.
Thông tin về các đối tượng (object) khác trong cluster.
Thông tin container
Hostname của một Container là tên của Pod mà Container đang chạy trong đó.
Có thể lấy thông tin qua lệnh hostname hoặc lệnh gọi hàm
gethostname
trong libc.
Tên của Pod và namespace có thể lấy ở các biến môi trường thông qua
downward API.
Các biến môi trường do người dùng định nghĩa từ định nghĩa của Pod cũng có trong thông tin của Container,
như là mọi biến môi trường khác được xác định tĩnh trong Docker image.
Thông tin cluster
Một danh sách tất cả các services đang chạy khi một Container được tạo đều có trong Container dưới dạng các biến môi trường.
Các biến môi trường này đều khớp với cú pháp của các Docker links.
Đối với một service có tên là foo ánh xạ với Container có tên là bar,
các biến sau được xác định:
FOO_SERVICE_HOST=<host mà service đang chạy>
FOO_SERVICE_PORT=<port mà service đang chạy>
Các services có địa chỉ IP và có sẵn cho Container thông qua DNS
nếu DNS addon được enable.
Trang này mô tả cách mà kubelet quản lý các Container có thể sử dụng framework Container lifecycle hook để
chạy mã nguồn được kích hoạt bởi các sự kiện trong lifecycle của nó.
Tổng quan
Tương tự như nhiều framework ngôn ngữ lập trình có thành phần các lifecycle hooks, như là Angular,
Kubernetes cung cấp các Container cùng với các lifecycle hook.
Các hooks cho phép các Container nhận thức được các sự kiện trong lifecycle của chúng
và chạy mã nguồn được triển khai trong một trình xử lý khi lifecycle hook tương ứng được thực thi.
Container hooks
Có 2 hooks được cung cấp cho các Containers:
PostStart
Hook này thực thi ngay sau khi một container được tạo mới.
Tuy nhiên, không có gì đảm bảo rằng hook này sẽ thực thi trước container ENTRYPOINT.
Không có tham số nào được truyền cho trình xử lý (handler).
PreStop
Hook này được gọi tức thì ngay trước khi một container bị chấm dứt bởi một API request hoặc sự kiện quản lý như liveness/startup probe failure, preemption, tranh chấp tài nguyên và các vấn đề khác. Một lời gọi tới PreStop hook thất bại nếu container ở trạng thái đã chấm dứt (terminated) hoặc đã hoàn thành (completed) và hook phải hoàn thành trước khi tín hiệu TERM được gửi tới để dừng container.
Thời gian gia hạn chấm dứt của Pod bắt đầu trước khi hook PreStop được chạy, nên Container cuối cùng sẽ chấm dứt trong thời gian gia hạn chấm dứt của Pod bất kể kết quả của handler là gì.
Không có tham số nào được truyền cho trình xử lý (handler).
Xem thêm chi tiết về hành vi chấm dứt (termination behavior) tại
Termination of Pods.
Các cách thực hiện Hook handler (Hook handler implementations)
Các Containers có thể truy cập một hook bằng cách thực hiện và đăng ký một handler cho hook đó.
Có 3 loại hook handler có thể được triển khai cho các Containers:
Exec - Thực thi một lệnh cụ thể, như là pre-stop.sh trong cgroups và namespaces của Container.
Tài nguyên được sử dụng bởi lệnh được tính vào Container.
HTTP - Thực thi một HTTP request với một endpoint cụ thể trên Container.
Sleep - Dừng container trong một khoảng thời gian. Đây là tính năng đang ở
beta-level, được tự động bật bởi PodLifecycleSleepActionfeature gate.
Lưu ý:
Tính năng beta PodLifecycleSleepActionAllowZero được bật mặc định từ bản v1.33.
Tính năng này cho phép bạn thiết lập thời gian sleep là 0 giây (hay không thực hiện hành động
nào) cho các hooks Sleep lifecycle của bạn.
Thực thi hook handler (Hook handler execution)
Khi một hook quản lý Container lifecycle được gọi,
hệ thống quản lý Kubernetes thực thi trình xử lý (handler) dựa trên hành động của hook.
httpGet, tcpSocket (deprecated) và sleep được thực thi bởi tiến trình kubelet, còn exec được thực thi trong container.
Lời gọi hook PostStart handler được khởi tạo khi một container được tạo,
nghĩa là container ENTRYPOINT và hook PostStart được kích hoạt đồng thời.
Tuy nhiên, nếu hook PostStart mất quá nhiều thời gian để chạy hoặc bị treo,
container không thể chuyển sang trạng thái running.
Các hooks PreStop không được thực thi bất đồng bộ với tín hiệu dừng Container; hook phải được hoàn thành thực thi trước khi tín hiệu TERM được gửi.
Nếu hook PreStop bị treo khi thực thi, Pod phase ở trạng thái Terminating và tiếp tục cho tới khi bị chấm dứt sau terminationGracePeriodSeconds hết hạn. Khoảng thời gian gia hạn này bằng tổng thời gian mà cả hook PreStop thực thi và Container dừng lại một cách bình thường.
Ví dụ, nếu terminationGracePeriodSeconds là 60, và hook mất 55 giây để hoàn thành, và Container mất thêm 10 giây để dừng lại sau khi nhận được tín hiệu, thì Container sẽ bị chấm dứt trước khi nó kịp dừng bình thường, vì terminationGracePeriodSeconds nhỏ hơn tổng thời gian cần thiết để thực hiện hai việc này (55+10).
Nếu hook PostStart hoặc PreStop thất bại,
nó sẽ xóa Container.
Người dùng nên làm cho hook handlers nhẹ nhất có thể.
Tuy nhiên, có những trường hợp khi những lệnh chạy dài có ý nghĩa,
chẳng hạn như khi lưu trạng thái trước khi dừng một container.
Hook delivery guarantees
Hook delivery được trù định ít nhất một lần,
điều đó có nghĩa là hook có thể được gọi nhiều lần cho bất kỳ sự kiện cho trước nào,
chẳng hạn như PostStart hoặc PreStop.
Tùy thuộc vào việc thực hiện hook để xử lý việc này một cách chính xác.
Nhìn chung, chỉ có các deliveries đơn được thực hiện.
Ví dụ, nếu một HTTP hook receiver bị down và không thể nhận các traffic,
sẽ không được gửi lại.
Tuy nhiên, trong một số trường hợp hiếm hoi, delivery kép có thể xảy ra.
Chẳng hạn, nếu một kubelet khởi động lại ở giữa quá trình gửi một hook,
hook có thể được gửi lại sau khi kubelet quay trở lại.
Debugging Hook handlers
Log cho một Hook handler không được hiển thị trong các Pod events.
Nếu một handler thất bại vì lí do nào đó, nó sẽ broadcast một event.
Đối với PostStart, đây là event FailedPostStartHook,
và đối với PreStop, đây là event FailedPreStopHook.
Để tự tạo ra một event lỗi FailedPostStartHook, bạn có thể điều chỉnh file
lifecycle-events.yaml
để thay đổi lệnh postStart thành "badcommand" và áp dụng nó.
Dưới đây là một số ví dụ output của events từ việc chạy lệnh kubectl describe pod lifecycle-demo:
Events:
  Type     Reason               Age              From               Message
  ----     ------               ----             ----               -------
  Normal   Scheduled            7s               default-scheduler  Successfully assigned default/lifecycle-demo to ip-XXX-XXX-XX-XX.us-east-2...
  Normal   Pulled               6s               kubelet            Successfully pulled image "nginx" in 229.604315ms
  Normal   Pulling              4s (x2 over 6s)  kubelet            Pulling image "nginx"
  Normal   Created              4s (x2 over 5s)  kubelet            Created container lifecycle-demo-container
  Normal   Started              4s (x2 over 5s)  kubelet            Started container lifecycle-demo-container
  Warning  FailedPostStartHook  4s (x2 over 5s)  kubelet            Exec lifecycle hook ([badcommand]) for Container "lifecycle-demo-container" in Pod "lifecycle-demo_default(30229739-9651-4e5a-9a32-a8f1688862db)" failed - error: command 'badcommand' exited with 126: , message: "OCI runtime exec failed: exec failed: container_linux.go:380: starting container process caused: exec: \"badcommand\": executable file not found in $PATH: unknown\r\n"
  Normal   Killing              4s (x2 over 5s)  kubelet            FailedPostStartHook
  Normal   Pulled               4s               kubelet            Successfully pulled image "nginx" in 215.66395ms
  Warning  BackOff              2s (x2 over 3s)  kubelet            Back-off restarting failed container
Trang này mô tả tài nguyên RuntimeClass và cơ chế lựa chọn runtime.
RuntimeClass là một tính năng dùng để chọn cấu hình container runtime. Cấu hình container runtime
được dùng để chạy các container của một Pod.
Động lực
Bạn có thể đặt RuntimeClass khác nhau cho các Pod khác nhau để cân bằng giữa
hiệu năng và bảo mật. Ví dụ, nếu một phần workload của bạn cần mức đảm bảo
an toàn thông tin cao, bạn có thể chọn lập lịch các Pod đó sao cho
chúng chạy trên một container runtime sử dụng ảo hóa phần cứng. Khi đó bạn sẽ
có thêm khả năng cô lập từ runtime thay thế này, đổi lại là phát sinh thêm một số
chi phí phụ trội (overhead).
Bạn cũng có thể dùng RuntimeClass để chạy các Pod khác nhau với cùng một container runtime
nhưng với các thiết lập khác nhau.
Thiết lập
Cấu hình bản triển khai CRI trên các node (tùy thuộc vào runtime)
Tạo các tài nguyên RuntimeClass tương ứng
1. Cấu hình bản triển khai CRI trên các node
Các cấu hình có thể dùng thông qua RuntimeClass phụ thuộc vào bản triển khai Container Runtime Interface (CRI).
Xem tài liệu tương ứng (bên dưới) của bản triển khai CRI mà bạn dùng
để biết cách cấu hình.
Lưu ý:
Theo mặc định, RuntimeClass giả định rằng cấu hình node là đồng nhất trên toàn cluster (nghĩa là
tất cả các node đều được cấu hình giống nhau về container runtime). Để hỗ trợ
cấu hình node không đồng nhất, xem phần Lập lịch bên dưới.
Mỗi cấu hình có một tên handler tương ứng, được RuntimeClass tham chiếu tới. Handler
phải là một tên DNS label hợp lệ.
2. Tạo các tài nguyên RuntimeClass tương ứng
Mỗi cấu hình được thiết lập ở bước 1 cần có một tên handler đi kèm để định danh
cấu hình đó. Với mỗi handler, hãy tạo một đối tượng RuntimeClass tương ứng.
Tài nguyên RuntimeClass hiện chỉ có 2 trường quan trọng: tên của RuntimeClass
(metadata.name) và handler (handler). Định nghĩa đối tượng trông như sau:
# RuntimeClass được định nghĩa trong API group node.k8s.ioapiVersion:node.k8s.io/v1kind:RuntimeClassmetadata:# Tên dùng để tham chiếu tới RuntimeClass.# RuntimeClass là tài nguyên không thuộc namespace nào.name:myclass # Tên của cấu hình CRI tương ứnghandler:myconfiguration
Tên của một đối tượng RuntimeClass phải là một
tên DNS subdomain hợp lệ.
Lưu ý:
Bạn nên giới hạn các thao tác ghi đối với RuntimeClass (create/update/patch/delete) chỉ cho
quản trị viên cluster. Thông thường đây là thiết lập mặc định. Xem
Tổng quan về phân quyền để biết thêm chi tiết.
Cách sử dụng
Sau khi các RuntimeClass đã được cấu hình cho cluster, bạn có thể chỉ định
runtimeClassName trong đặc tả của Pod để sử dụng. Ví dụ:
Điều này sẽ yêu cầu kubelet dùng RuntimeClass được chỉ định để chạy pod này. Nếu
RuntimeClass được chỉ định không tồn tại, hoặc CRI không thể chạy handler tương ứng, pod sẽ chuyển sang
pha (phase) kết thúc Failed. Hãy tìm
sự kiện (event) tương ứng để xem
thông báo lỗi.
Nếu không chỉ định runtimeClassName, RuntimeHandler mặc định sẽ được sử dụng, tương đương
với hành vi khi tính năng RuntimeClass bị tắt.
Cấu hình CRI
Để biết thêm chi tiết về cách thiết lập các CRI runtime, xem Cài đặt CRI.
Các runtime handler được cấu hình thông qua file cấu hình của containerd tại
/etc/containerd/config.toml. Các handler hợp lệ được cấu hình trong phần runtimes:
Bằng cách chỉ định trường scheduling cho một RuntimeClass, bạn có thể đặt các ràng buộc để
đảm bảo rằng các Pod chạy với RuntimeClass này được lập lịch lên những node hỗ trợ nó.
Nếu không đặt scheduling, Kubernetes giả định rằng tất cả các node đều hỗ trợ RuntimeClass này.
Để đảm bảo các pod được đặt lên những node hỗ trợ một RuntimeClass cụ thể, nhóm node đó cần có một
label chung để trường runtimeclass.scheduling.nodeSelector chọn ra. nodeSelector
của RuntimeClass được hợp nhất với nodeSelector của pod trong bước admission, tức là lấy
phần giao giữa các tập node mà mỗi bên chọn. Nếu có xung đột, pod sẽ bị
từ chối.
Nếu các node được hỗ trợ đã bị gắn taint để ngăn pod của RuntimeClass khác chạy trên node đó, bạn
có thể thêm tolerations vào RuntimeClass. Tương tự như nodeSelector, các toleration được hợp nhất
với toleration của pod trong bước admission, tức là lấy phần hợp giữa các tập node
mà mỗi bên chấp nhận (tolerate).
Để tìm hiểu thêm về cách cấu hình node selector và toleration, xem
Gán Pod cho Node.
Chi phí phụ trội của Pod (Pod Overhead)
TRẠNG THÁI TÍNH NĂNG:GA since Kubernetes v1.24
Bạn có thể chỉ định các tài nguyên overhead gắn với việc chạy một Pod. Việc khai báo overhead cho phép
cluster (bao gồm cả scheduler) tính đến phần này khi đưa ra quyết định về Pod và tài nguyên.
Pod overhead được định nghĩa trong RuntimeClass thông qua trường overhead. Bằng cách sử dụng trường này,
bạn có thể chỉ định overhead khi chạy các pod sử dụng RuntimeClass này và đảm bảo các overhead này
được Kubernetes tính đến.
Kubelet đóng vai trò client khi kết nối tới container runtime thông qua gRPC.
Các endpoint của runtime service và image service phải có sẵn trong container
runtime; bạn có thể cấu hình riêng các endpoint này trong kubelet bằng
cờ dòng lệnh--container-runtime-endpoint.
Với Kubernetes v1.26 trở lên, kubelet yêu cầu container runtime phải
hỗ trợ CRI API v1. Nếu một container runtime không hỗ trợ API v1,
kubelet sẽ không đăng ký node.
Nâng cấp
Khi nâng cấp phiên bản Kubernetes trên một node, kubelet sẽ khởi động lại. Nếu
container runtime không hỗ trợ CRI API v1, kubelet sẽ không thể đăng ký
và sẽ báo lỗi. Nếu cần kết nối lại (re-dial) gRPC vì container
runtime đã được nâng cấp, runtime phải hỗ trợ CRI API v1 thì
kết nối mới thành công. Có thể bạn sẽ cần khởi động lại kubelet sau khi
container runtime đã được cấu hình đúng.
Truyền danh sách theo luồng (list streaming)
TRẠNG THÁI TÍNH NĂNG:Alpha since Kubernetes v1.36; disabled by default
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the CRIListStreaming feature gate for all relevant components in your cluster.
Các RPC liệt kê tiêu chuẩn của CRI (ListContainers, ListPodSandbox, ListImages) trả về
toàn bộ kết quả trong một phản hồi unary duy nhất. Trên các node có số lượng container lớn
(ví dụ, nhiều hơn khoảng 10,000 container, tính cả container đang chạy lẫn đã dừng), các
phản hồi này có thể vượt quá giới hạn kích thước thông điệp mặc định 16 MiB của gRPC, khiến kubelet
gặp lỗi khi đối chiếu (reconcile) trạng thái với container runtime.
Khi bật feature gate CRIListStreaming, kubelet sử dụng các RPC streaming phía
server (chẳng hạn StreamContainers, StreamPodSandboxes,
StreamImages), cho phép container runtime chia kết quả ra
nhiều thông điệp phản hồi, nhờ đó vượt qua giới hạn kích thước của mỗi thông điệp. Điều này
đặc biệt hữu ích cho:
Các môi trường mà container được tạo và hủy liên tục (các hệ thống CI/CD)
Các workload xử lý theo lô (batch) quy mô lớn
Nếu container runtime không hỗ trợ các RPC streaming, kubelet
sẽ tự động quay về dùng các RPC unary tiêu chuẩn để đảm bảo tương thích
ngược.
Quản lý lưu trữ là một bài toán khác hẳn với quản lý các phiên bản tính toán.
Hệ thống con PersistentVolume cung cấp một API cho người dùng và quản trị viên,
giúp tách biệt chi tiết về cách lưu trữ được cung cấp khỏi cách nó được sử dụng.
Để làm điều này, chúng tôi giới thiệu hai tài nguyên API mới: PersistentVolume và PersistentVolumeClaim.
Một PersistentVolume (PV) là một phần lưu trữ trong cluster, được quản trị viên
cấp phát hoặc được cấp phát động bằng
Storage Class. Nó là một tài nguyên trong
cluster, giống như node là một tài nguyên của cluster. PV là các volume plugin giống như
Volume, nhưng có vòng đời độc lập với bất kỳ Pod riêng lẻ nào sử dụng PV đó.
Đối tượng API này nắm giữ các chi tiết về cách triển khai lưu trữ, dù đó là
NFS, iSCSI, hay một hệ thống lưu trữ riêng của nhà cung cấp đám mây.
Một PersistentVolumeClaim (PVC) là một yêu cầu lưu trữ của người dùng. Nó tương tự
như một Pod. Pod tiêu thụ tài nguyên của node, còn PVC tiêu thụ tài nguyên của PV. Pod có thể
yêu cầu các mức tài nguyên cụ thể (CPU và bộ nhớ). Claim có thể yêu cầu kích thước
và chế độ truy cập (access mode) cụ thể (ví dụ: có thể được mount ở chế độ ReadWriteOnce, ReadOnlyMany,
ReadWriteMany, hoặc ReadWriteOncePod, xem AccessModes).
Mặc dù PersistentVolumeClaim cho phép người dùng tiêu thụ tài nguyên lưu trữ trừu tượng,
người dùng thường cần các PersistentVolume với những thuộc tính khác nhau, chẳng hạn như
hiệu năng, cho các bài toán khác nhau. Quản trị viên cluster cần có khả năng
cung cấp nhiều loại PersistentVolume khác nhau không chỉ về kích thước và chế độ
truy cập, mà không để người dùng phải tiếp xúc với chi tiết về cách các volume đó được triển khai.
Để đáp ứng những nhu cầu này, có tài nguyên StorageClass.
PV là các tài nguyên trong cluster. PVC là các yêu cầu đối với những tài nguyên đó và cũng đóng vai trò
như phiếu nhận tài nguyên. Tương tác giữa PV và PVC tuân theo vòng đời sau:
Cấp phát (provisioning)
Có hai cách để cấp phát PV: tĩnh hoặc động.
Tĩnh
Quản trị viên cluster tạo một số PV. Chúng chứa thông tin chi tiết về
lưu trữ thực, sẵn sàng cho người dùng cluster sử dụng. Chúng tồn tại trong
Kubernetes API và sẵn sàng để được tiêu thụ.
Động
Khi không có PV tĩnh nào do quản trị viên tạo khớp với PersistentVolumeClaim của người dùng,
cluster có thể thử cấp phát động một volume dành riêng cho PVC đó.
Việc cấp phát này dựa trên StorageClass: PVC phải yêu cầu một
storage class và
quản trị viên phải đã tạo và cấu hình class đó thì việc cấp phát động
mới diễn ra. Các claim yêu cầu class "" thực chất đã tắt
cấp phát động cho chính chúng.
Để bật cấp phát lưu trữ động dựa trên storage class, quản trị viên cluster
cần bật admission controllerDefaultStorageClass
trên API server. Ví dụ, có thể làm điều này bằng cách đảm bảo DefaultStorageClass nằm
trong danh sách giá trị có thứ tự, phân tách bằng dấu phẩy, của cờ --enable-admission-plugins của
thành phần API server. Để biết thêm thông tin về các cờ dòng lệnh của API server,
hãy xem tài liệu về kube-apiserver.
Gắn kết (binding)
Người dùng tạo, hoặc trong trường hợp cấp phát động thì đã tạo sẵn,
một PersistentVolumeClaim với một lượng lưu trữ cụ thể được yêu cầu và với
một số chế độ truy cập nhất định. Một vòng điều khiển trong control plane theo dõi các PVC mới, tìm
một PV phù hợp (nếu có thể), và gắn chúng với nhau. Nếu một PV được cấp phát động
cho một PVC mới, vòng điều khiển sẽ luôn gắn PV đó với PVC. Ngược lại,
người dùng sẽ luôn nhận được ít nhất những gì họ yêu cầu, nhưng volume có thể
lớn hơn mức được yêu cầu. Một khi đã được gắn, việc gắn kết PersistentVolumeClaim là độc quyền,
bất kể chúng được gắn theo cách nào. Việc gắn kết PVC với PV là ánh xạ một-một,
sử dụng ClaimRef, là một liên kết hai chiều giữa PersistentVolume
và PersistentVolumeClaim.
Claim sẽ ở trạng thái chưa được gắn vô thời hạn nếu không tồn tại volume phù hợp.
Claim sẽ được gắn khi có volume phù hợp. Ví dụ, một
cluster được cấp phát nhiều PV 50Gi sẽ không khớp với một PVC yêu cầu 100Gi.
PVC có thể được gắn khi một PV 100Gi được thêm vào cluster.
Sử dụng
Pod sử dụng claim như volume. Cluster kiểm tra claim để tìm volume
đã được gắn và mount volume đó cho Pod. Với các volume hỗ trợ nhiều
chế độ truy cập, người dùng chỉ định chế độ mong muốn khi sử dụng claim của họ
làm volume trong Pod.
Khi người dùng có một claim và claim đó đã được gắn, PV đã gắn thuộc về
người dùng trong suốt thời gian họ cần. Người dùng lập lịch Pod và truy cập các PV
đã claim bằng cách thêm phần persistentVolumeClaim vào khối volumes của Pod.
Xem Claim dưới dạng volume để biết thêm chi tiết.
Bảo vệ đối tượng lưu trữ đang được sử dụng
Mục đích của tính năng Bảo vệ đối tượng lưu trữ đang được sử dụng (Storage Object in Use Protection) là đảm bảo rằng
các PersistentVolumeClaim (PVC) đang được Pod sử dụng và các PersistentVolume (PV)
đã được gắn với PVC không bị xóa khỏi hệ thống, vì điều này có thể dẫn đến mất dữ liệu.
Lưu ý:
PVC được coi là đang được Pod sử dụng khi tồn tại một đối tượng Pod đang dùng PVC đó.
Nếu người dùng xóa một PVC đang được Pod sử dụng, PVC sẽ không bị xóa ngay lập tức.
Việc xóa PVC được hoãn lại cho đến khi PVC không còn được Pod nào sử dụng. Tương tự,
nếu quản trị viên xóa một PV đã được gắn với một PVC, PV sẽ không bị xóa ngay lập tức.
Việc xóa PV được hoãn lại cho đến khi PV không còn được gắn với PVC nào.
Bạn có thể thấy một PVC đang được bảo vệ khi trạng thái của PVC là Terminating và
danh sách Finalizers có chứa kubernetes.io/pvc-protection:
Khi người dùng không còn cần volume, họ có thể xóa các đối tượng PVC khỏi
API để cho phép thu hồi tài nguyên. Chính sách thu hồi (reclaim policy) của một PersistentVolume
cho cluster biết phải làm gì với volume sau khi nó được giải phóng khỏi claim.
Hiện tại, volume có thể được giữ lại (Retain), tái chế (Recycle), hoặc xóa (Delete).
Retain
Chính sách thu hồi Retain cho phép thu hồi tài nguyên thủ công.
Khi PersistentVolumeClaim bị xóa, PersistentVolume vẫn tồn tại
và volume được coi là "đã giải phóng" (released). Nhưng nó chưa sẵn sàng cho
một claim khác vì dữ liệu của claim trước đó vẫn còn trên volume.
Quản trị viên có thể thu hồi volume thủ công theo các bước sau.
Xóa PersistentVolume. Tài nguyên lưu trữ liên quan trong hạ tầng bên ngoài
vẫn tồn tại sau khi PV bị xóa.
Dọn dẹp thủ công dữ liệu trên tài nguyên lưu trữ liên quan cho phù hợp.
Xóa thủ công tài nguyên lưu trữ liên quan.
Nếu bạn muốn tái sử dụng cùng một tài nguyên lưu trữ, hãy tạo một PersistentVolume mới với
cùng định nghĩa tài nguyên lưu trữ đó.
Delete
Với các volume plugin hỗ trợ chính sách thu hồi Delete, việc xóa sẽ loại bỏ
cả đối tượng PersistentVolume khỏi Kubernetes, lẫn tài nguyên lưu trữ
liên quan trong hạ tầng bên ngoài. Các volume được cấp phát động
kế thừa chính sách thu hồi của StorageClass tương ứng, mà
mặc định là Delete. Quản trị viên nên cấu hình StorageClass
theo mong đợi của người dùng; nếu không, PV phải được chỉnh sửa hoặc
patch sau khi được tạo. Xem
Thay đổi chính sách thu hồi của một PersistentVolume.
Recycle
Cảnh báo:
Chính sách thu hồi Recycle không còn được hỗ trợ. Thay vào đó, cách được khuyến nghị
là sử dụng cấp phát động.
Nếu volume plugin bên dưới hỗ trợ, chính sách thu hồi Recycle sẽ thực hiện
một thao tác xóa cơ bản (rm -rf /thevolume/*) trên volume và làm cho nó sẵn sàng trở lại cho một claim mới.
Tuy nhiên, quản trị viên có thể cấu hình một bản mẫu (template) Pod tái chế tùy chỉnh bằng
các đối số dòng lệnh của Kubernetes controller manager như được mô tả trong
tài liệu tham khảo.
Bản mẫu Pod tái chế tùy chỉnh phải chứa đặc tả volumes, như
trong ví dụ dưới đây:
Tuy nhiên, đường dẫn cụ thể được chỉ định trong phần volumes của bản mẫu Pod tái chế tùy chỉnh
sẽ được thay thế bằng đường dẫn cụ thể của volume đang được tái chế.
Finalizer bảo vệ việc xóa PersistentVolume
This is a stable feature in Kubernetes, and has been since the 1.33 release. You can no longer toggle this feature (the associated feature gate has been removed).
Có thể thêm finalizer vào PersistentVolume để đảm bảo rằng các PersistentVolume
có chính sách thu hồi Delete chỉ bị xóa sau khi lưu trữ bên dưới đã bị xóa.
Finalizer external-provisioner.volume.kubernetes.io/finalizer (được giới thiệu
trong v1.31) được thêm vào cả các CSI volume được cấp phát động lẫn
được cấp phát tĩnh.
Finalizer kubernetes.io/pv-controller (được giới thiệu trong v1.31) được thêm vào
các volume in-tree plugin được cấp phát động và được bỏ qua với các volume
in-tree plugin được cấp phát tĩnh.
Sau đây là ví dụ về một volume in-tree plugin được cấp phát động:
Khi cờ tính năng CSIMigration{provider} được bật cho một in-tree volume plugin cụ thể,
finalizer kubernetes.io/pv-controller sẽ được thay thế bằng finalizer
external-provisioner.volume.kubernetes.io/finalizer.
Các finalizer đảm bảo rằng đối tượng PV chỉ bị xóa sau khi volume đã bị xóa
khỏi backend lưu trữ, với điều kiện chính sách thu hồi của PV là Delete. Điều này
cũng đảm bảo rằng volume bị xóa khỏi backend lưu trữ bất kể
thứ tự xóa PV và PVC.
Bằng cách chỉ định một PersistentVolume trong một PersistentVolumeClaim, bạn khai báo việc gắn kết
giữa PV và PVC cụ thể đó. Nếu PersistentVolume tồn tại và chưa đặt trước
PersistentVolumeClaim nào thông qua trường claimRef của nó, thì PersistentVolume và
PersistentVolumeClaim sẽ được gắn với nhau.
Việc gắn kết diễn ra bất kể một số tiêu chí khớp volume, bao gồm cả node affinity.
Control plane vẫn kiểm tra rằng storage class,
chế độ truy cập và kích thước lưu trữ được yêu cầu là hợp lệ.
apiVersion:v1kind:PersistentVolumeClaimmetadata:name:foo-pvcnamespace:foospec:storageClassName:""# Phải đặt chuỗi rỗng một cách tường minh, nếu không StorageClass mặc định sẽ được đặtvolumeName:foo-pv...
Phương pháp này không đảm bảo bất kỳ quyền ưu tiên gắn kết nào đối với PersistentVolume.
Nếu các PersistentVolumeClaim khác có thể sử dụng PV mà bạn chỉ định, trước tiên bạn
cần đặt trước volume lưu trữ đó. Hãy chỉ định PersistentVolumeClaim liên quan
trong trường claimRef của PV để các PVC khác không thể gắn với nó.
Điều này hữu ích nếu bạn muốn sử dụng các PersistentVolume có persistentVolumeReclaimPolicy được đặt
thành Retain, bao gồm cả trường hợp bạn đang tái sử dụng một PV có sẵn.
Mở rộng Persistent Volume Claim
TRẠNG THÁI TÍNH NĂNG:GA since Kubernetes v1.24
Hỗ trợ mở rộng PersistentVolumeClaim (PVC) được bật theo mặc định. Bạn có thể mở rộng
các loại volume sau:
csi (bao gồm một số loại volume
đã được di chuyển sang CSI)
flexVolume (không còn được hỗ trợ)
portworxVolume (không còn được hỗ trợ)
Bạn chỉ có thể mở rộng một PVC nếu trường allowVolumeExpansion của storage class tương ứng được đặt thành true.
Để yêu cầu một volume lớn hơn cho PVC, hãy chỉnh sửa đối tượng PVC và chỉ định một kích thước
lớn hơn. Việc này kích hoạt mở rộng volume nằm dưới PersistentVolume tương ứng. Một
PersistentVolume mới không bao giờ được tạo để đáp ứng claim. Thay vào đó, volume hiện có sẽ được thay đổi kích thước.
Cảnh báo:
Chỉnh sửa trực tiếp kích thước của một PersistentVolume có thể ngăn việc tự động thay đổi kích thước của volume đó.
Nếu bạn chỉnh sửa dung lượng của một PersistentVolume, rồi chỉnh sửa .spec của
PersistentVolumeClaim tương ứng để kích thước của PersistentVolumeClaim khớp với PersistentVolume,
thì sẽ không có việc thay đổi kích thước lưu trữ nào xảy ra.
Control plane của Kubernetes sẽ thấy rằng trạng thái mong muốn của cả hai tài nguyên đã khớp nhau,
kết luận rằng kích thước volume bên dưới đã được tăng thủ công
và không cần thay đổi kích thước.
Mở rộng CSI volume
TRẠNG THÁI TÍNH NĂNG:GA since Kubernetes v1.24
Hỗ trợ mở rộng CSI volume được bật theo mặc định, nhưng nó cũng yêu cầu
CSI driver cụ thể phải hỗ trợ mở rộng volume. Hãy tham khảo tài liệu của
CSI driver cụ thể đó để biết thêm thông tin.
Thay đổi kích thước volume chứa hệ thống file
Bạn chỉ có thể thay đổi kích thước các volume chứa hệ thống file nếu hệ thống file đó là XFS, Ext3, hoặc Ext4.
Khi một volume chứa hệ thống file, hệ thống file chỉ được thay đổi kích thước khi một Pod mới sử dụng
PersistentVolumeClaim ở chế độ ReadWrite. Việc mở rộng hệ thống file được thực hiện khi Pod đang khởi động,
hoặc khi Pod đang chạy và hệ thống file bên dưới hỗ trợ mở rộng trực tuyến.
FlexVolume (không còn được hỗ trợ kể từ Kubernetes v1.23) cho phép thay đổi kích thước nếu driver được cấu hình với
khả năng RequiresFSResize là true. FlexVolume có thể được thay đổi kích thước khi Pod khởi động lại.
Thay đổi kích thước PersistentVolumeClaim đang được sử dụng
TRẠNG THÁI TÍNH NĂNG:GA since Kubernetes v1.24
Trong trường hợp này, bạn không cần xóa và tạo lại Pod hoặc deployment đang sử dụng PVC hiện có.
Mọi PVC đang được sử dụng sẽ tự động sẵn sàng cho Pod của nó ngay khi hệ thống file của nó đã được mở rộng.
Tính năng này không có tác dụng với các PVC không được Pod hoặc deployment nào sử dụng. Bạn phải tạo một Pod
sử dụng PVC trước khi việc mở rộng có thể hoàn tất.
Tương tự như các loại volume khác - volume FlexVolume cũng có thể được mở rộng khi đang được Pod sử dụng.
Lưu ý:
Chỉ có thể thay đổi kích thước FlexVolume khi driver bên dưới hỗ trợ thay đổi kích thước.
Khôi phục khi mở rộng volume thất bại
Nếu người dùng chỉ định một kích thước mới quá lớn mà hệ thống lưu trữ bên dưới
không thể đáp ứng, việc mở rộng PVC sẽ được thử lại liên tục cho đến khi người dùng hoặc
quản trị viên cluster thực hiện hành động nào đó. Điều này có thể không mong muốn, vì vậy
Kubernetes cung cấp các phương pháp sau để khôi phục từ những lỗi như vậy.
Nếu việc mở rộng lưu trữ bên dưới thất bại, quản trị viên cluster có thể khôi phục thủ công
trạng thái của Persistent Volume Claim (PVC) và hủy các yêu cầu thay đổi kích thước.
Nếu không, các yêu cầu thay đổi kích thước sẽ được controller thử lại liên tục mà không cần
sự can thiệp của quản trị viên.
Đánh dấu PersistentVolume (PV) đã được gắn với PersistentVolumeClaim (PVC)
bằng chính sách thu hồi Retain.
Xóa PVC. Vì PV có chính sách thu hồi Retain nên chúng ta sẽ không mất dữ liệu
khi tạo lại PVC.
Xóa mục claimRef khỏi đặc tả của PV để PVC mới có thể gắn với nó.
Việc này sẽ làm cho PV trở thành Available.
Tạo lại PVC với kích thước nhỏ hơn PV và đặt trường volumeName của
PVC thành tên của PV. Việc này sẽ gắn PVC mới với PV hiện có.
Đừng quên khôi phục chính sách thu hồi của PV.
Nếu việc mở rộng một PVC thất bại, bạn có thể thử mở rộng lại với
kích thước nhỏ hơn giá trị đã yêu cầu trước đó. Để yêu cầu một lần mở rộng mới với
kích thước đề xuất nhỏ hơn, hãy chỉnh sửa .spec.resources của PVC đó và chọn một giá trị nhỏ hơn
giá trị bạn đã thử trước đó.
Điều này hữu ích nếu việc mở rộng lên giá trị cao hơn không thành công do giới hạn dung lượng.
Nếu điều đó đã xảy ra, hoặc bạn nghi ngờ rằng nó có thể đã xảy ra, bạn có thể thử mở rộng lại bằng cách chỉ định một
kích thước nằm trong giới hạn dung lượng của nhà cung cấp lưu trữ bên dưới. Bạn có thể theo dõi trạng thái của
thao tác thay đổi kích thước bằng cách theo dõi .status.allocatedResourceStatuses và các sự kiện trên PVC.
Lưu ý rằng,
mặc dù bạn có thể chỉ định lượng lưu trữ thấp hơn mức đã yêu cầu trước đó,
giá trị mới vẫn phải cao hơn .status.capacity.
Kubernetes không hỗ trợ thu nhỏ một PVC xuống dưới kích thước hiện tại của nó.
Các loại Persistent Volume
Các loại PersistentVolume được triển khai dưới dạng plugin. Kubernetes hiện hỗ trợ các plugin sau:
hostPath - Volume HostPath
(chỉ dùng để kiểm thử trên một node; SẼ KHÔNG HOẠT ĐỘNG trong cluster nhiều node;
hãy cân nhắc sử dụng volume local thay thế)
Các loại PersistentVolume sau không còn được hỗ trợ nhưng vẫn khả dụng.
Nếu bạn đang sử dụng các loại volume này, ngoại trừ flexVolume, cephfs và rbd,
hãy cài đặt các CSI driver tương ứng.
awsElasticBlockStore - AWS Elastic Block Store (EBS)
(di chuyển được bật theo mặc định kể từ v1.23)
azureDisk - Azure Disk
(di chuyển được bật theo mặc định kể từ v1.23)
azureFile - Azure File
(di chuyển được bật theo mặc định kể từ v1.24)
cinder - Cinder (lưu trữ khối của OpenStack)
(di chuyển được bật theo mặc định kể từ v1.21)
flexVolume - FlexVolume
(không còn được hỗ trợ kể từ v1.23, không có kế hoạch di chuyển và không có kế hoạch loại bỏ hỗ trợ)
gcePersistentDisk - GCE Persistent Disk
(di chuyển được bật theo mặc định kể từ v1.23)
portworxVolume - Volume Portworx
(di chuyển được bật theo mặc định kể từ v1.31)
vsphereVolume - Volume vSphere VMDK
(di chuyển được bật theo mặc định kể từ v1.25)
Các phiên bản Kubernetes cũ hơn cũng từng hỗ trợ các loại PersistentVolume in-tree sau:
flocker - Lưu trữ Flocker.
(không khả dụng kể từ v1.25)
glusterfs - Lưu trữ GlusterFS.
(không khả dụng kể từ v1.26)
photonPersistentDisk - Ổ đĩa persistent của Photon controller.
(không khả dụng kể từ v1.15)
quobyte - Volume Quobyte.
(không khả dụng kể từ v1.25)
rbd - Volume Rados Block Device (RBD)
(không khả dụng kể từ v1.31)
scaleIO - Volume ScaleIO.
(không khả dụng kể từ v1.21)
storageos - Volume StorageOS.
(không khả dụng kể từ v1.25)
Persistent Volume
Mỗi PV chứa một spec và một status, tức là đặc tả và trạng thái của volume.
Tên của một đối tượng PersistentVolume phải là một
tên DNS subdomain hợp lệ.
Có thể cần các chương trình hỗ trợ liên quan đến loại volume để sử dụng
một PersistentVolume trong cluster. Trong ví dụ này, PersistentVolume
thuộc loại NFS và cần chương trình hỗ trợ /sbin/mount.nfs để hỗ trợ
việc mount hệ thống file NFS.
Dung lượng
Thông thường, một PV sẽ có một dung lượng lưu trữ cụ thể. Dung lượng này được đặt bằng thuộc tính
capacity của PV, là một giá trị Quantity.
Hiện tại, kích thước lưu trữ là tài nguyên duy nhất có thể được đặt hoặc yêu cầu.
Các thuộc tính trong tương lai có thể bao gồm IOPS, thông lượng, v.v.
Chế độ volume
TRẠNG THÁI TÍNH NĂNG:GA since Kubernetes v1.18
Kubernetes hỗ trợ hai volumeModes cho PersistentVolume: Filesystem và Block.
volumeMode là một tham số API tùy chọn.
Filesystem là chế độ mặc định được dùng khi bỏ qua tham số volumeMode.
Một volume với volumeMode: Filesystem được mount vào một thư mục trong Pod. Nếu volume
dựa trên một thiết bị khối (block device) và thiết bị đó trống, Kubernetes sẽ tạo một hệ thống file
trên thiết bị trước khi mount nó lần đầu tiên.
Bạn có thể đặt giá trị của volumeMode thành Block để sử dụng volume như một thiết bị khối thô (raw block device).
Volume như vậy được trình bày trong Pod dưới dạng một thiết bị khối, không có hệ thống file nào trên đó.
Chế độ này hữu ích để cung cấp cho Pod cách nhanh nhất có thể để truy cập volume, mà không có
lớp hệ thống file nào giữa Pod và volume. Mặt khác, ứng dụng
chạy trong Pod phải biết cách xử lý một thiết bị khối thô.
Xem Hỗ trợ raw block volume
để biết ví dụ về cách sử dụng volume với volumeMode: Block trong Pod.
Chế độ truy cập
Một PersistentVolume có thể được mount trên một host theo bất kỳ cách nào mà nhà cung cấp
tài nguyên hỗ trợ. Như trong bảng dưới đây, các nhà cung cấp sẽ có những khả năng khác nhau
và chế độ truy cập của mỗi PV được đặt theo các chế độ cụ thể mà volume đó
hỗ trợ. Ví dụ, NFS có thể hỗ trợ nhiều client đọc/ghi, nhưng một
PV NFS cụ thể có thể được export trên server ở chế độ chỉ đọc. Mỗi PV có tập hợp
chế độ truy cập riêng mô tả khả năng của chính PV đó.
Các chế độ truy cập gồm:
ReadWriteOnce
volume có thể được mount ở chế độ đọc-ghi bởi một node duy nhất. Chế độ truy cập ReadWriteOnce
vẫn có thể cho phép nhiều pod truy cập (đọc hoặc ghi) volume đó khi các pod
chạy trên cùng một node. Để chỉ một pod truy cập, hãy xem ReadWriteOncePod.
ReadOnlyMany
volume có thể được mount ở chế độ chỉ đọc bởi nhiều node.
ReadWriteMany
volume có thể được mount ở chế độ đọc-ghi bởi nhiều node.
ReadWriteOncePod
TRẠNG THÁI TÍNH NĂNG:GA since Kubernetes v1.29
volume có thể được mount ở chế độ đọc-ghi bởi một Pod duy nhất. Hãy dùng chế độ truy cập
ReadWriteOncePod nếu bạn muốn đảm bảo rằng chỉ một pod trong toàn bộ cluster có thể
đọc hoặc ghi vào PVC đó.
Lưu ý:
Chế độ truy cập ReadWriteOncePod chỉ được hỗ trợ cho
các CSI volume và Kubernetes phiên bản
1.22 trở lên. Để sử dụng tính năng này, bạn cần cập nhật các
CSI sidecar sau
lên các phiên bản này hoặc mới hơn:
Trong CLI, các chế độ truy cập được viết tắt như sau:
RWO - ReadWriteOnce
ROX - ReadOnlyMany
RWX - ReadWriteMany
RWOP - ReadWriteOncePod
Lưu ý:
Kubernetes sử dụng chế độ truy cập của volume để khớp PersistentVolumeClaim với PersistentVolume.
Trong một số trường hợp, chế độ truy cập của volume cũng giới hạn nơi PersistentVolume có thể được mount.
Chế độ truy cập của volume không áp đặt cơ chế chống ghi sau khi lưu trữ đã được mount.
Ngay cả khi chế độ truy cập được chỉ định là ReadWriteOnce, ReadOnlyMany, hoặc ReadWriteMany,
chúng không đặt ra bất kỳ ràng buộc nào lên volume. Ví dụ, ngay cả khi một PersistentVolume được
tạo với ReadOnlyMany, không có gì đảm bảo rằng nó sẽ ở chế độ chỉ đọc. Nếu chế độ truy cập
được chỉ định là ReadWriteOncePod, volume sẽ bị ràng buộc và chỉ có thể được mount trên một Pod duy nhất.
Quan trọng! Một volume chỉ có thể được mount bằng một chế độ truy cập tại một thời điểm,
ngay cả khi nó hỗ trợ nhiều chế độ.
Volume Plugin
ReadWriteOnce
ReadOnlyMany
ReadWriteMany
ReadWriteOncePod
AzureFile
✓
✓
✓
-
CephFS
✓
✓
✓
-
CSI
tùy thuộc vào driver
tùy thuộc vào driver
tùy thuộc vào driver
tùy thuộc vào driver
FC
✓
✓
-
-
FlexVolume
✓
✓
tùy thuộc vào driver
-
HostPath
✓
-
-
-
iSCSI
✓
✓
-
-
NFS
✓
✓
✓
-
RBD
✓
✓
-
-
VsphereVolume
✓
-
- (hoạt động khi các Pod được đặt cùng chỗ)
-
PortworxVolume
✓
-
✓
-
Class
Một PV có thể có một class, được chỉ định bằng cách đặt
thuộc tính storageClassName thành tên của một
StorageClass.
Một PV thuộc một class cụ thể chỉ có thể được gắn với các PVC yêu cầu
class đó. Một PV không có storageClassName thì không có class và chỉ có thể được gắn
với các PVC không yêu cầu class cụ thể nào.
Trước đây, annotation volume.beta.kubernetes.io/storage-class được dùng thay
cho thuộc tính storageClassName. Annotation này vẫn hoạt động; tuy nhiên,
nó sẽ hoàn toàn không còn được hỗ trợ trong một bản phát hành Kubernetes tương lai.
Chính sách thu hồi
Các chính sách thu hồi hiện tại gồm:
Retain -- thu hồi thủ công
Recycle -- xóa cơ bản (rm -rf /thevolume/*)
Delete -- xóa volume
Với Kubernetes 1.37, chỉ các loại volume nfs và hostPath hỗ trợ tái chế.
Tùy chọn mount
Quản trị viên Kubernetes có thể chỉ định các tùy chọn mount bổ sung khi một
Persistent Volume được mount trên một node.
Lưu ý:
Không phải loại Persistent Volume nào cũng hỗ trợ tùy chọn mount.
Các loại volume sau hỗ trợ tùy chọn mount:
csi (bao gồm các loại volume đã được di chuyển sang CSI)
iscsi
nfs
Tùy chọn mount không được xác thực. Nếu một tùy chọn mount không hợp lệ, việc mount sẽ thất bại.
Trước đây, annotation volume.beta.kubernetes.io/mount-options được dùng thay
cho thuộc tính mountOptions. Annotation này vẫn hoạt động; tuy nhiên,
nó sẽ hoàn toàn không còn được hỗ trợ trong một bản phát hành Kubernetes tương lai.
Node affinity
Lưu ý:
Với hầu hết các loại volume, bạn không cần đặt trường này.
Bạn cần đặt trường này một cách tường minh cho các volume local.
Một PV có thể chỉ định node affinity để xác định các ràng buộc giới hạn những node nào
có thể truy cập volume này. Các Pod sử dụng một PV sẽ chỉ được lập lịch lên các node
được node affinity chọn. Để chỉ định node affinity, hãy đặt
nodeAffinity trong .spec của PV. Tài liệu tham khảo API
PersistentVolume
có thêm chi tiết về trường này.
Cập nhật node affinity
TRẠNG THÁI TÍNH NĂNG:Alpha since Kubernetes v1.35; disabled by default
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the MutablePVNodeAffinity feature gate for all relevant components in your cluster.
Nếu feature gateMutablePVNodeAffinity được bật trong cluster của bạn,
trường .spec.nodeAffinity của một PersistentVolume có thể thay đổi được.
Điều này cho phép quản trị viên cluster hoặc controller lưu trữ bên ngoài cập nhật node affinity của một PersistentVolume khi dữ liệu được di chuyển,
mà không làm gián đoạn các pod đang chạy.
Khi cập nhật node affinity, bạn nên đảm bảo rằng node affinity mới vẫn khớp với các node mà volume hiện đang được sử dụng.
Với các pod vi phạm affinity mới, nếu pod đã đang chạy thì nó có thể tiếp tục chạy. Nhưng Kubernetes không hỗ trợ cấu hình này.
Bạn nên sớm chấm dứt các pod vi phạm.
Do cơ chế cache trong bộ nhớ, các pod được tạo sau khi cập nhật vẫn có thể được lập lịch theo node affinity cũ trong một khoảng thời gian ngắn.
Để sử dụng tính năng này, bạn nên bật feature gate MutablePVNodeAffinity trên các thành phần sau:
kube-apiserver
kubelet
Giai đoạn
Một PersistentVolume sẽ ở một trong các giai đoạn (phase) sau:
Available
một tài nguyên rảnh, chưa được gắn với claim nào
Bound
volume đã được gắn với một claim
Released
claim đã bị xóa, nhưng tài nguyên lưu trữ liên quan chưa được cluster thu hồi
Failed
volume đã thất bại trong quá trình thu hồi (tự động)
Bạn có thể xem tên của PVC được gắn với PV bằng lệnh kubectl describe persistentvolume <name>.
Dấu thời gian chuyển giai đoạn
This is a stable feature in Kubernetes, and has been since the 1.31 release. You can no longer toggle this feature (the associated feature gate has been removed).
Trường .status của một PersistentVolume có thể bao gồm trường alpha lastPhaseTransitionTime. Trường này ghi lại
dấu thời gian của lần cuối cùng volume chuyển giai đoạn. Với các volume
mới được tạo, giai đoạn được đặt là Pending và lastPhaseTransitionTime được đặt là
thời điểm hiện tại.
PersistentVolumeClaim
Mỗi PVC chứa một spec và một status, tức là đặc tả và trạng thái của claim.
Tên của một đối tượng PersistentVolumeClaim phải là một
tên DNS subdomain hợp lệ.
apiVersion:v1kind:PersistentVolumeClaimmetadata:name:myclaimspec:accessModes:- ReadWriteOncevolumeMode:Filesystemresources:requests:storage:8GistorageClassName:slowselector:matchLabels:release:"stable"matchExpressions:- {key: environment, operator: In, values:[dev]}
Claim sử dụng cùng quy ước như volume để cho biết
volume được sử dụng dưới dạng hệ thống file hay thiết bị khối.
Tên volume
Claim có thể sử dụng trường volumeName để gắn một cách tường minh với một PersistentVolume cụ thể. Bạn cũng có thể để
volumeName trống, cho biết rằng bạn muốn Kubernetes thiết lập một PersistentVolume mới
khớp với claim.
Nếu PV được chỉ định đã được gắn với một PVC khác, việc gắn kết sẽ bị kẹt
ở trạng thái chờ (pending).
Tài nguyên
Giống như Pod, claim có thể yêu cầu một lượng tài nguyên cụ thể. Trong trường hợp này,
yêu cầu là dành cho lưu trữ. Cùng một
mô hình tài nguyên
áp dụng cho cả volume và claim.
Lưu ý:
Với các volume Filesystem, yêu cầu lưu trữ đề cập đến kích thước volume "bên ngoài"
(tức là kích thước được cấp phát từ backend lưu trữ).
Điều này có nghĩa là kích thước có thể ghi được có thể thấp hơn một chút đối với các nhà cung cấp
xây dựng hệ thống file trên một thiết bị khối, do chi phí phụ trội của hệ thống file.
Điều này đặc biệt dễ thấy với XFS, nơi nhiều tính năng siêu dữ liệu (metadata) được bật theo mặc định.
Selector
Claim có thể chỉ định một
label selector
để lọc thêm tập hợp các volume.
Chỉ những volume có label khớp với selector mới có thể được gắn với claim.
Selector có thể gồm hai trường:
matchLabels - volume phải có một label với giá trị này
matchExpressions - một danh sách các yêu cầu được tạo bằng cách chỉ định key, danh sách giá trị,
và toán tử liên hệ giữa key và các giá trị.
Các toán tử hợp lệ gồm In, NotIn, Exists và DoesNotExist.
Tất cả các yêu cầu, từ cả matchLabels và matchExpressions, được
kết hợp bằng phép AND – tất cả đều phải được thỏa mãn thì mới khớp.
Class
Một claim có thể yêu cầu một class cụ thể bằng cách chỉ định tên của một
StorageClass
qua thuộc tính storageClassName.
Chỉ những PV thuộc class được yêu cầu, tức là những PV có cùng storageClassName với PVC,
mới có thể được gắn với PVC.
PVC không nhất thiết phải yêu cầu một class. Một PVC có storageClassName được đặt
bằng "" luôn được hiểu là đang yêu cầu một PV không có class, do đó nó
chỉ có thể được gắn với các PV không có class (không có annotation hoặc annotation được đặt bằng "").
Một PVC không có storageClassName thì không hoàn toàn giống vậy và được cluster
xử lý khác đi, tùy thuộc vào việc
admission plugin DefaultStorageClass
có được bật hay không.
Nếu admission plugin được bật, quản trị viên có thể chỉ định một StorageClass mặc định.
Tất cả các PVC không có storageClassName chỉ có thể được gắn với các PV thuộc class mặc định đó.
Việc chỉ định StorageClass mặc định được thực hiện bằng cách đặt annotation
storageclass.kubernetes.io/is-default-class bằng true trong một đối tượng StorageClass.
Nếu quản trị viên không chỉ định class mặc định, cluster sẽ phản hồi việc tạo PVC
như thể admission plugin đã bị tắt.
Nếu có nhiều hơn một StorageClass mặc định được chỉ định, class mặc định mới nhất sẽ được dùng khi
PVC được cấp phát động.
Nếu admission plugin bị tắt, sẽ không có khái niệm StorageClass mặc định.
Tất cả các PVC có storageClassName được đặt thành "" chỉ có thể được gắn với các PV
cũng có storageClassName được đặt thành "".
Tuy nhiên, các PVC thiếu storageClassName có thể được cập nhật sau khi StorageClass mặc định khả dụng.
Nếu PVC được cập nhật, nó sẽ không còn gắn với các PV có storageClassName cũng được đặt thành "".
Tùy thuộc vào phương thức cài đặt, một StorageClass mặc định có thể được addon manager triển khai
vào cluster Kubernetes trong quá trình cài đặt.
Khi một PVC chỉ định một selector ngoài việc yêu cầu một StorageClass,
các yêu cầu được kết hợp bằng phép AND: chỉ một PV thuộc class được yêu cầu và có
các label được yêu cầu mới có thể được gắn với PVC.
Lưu ý:
Hiện tại, một PVC có selector không rỗng không thể được cấp phát động một PV.
Trước đây, annotation volume.beta.kubernetes.io/storage-class được dùng thay
cho thuộc tính storageClassName. Annotation này vẫn hoạt động; tuy nhiên,
nó sẽ không được hỗ trợ trong một bản phát hành Kubernetes tương lai.
Gán StorageClass mặc định hồi tố
TRẠNG THÁI TÍNH NĂNG:GA since Kubernetes v1.28
Bạn có thể tạo một PersistentVolumeClaim mà không chỉ định storageClassName
cho PVC mới, và bạn có thể làm vậy ngay cả khi không có StorageClass mặc định nào tồn tại
trong cluster của bạn. Trong trường hợp này, PVC mới được tạo đúng như bạn đã định nghĩa, và
storageClassName của PVC đó vẫn chưa được đặt cho đến khi có class mặc định.
Khi một StorageClass mặc định trở nên khả dụng, control plane sẽ xác định mọi
PVC hiện có không có storageClassName. Với các PVC có giá trị rỗng
cho storageClassName hoặc không có key này, control plane sau đó sẽ
cập nhật các PVC đó để đặt storageClassName khớp với StorageClass mặc định mới.
Nếu bạn có một PVC hiện có với storageClassName là "", và bạn cấu hình
một StorageClass mặc định, thì PVC này sẽ không được cập nhật.
Để tiếp tục gắn với các PV có storageClassName được đặt thành ""
(trong khi có một StorageClass mặc định), bạn cần đặt storageClassName
của PVC liên quan thành "".
Hành vi này giúp quản trị viên thay đổi StorageClass mặc định bằng cách xóa
class cũ trước rồi tạo hoặc đặt một class khác. Khoảng thời gian ngắn
không có class mặc định này khiến các PVC không có storageClassName được tạo vào lúc đó
không có class mặc định nào, nhưng nhờ việc gán StorageClass mặc định
hồi tố, cách thay đổi class mặc định này là an toàn.
Theo dõi PVC không được sử dụng
TRẠNG THÁI TÍNH NĂNG:Beta since Kubernetes v1.37; enabled by default
Khi được bật, PVC protection controller sẽ thêm một
conditionUnused vào mỗi
PersistentVolumeClaim để cho biết liệu nó hiện có đang được tham chiếu bởi
Pod nào chưa ở trạng thái kết thúc (non-terminal) hay không.
Condition này có hai trạng thái:
Unused với status "True" (reason NoPodsUsingPVC)
Không có Pod chưa kết thúc nào tham chiếu đến PVC này. lastTransitionTime ghi lại thời điểm
PVC trở nên không được sử dụng.
Unused với status "False" (reason PodUsingPVC)
Có ít nhất một Pod chưa kết thúc hiện đang tham chiếu đến PVC này.
lastTransitionTime ghi lại thời điểm PVC bắt đầu được sử dụng.
Một Pod được coi là chưa kết thúc nếu giai đoạn của nó không phải là Succeeded hoặc Failed.
Điều này có nghĩa là một Pod ở trạng thái Pending (kể cả Pod chưa được lập lịch) cũng được tính
là đang sử dụng PVC.
lastTransitionTime của condition Unused có thể được quản trị viên cluster,
các công cụ giám sát và các controller bên ngoài sử dụng để xác định những PVC
đã không được sử dụng trong thời gian dài. Ví dụ, để tìm tất cả các PVC đã
không được sử dụng hơn 30 ngày, bạn có thể truy vấn các PVC có condition Unused
với status: "True" và lastTransitionTime cũ hơn 30 ngày.
Lưu ý:
Khoảng thời gian không sử dụng mà condition này cho biết có thể ngắn hơn thời gian
không sử dụng thực tế do độ trễ xử lý trong controller hoặc do
tính năng được bật sau khi PVC đã không được sử dụng. Condition này không được
cập nhật khi PVC có deletionTimestamp được đặt (tức là các PVC đang bị xóa).
Claim dưới dạng volume
Pod truy cập lưu trữ bằng cách sử dụng claim như một volume. Claim phải tồn tại trong
cùng namespace với Pod sử dụng claim đó. Cluster tìm claim trong
namespace của Pod và sử dụng nó để lấy PersistentVolume nằm dưới claim.
Sau đó volume được mount vào host và vào Pod.
Việc gắn kết PersistentVolume là độc quyền, và vì PersistentVolumeClaim là
các đối tượng thuộc namespace, việc mount claim với các chế độ "Many" (ROX, RWX) chỉ
có thể thực hiện trong phạm vi một namespace.
PersistentVolume loại hostPath
Một PersistentVolume hostPath sử dụng một file hoặc thư mục trên Node để mô phỏng
lưu trữ gắn qua mạng. Xem
ví dụ về volume loại hostPath.
Hỗ trợ raw block volume
TRẠNG THÁI TÍNH NĂNG:GA since Kubernetes v1.18
Các volume plugin sau hỗ trợ raw block volume, bao gồm cả cấp phát động khi
có thể áp dụng:
CSI (bao gồm một số loại volume đã được di chuyển sang CSI)
Khi thêm một raw block device cho Pod, bạn chỉ định đường dẫn thiết bị trong
container thay vì đường dẫn mount.
Gắn kết block volume
Nếu người dùng yêu cầu một raw block volume bằng cách chỉ định điều này qua trường volumeMode
trong đặc tả PersistentVolumeClaim, các quy tắc gắn kết sẽ hơi khác so với
các bản phát hành trước, vốn không coi chế độ này là một phần của đặc tả.
Dưới đây là bảng các tổ hợp mà người dùng và quản trị viên có thể chỉ định khi
yêu cầu một raw block device. Bảng cho biết volume có được gắn hay
không với từng tổ hợp: Ma trận gắn kết volume cho các volume được cấp phát tĩnh:
PV volumeMode
PVC volumeMode
Kết quả
không chỉ định
không chỉ định
GẮN KẾT
không chỉ định
Block
KHÔNG GẮN KẾT
không chỉ định
Filesystem
GẮN KẾT
Block
không chỉ định
KHÔNG GẮN KẾT
Block
Block
GẮN KẾT
Block
Filesystem
KHÔNG GẮN KẾT
Filesystem
Filesystem
GẮN KẾT
Filesystem
Block
KHÔNG GẮN KẾT
Filesystem
không chỉ định
GẮN KẾT
Lưu ý:
Chỉ các volume được cấp phát tĩnh mới được hỗ trợ trong bản phát hành alpha. Quản trị viên
nên cân nhắc kỹ các giá trị này khi làm việc với raw block device.
Hỗ trợ volume snapshot và khôi phục volume từ snapshot
TRẠNG THÁI TÍNH NĂNG:GA since Kubernetes v1.20
Volume snapshot chỉ hỗ trợ các CSI volume plugin out-of-tree.
Để biết chi tiết, xem Volume Snapshot.
Các in-tree volume plugin không còn được hỗ trợ. Bạn có thể đọc về các volume plugin
không còn được hỗ trợ trong
Câu hỏi thường gặp về Volume Plugin.
Nhân bản volume và
khôi phục snapshot điền sẵn dữ liệu
cho một volume mới từ một nguồn dữ liệu (data source) có sẵn. Volume populator mở rộng cơ chế này để
một PersistentVolumeClaim có thể được điền sẵn dữ liệu từ các loại nguồn khác (một custom resource),
được tham chiếu thông qua trường dataSourceRef của nó:
Nếu bạn đang viết các bản mẫu cấu hình hoặc ví dụ chạy trên nhiều loại cluster khác nhau
và cần lưu trữ persistent, bạn nên sử dụng mô hình sau:
Đưa các đối tượng PersistentVolumeClaim vào gói cấu hình của bạn (cùng với
Deployment, ConfigMap, v.v.).
Không đưa các đối tượng PersistentVolume vào cấu hình, vì người dùng khởi tạo
cấu hình có thể không có quyền tạo PersistentVolume.
Cho người dùng tùy chọn cung cấp tên storage class khi khởi tạo
bản mẫu.
Nếu người dùng cung cấp tên storage class, hãy đặt giá trị đó vào
trường persistentVolumeClaim.storageClassName.
Điều này sẽ khiến PVC khớp với storage class
phù hợp nếu cluster có StorageClass được quản trị viên bật.
Nếu người dùng không cung cấp tên storage class, hãy để trường
persistentVolumeClaim.storageClassName là nil. Điều này sẽ khiến một
PV được tự động cấp phát cho người dùng với StorageClass mặc định
trong cluster. Nhiều môi trường cluster có cài đặt sẵn một StorageClass mặc định,
hoặc quản trị viên có thể tạo StorageClass mặc định của riêng họ.
Trong công cụ của bạn, hãy theo dõi các PVC không được gắn sau một khoảng thời gian
và thông báo điều này cho người dùng, vì điều này có thể cho thấy cluster không có
hỗ trợ lưu trữ động (trong trường hợp đó người dùng nên tạo một PV phù hợp)
hoặc cluster không có hệ thống lưu trữ (trong trường hợp đó người dùng không thể triển khai
cấu hình yêu cầu PVC).
Kubernetes cho phép bạn cấu hình mạng IPv4 đơn, mạng IPv6 đơn, hoặc mạng kép với cả hai họ mạng hoạt động. Trang này giải thích cách thức hoạt động.
Trang này đang được dịch. Vui lòng xem phiên bản tiếng Anh để biết thông tin mới nhất.
3.11 - Mở rộng Kubernetes
Các cách khác nhau để thay đổi hành vi của cluster Kubernetes của bạn.
Trang này đang được dịch. Vui lòng xem phiên bản tiếng Anh để biết thông tin mới nhất.
3.12 - ReplicaSet
Mục đích của ReplicaSet là duy trì một tập hợp ổn định các Pod bản sao đang chạy tại bất kỳ thời điểm nào. Thông thường, bạn định nghĩa một Deployment và để Deployment đó quản lý các ReplicaSet tự động.
Trang này đang được dịch. Vui lòng xem phiên bản tiếng Anh để biết thông tin mới nhất.
4 - Tasks
Phần này của tài liệu chứa các hướng dẫn thực hiện các tác vụ. Mỗi tài liệu hướng dẫn tác vụ chỉ dẫn cách thực hiện một việc duy nhất, thường bằng cách đưa ra một chuỗi các bước ngắn.
Các tác vụ bao gồm: Cài đặt tool, chạy jobs, quản lý GPUs, etc.
Thiết lập các công cụ Kubernetes trên máy tính của bạn.
kubectl
Công cụ dòng lệnh Kubernetes, kubectl, cho phép
bạn chạy các câu lệnh tương tác tới các cụm Kubernetes.
Bạn có thể sử dụng kubectl để triển khai các ứng dụng, kiểm tra và quản lý các tài nguyên của cụm,
và xem log. Để biết thêm thông tin bao gồm một danh sách đầy đủ các lệnh của kubectl, xem
tài liệu tham khảo kubectl.
kubectl có thể cài đặt trên nhiều nền tảng Linux, macOS và Windows.
Chọn hệ điều hành ưa thích của bạn bên dưới.
Giống kind, minikube là một công cụ cho phép bạn chạy Kubernetes
cục bộ. minikube chạy một cụm Kubernetes cục bộ tất-cả-trong-một hoặc nhiều-node trên máy tính cá nhân (bao gồm Windows, macOS và Linux) vì vậy bạn có thể thử
Kubernetes, hoặc cho công việc phát triển hàng ngày.
Bạn có thể theo dõi hướng dẫn chính thức
Bắt đầu! nếu bạn tập trung vào
việc cài đặt công cụ.
Bạn có thể dùng công cụ kubeadm để tạo và quản lý các cụm Kubernetes.
Nó thực hiện các hành động cần thiết để có được sự khả thi tối thiểu, đảm bảo cụm khởi động và chạy theo một cách thân thiện với người dùng.
Cài đặt kubeadm hướng dẫn bạn cách để cài đặt kubeadm.
Một khi được cài đặt, bạn có thể dùng nó để tạo một cụm.
Công cụ command-line trong Kubernetes, kubectl, cho phép bạn thực thi các câu lệnh trong Kubernetes clusters. Bạn có thể sử dụng kubectl để triển khai các ứng dụng, theo dõi và quản lý tài nguyên của cluster, và xem log. Để biết các thao tác của kubectl, truy cập tới Tổng quan về kubectl.
Trước khi bạn bắt đầu
Bạn cần phải sử dụng phiên bản kubectl sai lệch không quá một phiên bản với version của cluster. Ví dụ, một client v1.2 nên được hoạt động với master v1.1, v1.2 và v1.3. Sử dụng phiên bản mới nhất của kubectl giúp tránh được các vấn đề không lường trước được.
Kiểm tra chắn chắn phiên bản kubectl giống với bản đã tải về:
kubectl version
Lưu ý:
Docker Desktop cho Windows thêm phiên bản kubectl riêng của nó vào PATH.
Nếu bạn đã cài đặt Docker Desktop trước đây, bạn có thể cần đặt đường dẫn PATH của bạn trước khi bản cài đặt Docker Desktop thêm 1 PATH vào hoặc loại bỏ kubectl của Docker Desktop.
Cài đặt với Powershell từ PSGallery
Nếu bạn đang ở trên Windows và sử dụng trình quản lý gói Powershell Gallery, bạn có thể cài đặt và cập nhật kubectl với Powershell.
Thực thi các câu lệnh cài đặt sau (hãy đảm bảo bạn tự định nghĩa DownloadLocation):
Kiểm tra chắc chắn rằng phiên bản bạn cài là mới nhất:
kubectl version
Xác minh cấu hình kubectl
Để kubectl tìm kiếm và truy cập Kubernetes cluster, nó cần một kubeconfig file, được tự động tạo ra khi bạn tạo mới một cluster sử dụng kube-up.sh hoặc triển khai thành công một Minikube cluster. Mặc định thì cấu hình của kubectl được xác định tại ~/.kube/config.
Kiểm tra kubectl được cấu hình đúng bằng việc xem trạng thái của cluster:
kubectl cluster-info
Nếu bạn trông thấy một URL phản hồi, thì kubectl đã được cấu hình đúng để truy cập vào cluster của bạn.
Nếu bạn trông thấy một tin nhắn tương tự bên dưới, thì kuberctl chưa được cấu hình đúng hoặc chưa thể kết nối với Kubernetes cluster.
The connection to the server <server-name:port> was refused - did you specify the right host or port?
Ví dụ như, nếu bạn đang định chạy một Kubernetes cluster trên laptop của bạn (locally), bạn sẽ cần một công cụ như Minikube được cài trước đó và chạy lại các câu lệnh bên trên.
Nếu kubectl cluster-info trả về url nhưng bạn không thể truy cập vào cluster của bạn, thì hãy kiểm tra nó đã được cấu hình đúng hay chưa, bằng cách:
kubectl cluster-info dump
Các lựa chọn cấu hình kubectl
Kích hoạt shell autocompletion
kubectl cung cấp autocompletion hỗ trợ cho Bash and Zsh, giúp bạn giảm thiểu việc phải gõ nhiều câu lệnh.
Bên dưới đâu là các bước để thiết lập autocompletion cho Bash (bao gồm sự khác nhau giữa Linux và macOS) và Zsh.
Giới thiệu
Kubelet completion script cho Bash được tạo ra với câu lệnh kubectl completion bash. Sau khi script được tạo ra, bạn cần source (thực thi) script đó để kích hoạt tính năng autocompletion.
Tuy nhiên, completion script phụ thuộc vào bash-completion, nên bạn phải cài đặt bash-completion trước đó (kiểm tra bash-completion tồn tại với câu lệnh type _init_completion).
Cài đặt bash-completion
bash-completion được cung cấp bởi nhiều trình quản lý gói (xem tại đây). Bạn có thể cài đặt với lệnh apt-get install bash-completion hoặc yum install bash-completion.
Các lệnh trên tạo ra /usr/share/bash-completion/bash_completion, đây là script chính của bash-completion. Tùy thuộc vào trình quản lý gói của bạn, mà bạn phải source (thực thi) file này trong file ~/.bashrc.
Để tìm ra file này, reload lại shell hiện tại của bạn và chạy lệnh type _init_completion. Nếu thành công, bạn đã thiết lập xong, không thì hãy thêm đoạn sau vào file ~/.bashrc của bạn:
source /usr/share/bash-completion/bash_completion
Reload lại shell của bạn và xác nhận bash-completion được cài đặt đúng bằng lệnh type _init_completion.
Kích hoạt kubectl autocompletion
Bây giờ bạn cần đảm bảo rằng kubectl completion script được sourced trên tất cả các session của shell. Có 2 cách để làm việc này:
Nếu bạn có một alias cho kubectl, bạn có thể thêm một shell completion nữa cho alias đó:
echo'alias k=kubectl' >>~/.bashrc
echo'complete -F __start_kubectl k' >>~/.bashrc
Lưu ý:
bash-completion sources tất cả completion scripts trong /etc/bash_completion.d.
Các cách trên đều hiệu quả tương đương nhau. Sau khi reload lại shell, kubectl autocompletion sẽ làm việc.
Giới thiệu
Kubectl completion script trên Bash được tạo ra bởi kubectl completion bash. Source script này sẽ kích hoạt tính năng kubectl completion.
Tuy nhiên, kubectl completion script phụ thuộc vào bash-completion mà bạn cài trước đó.
Cảnh báo:
Có 2 phiên bản của bash-completion là v1 và v2. V1 dành cho Bash 3.2 (Bash mặc định trên macOS), và v2 dành cho Bash 4.1+. Kubectl completion script không làm việc phù hợp với bash-completion v1 và Bash 3.2. Nó tương thích với bash-completion v2 và Bash 4.1+. Vì vậy, để sử dụng kubectl completion một cách chính xác trên macOS thì bạn phải cài đặt Bash 4.1+ (hướng dẫn). Hướng dẫn tiếp theo giả định rằng bạn đang sử dụng Bash 4.1+ (nghĩa là, bất kỳ phiên bản Bash nào từ 4.1 trở lên).
Cài đặt bash-completion
Lưu ý:
Như đã đề cập, những hướng dẫn này giả định bạn đang sử dụng Bash 4.1+, có nghĩa rằng bạn sẽ cài đặt bash-completion v2 (trái ngược với Bash 3.2 và bash-completion v1, trong trường hợp đó, kubectl completion sẽ không hoạt động).
Bạn có thể kiểm tra bash-completion v2 đã cài đặt trước đó chưa với lệnh type _init_completion. Nếu chưa, bạn có thể cài đặt nó với Homebrew:
brew install bash-completion@2
Từ đầu ra của lệnh này, hãy thêm đoạn sau vào file ~/.bashrc của bạn:
Nếu bạn có alias cho kubectl, bạn có thể mở rộng shell completion để làm việc với alias đó:
echo'alias k=kubectl' >>~/.bashrc
echo'complete -F __start_kubectl k' >>~/.bashrc
Nếu bạn đã cài kubectl với Homebrew (như đã giới thiệu bên trên)) thì kubectl completion script sẽ có trong /usr/local/etc/bash_completion.d/kubectl. Trong trường hợp này thì bạn không cần làm gì cả.
Lưu ý:
Cài đặt theo cách Homebrew đã source tất cả các tệp trong thư mục BASH_COMPLETION_COMPAT_DIR, đó là lý do tại sao hai phương thức sau hoạt động.
Trong mọi trường hợp, sau khi tải lại shell của bạn, kubectl completion sẽ hoạt động.
Kubectl completion script cho Zsh được tạo ra với lệnh kubectl completion zsh. Source completion script trong shell của bạn sẽ kích hoạt kubectl autocompletion.
Để nó hoạt động cho tất cả các shell, thêm dòng sau vào file ~/.zshrc:
source <(kubectl completion zsh)
Nếu bạn có alias cho kubectl, bạn có thể mở rộng shell completion để làm việc với alias đó:
echo'alias k=kubectl' >>~/.zshrc
echo'compdef __start_kubectl k' >>~/.zshrc
Sau khi tải lại shell, kubectl autocompletion sẽ hoạt động.
Nếu bạn nhận được lỗi complete:13: command not found: compdef, thêm dòng sau vào đầu file ~/.zshrc:
Tài liệu này sẽ hướng dẫn các bạn cách cài đặt Minikube, một công cụ chạy một Kubernetes cluster chỉ gồm một node trong một máy ảo (VM) trên máy tính của bạn.
Trước khi bạn bắt đầu
Để kiểm tra xem việc ảo hóa (virtualization) có được hỗ trợ trên Linux không, chạy lệnh sau và chắc chắn rằng kết quả trả về là non-empty:
grep -E --color 'vmx|svm' /proc/cpuinfo
Để kiểm tra xem việc ảo hóa (virtualization) có được hỗ trợ trên macOS không, chạy lệnh sau trên terminal:
sysctl -a | grep -E --color 'machdep.cpu.features|VMX'
Nếu bạn thấy VMX ở kết quả trả về (có màu), thì VT-x đã được hỗ trợ.
Để kiểm tra xem việc ảo hóa (virtualization) có được hỗ trợ trên Windows 8 và các phiên bản Windows cao hơn không, chạy lệnh sau trên terminal của Windows hoặc command promt.
systeminfo
Nếu bạn thấy những thông tin sau, ảo hóa được hỗ trợ trên Windows.
Hyper-V Requirements:     VM Monitor Mode Extensions: Yes
                          Virtualization Enabled In Firmware: Yes
                          Second Level Address Translation: Yes
                          Data Execution Prevention Available: Yes
Nếu bạn thấy thông tin sau, thì hệ thống đã được cài đặt Hypervisor và bạn có thể bỏ qua bước tiếp theo.
Hyper-V Requirements: A hypervisor has been detected. Features required for Hyper-V will not be displayed.
Cài đặt minikube
Cài đặt kubectl
Đảm bảo bạn đã cài đặt kubectl. Bạn có thể cài đặt kubectl theo hướng dẫn sau tại Install and Set Up kubectl.
Cài đặt Hypervisor
Nếu bạn chưa cài đặt Hypervisor, hãy cài đặt một trong những phần mềm sau đây:
Minikube cũng hỗ trợ tùy chọn --vm-driver=none để chạy các thành phần của Kubernetes ngay trên máy chủ chứ không phải trong một VM. Sử dụng driver này yêu cầu Docker và môi trường Linux chứ không phải một Hypervisor. Bạn nên sử dụng cài đặt apt của docker từ Docker khi sử dụng non driver. Cài đặt snap của docker không hoạt động với minikube.
Cài đặt Minikube sử dụng package
Có các gói thử nghiệm cho Minikube có sẵn; bạn có thể tìm thấy các gói Linux (AMD64) từ trang phát hành của Minikube trên Github.
Sử dụng các package tool của bản phân phối Linux của bạn để cài đặt package phù hợp.
Cài đặt Minikube thông qua tải xuống trực tiếp
Nếu bạn không cài đặt qua package, bạn có thể tải xuống bản binary và sử dụng.
Thực hiện các tác vụ cấu hình thông dụng cho Pods và containers.
4.2.1 - Cấp phát tài nguyên bộ nhớ cho Containers và Pods
Trang này hướng dẫn cách cấp phát bộ nhớ request (tối thiểu) và bộ nhớ limit (tối đa) cho một Container. Một Container được đảm bảo có đủ bộ nhớ như nó yêu cầu, nhưng không được phép sử dụng nhiều bộ nhớ hơn giới hạn của nó.
Trước khi bạn bắt đầu
Bạn cần có một cluster Kubernetes, và kubectl phải được cấu hình để giao tiếp với cluster của bạn. Khuyến nghị nên chạy hướng dẫn này trên một cluster có ít nhất hai node không đóng vai trò là máy chủ control plane. Nếu bạn chưa có cluster, bạn có thể tạo một cluster bằng cách sử dụng minikube hoặc sử dụng một trong các sân chơi Kubernetes sau:
Để kiểm tra phiên bản của kubectl, hãy chạy lệnh kubectl version.
Để kiểm tra phiên bản, nhập kubectl version.
Mỗi Node trong Cluster của bạn phải có ít nhất 300 MiB bộ nhớ.
Một số bước trong trang này yêu cầu bạn chạy dịch vụ metrics-server trong Cluster. Nếu bạn đã có metrics-server đang chạy, bạn có thể bỏ qua các bước này.
Nếu bạn đang chạy Minikube, hãy chạy lệnh sau để bật metrics-server:
minikube addons enable metrics-server
Để kiểm tra xem metrics-server có đang chạy hay không, hoặc hệ thống giám sát tài nguyên khác (metrics.k8s.io), hãy chạy lệnh sau:
kubectl get apiservices
Nếu hệ thống giám sát tài nguyên có sẵn, kết quả sẽ chứa metrics.k8s.io.
NAME
v1beta1.metrics.k8s.io
Tạo namespace
Tạo một namespace để các tài nguyên mà bạn tạo trong bài này được tách biệt khỏi phần còn lại của cluster.
kubectl create namespace mem-example
Cài đặt bộ nhớ tối thiểu và bộ nhớ tối đa
Để cài đặt bộ nhớ tối thiểu cho một Container, bạn cần thêm trường resources:requests vào phần khai báo trong tệp cấu hình Container. Với bộ nhớ tối đa, bạn hãy thêm resources:limits.
Trong phần thực hành này, bạn sẽ tạo một Pod có một Container. Container này có bộ nhớ tối thiểu là 100 MiB và bộ nhớ tối đa là 200 MiB. Đây là file cấu hình cho Pod:
Phần args trong tệp cấu hình cung cấp các tham số cho Container khi nó khởi tạo.
Các tham số "--vm-bytes", "150M" yêu cầu Container cấp phát 150 MiB bộ nhớ.
Chạy lệnh kubectl top để xem các thông số của Pod:
kubectl top pod memory-demo --namespace=mem-example
Kết quả cho thấy Pod đang sử dụng khoảng 162,900,000 bytes bộ nhớ,
tương đương khoảng 150MiB. Mức này cao hơn 100MiB tối thiểu nhưng vẫn nằm trong giới hạn 200MiB.
NAME                        CPU(cores)   MEMORY(bytes)
memory-demo                 <something>  162856960
Xóa Pod:
kubectl delete pod memory-demo --namespace=mem-example
Vượt quá bộ nhớ tối đa của Container
Một Container có thể sử dụng nhiều bộ nhớ hơn mức tối thiểu nếu Node còn bộ nhớ trống. Tuy nhiên, Container không được phép sử dụng bộ nhớ hơn mức tối đa của nó. Nếu Container cấp phát nhiều bộ nhớ hơn mức tối đa, Container đó sẽ có khả năng bị dừng hoạt động. Nếu Container tiếp tục sử dụng bộ nhớ vượt quá giới hạn, nó sẽ được dừng hoàn toàn. Nếu Container đó có thể khởi động lại, kubelet sẽ khởi động lại nó, lỗi quá bộ nhớ được xử lý giống như đối với các lỗi runtime khác.
Trong phần thực hành này, bạn sẽ tạo một Pod cố gắng cấp phát bộ nhớ nhiều hơn giới hạn của nó.
Đây là tệp cấu hình cho một Pod có một Container với bộ nhớ tối thiểu là 50 MiB và bộ nhớ tối đa là 100 MiB:
Container trong phần thực hành này có thể được khởi động lại, vì vậy kubelet sẽ khởi động lại nó. Lặp lại lệnh này vài lần để thấy Container liên tục bị dừng hoạt động và khởi động lại:
kubectl get pod memory-demo-2 --namespace=mem-example
Kết quả cho thấy Container bị dừng hoạt động, khởi động lại, bị dừng hoạt động lần nữa, khởi động lại lần nữa, và cứ tiếp tục như vậy:
kubectl get pod memory-demo-2 --namespace=mem-example
NAME            READY     STATUS      RESTARTS   AGE
memory-demo-2   0/1       OOMKilled   1          37s
kubectl get pod memory-demo-2 --namespace=mem-example
NAME            READY     STATUS    RESTARTS   AGE
memory-demo-2   1/1       Running   2          40s
Xem thông tin chi tiết về lịch sử của Pod:
kubectl describe pod memory-demo-2 --namespace=mem-example
Kết quả cho thấy Container liên tục khởi động và thất bại:
... Normal  Created   Created container with id 66a3a20aa7980e61be4922780bf9d24d1a1d8b7395c09861225b0eba1b1f8511
... Warning BackOff   Back-off restarting failed container
Xem thông tin chi tiết về các Node trong Cluster:
kubectl describe nodes
Kết quả cho thấy việc Container bị dừng hoạt động do tình trạng hết bộ nhớ:
Warning OOMKilling Memory cgroup out of memory: Kill process 4481 (stress) score 1994 or sacrifice child
Xóa Pod:
kubectl delete pod memory-demo-2 --namespace=mem-example
Cài đặt bộ nhớ tối thiểu vượt quá khả năng của Nodes
Bộ nhớ tối thiểu và tối đa được gắn với các Container, nhưng cũng có thể hiểu rằng một Pod có tổng bộ nhớ tối thiểu và tối đa riêng. Bộ nhớ tối thiểu cho Pod là tổng các bộ nhớ tối thiểu của tất cả các Container trong Pod. Tương tự, bộ nhớ tối đa cho Pod là tổng của các bộ nhớ tối đa của tất cả các Container trong Pod.
Khi lập lịch (scheduling) Pod, Kubernetes dựa vào bộ nhớ tối thiểu. Một Pod chỉ được chạy trên Node nếu Node có đủ bộ nhớ trống để đáp ứng bộ nhớ tối thiểu của Pod.
Trong phần thực hành này, bạn sẽ tạo một Pod có bộ nhớ tối thiểu lớn đến mức vượt quá khả năng của bất kỳ Node nào trong cluster của bạn. Đây là tệp cấu hình cho một Pod có một Container với 1000 GiB bộ nhớ tối thiểu, có khả năng vượt quá khả năng của bất kỳ Node nào trong cluster của bạn.
kubectl get pod memory-demo-3 --namespace=mem-example
Kết quả cho thấy trạng thái của Pod là PENDING. Nghĩa là, Pod không được lập lịch để chạy trên bất kỳ Node nào, và nó sẽ tiếp tục ở trạng thái PENDING vô thời hạn:
kubectl get pod memory-demo-3 --namespace=mem-example
NAME            READY     STATUS    RESTARTS   AGE
memory-demo-3   0/1       Pending   0          25s
Xem thông tin chi tiết về Pod, bao gồm cả sự kiện:
kubectl describe pod memory-demo-3 --namespace=mem-example
Kết quả cho thấy Container không thể được lập lịch do không đủ bộ nhớ trên các Nodes:
Events:
  ...  Reason            Message
       ------            -------
  ...  FailedScheduling  No nodes are available that match all of the following predicates:: Insufficient memory (3).
Đơn vị đo bộ nhớ
Tài nguyên bộ nhớ được đo bằng byte. Bạn có thể biểu thị bộ nhớ dưới dạng số nguyên thông thường hoặc số thập phân cố định với một trong các hậu tố sau: E, P, T, G, M, K, Ei, Pi, Ti, Gi, Mi, Ki.
Ví dụ, các giá trị sau đây biểu thị xấp xỉ cùng một giá trị:
128974848, 129e6, 129M, 123Mi
Xoá Pod:
kubectl delete pod memory-demo-3 --namespace=mem-example
Nếu bạn không cài đặt bộ nhớ tối đa
Nếu bạn không cài đặt bộ nhớ tối đa cho một Container, một trong các tình huống sau sẽ xảy ra:
Container không có giới hạn tối đa về lượng bộ nhớ mà nó sử dụng. Container có thể sử dụng tất cả bộ nhớ có sẵn trên Node nơi nó đang chạy, điều này có thể kích hoạt OOM Killer. Hơn nữa, trong trường hợp OOM Kill, một container không có giới hạn tài nguyên sẽ có khả năng bị dừng hoạt động cao hơn.
Container đang chạy trong một namespace có bộ nhớ tối đa mặc định, và Container tự động được gán giới hạn mặc định đó. Cluster administrators có thể sử dụng LimitRange để chỉ định giá trị mặc định cho bộ nhớ tối đa.
Lý do cần có bộ nhớ tối thiểu và bộ nhớ tối đa
Bằng cách cấu hình bộ nhớ tối thiểu và tối đa cho các Container chạy trong cluster của bạn, bạn có thể sử dụng hiệu quả tài nguyên bộ nhớ có sẵn trên các Node của cluster. Với việc giữ bộ nhớ tối thiểu của Pod ở mức thấp, Pod dễ được triển khai hơn. Bằng cách có bộ nhớ tối đa lớn hơn bộ nhớ tối thiểu, bạn đạt được hai điều:
Pod có thể có các đợt hoạt động cao điểm sử dụng bộ nhớ đang có sẵn.
Lượng bộ nhớ mà Pod có thể sử dụng trong đợt cao điểm được giới hạn ở một mức hợp lý.
Xóa các thành phần đã tạo
Xóa namespace của bạn. Thao tác này sẽ xóa tất cả các Pod bạn đã tạo cho phần này:
Thiết lập hệ thống giám sát và ghi nhật ký để khắc phục sự cố cụm, hoặc gỡ lỗi ứng dụng trong container.
Đôi khi mọi thứ diễn ra không như mong muốn. Hướng dẫn này sẽ giúp bạn thu thập những thông tin cần thiết và khắc phục sự cố. Hướng dẫn này được chia làm 4 phần:
Gỡ lỗi ứng dụng - Hữu ích cho những người
triển khai ứng dụng lên Kubernetes và muốn hiểu vì sao ứng dụng không hoạt động như mong đợi.
Gỡ lỗi cụm - Hữu ích cho
các quản trị viên và người vận hành cụm khắc phục các sự cố trong cụm.
Ghi nhật ký trong Kubernetes - Hữu ích cho
các quản trị viên muốn thiết lập và quản lý hệ thống nhật ký trong Kubernetes.
Giám sát trong Kubernetes - Hữu ích cho
các quản trị viên muốn triển khai hệ thống giám sát trong Kubernetes.
Bạn cũng nên tham khảo các sự cố đã biết của phiên bản mà bạn đang sử dụng.
Nhận trợ giúp
Nếu bạn vẫn chưa tìm được cách xử lý cho vấn đề của mình trong các hướng dẫn ở trên,
bạn có thể tìm kiếm sự hỗ trợ từ cộng đồng Kubernetes thông qua nhiều kênh khác nhau.
Câu hỏi
Tài liệu trên trang này được tổ chức nhằm giải đáp nhiều loại câu hỏi khác nhau về Kubernetes.
Khái niệm giải thích kiến trúc của Kubernetes và cách thức hoạt động của từng thành phần.
Thiết lập cung cấp các hướng dẫn để bạn bắt đầu sử dụng Kubernetes.
Tác vụ hướng dẫn cách thực hiện các tác vụ thường gặp, và
Hướng dẫn thực hành cung cấp hướng dẫn chi tiết cho các tình huống thực tế,
theo từng lĩnh vực hoặc trong toàn bộ quy trình phát triển.
Mục Tài liệu tham khảo cung cấp tài liệu chi tiết về Kubernetes API
và các giao diện dòng lệnh (CLIs) như kubectl.
Giúp với! Vấn đề của tôi không có trong tài liệu! Tôi cần hỗ trợ ngay!
Stack Exchange, Stack Overflow, hoặc Server Fault
Nếu bạn có câu hỏi liên quan đến phát triển phần mềm cho ứng dụng chạy trong container,
bạn có thể đặt câu hỏi trên Stack Overflow.
Nếu bạn có câu hỏi về Kubernetes liên quan đến quản lý cụm hay cấu hình,
bạn có thể đặt câu hỏi trên Server Fault.
Ngoài ra, hệ thống Stack Exchange còn có nhiều trang chuyên biệt khác,
phù hợp để đặt các câu hỏi về Kubernetes trong những lĩnh vực như
DevOps,
Software Engineering,
hay InfoSec.
Rất có thể đã có một thành viên trong cộng đồng gặp phải vấn đề tương tự
hoặc có thể sẵn sàng giúp bạn giải quyết vấn đề.
Nhiều thành viên trong cộng đồng Kubernetes trao đổi trên Kubernetes Slack, trong kênh #kubernetes-users.
Slack yêu cầu phải đăng ký; bạn có thể gửi yêu cầu tham dự,
việc đăng ký được mở cho tất cả mọi người. Đừng ngại tham gia và đặt bất kỳ câu hỏi nào.
Sau khi đăng ký, truy cập Kubernetes trên Slack thông qua trình duyệt hoặc qua ứng dụng Slack.
Sau khi tham gia, bạn có thể khám phá danh sách các kênh thảo luận theo từng chủ đề. Ví dụ, người mới bắt đầu với Kubernetes có thể tham gia kênh
#kubernetes-novice. Các nhà phát triển có thể tham gia kênh
#kubernetes-contributors.
Ngoài ra còn có các kênh dành riêng cho từng quốc gia hoặc ngôn ngữ. Bạn có thể tham gia các kênh này
để nhận được sự hỗ trợ và trao đổi thông tin bằng ngôn ngữ địa phương:
Bạn được chào đón tham gia diễn đàn chính thức của Kubernetes: discuss.kubernetes.io.
Báo lỗi và đề xuất tính năng
Nếu bạn phát hiện ra lỗi hoặc muốn đề xuất một tính năng, hãy sử dụng
GitHub issue.
Trước khi tạo một issue mới, hãy tìm trong các issue hiện có để xem các vấn đề của bạn đã được thảo luận trước đó hay chưa.
Khi báo cáo lỗi, hãy cung cấp đầy đủ thông tin để có thể tái hiện lỗi, ví dụ:
Phiên bản Kubernetes kubectl version
Nhà cung cấp Cloud, hệ điều hành, cấu hình mạng, phiên bản container runtime
Các bước để tái hiện sự cố
4.4 - Horizontal Pod Autoscaling
Trang này đang được dịch. Vui lòng xem phiên bản tiếng Anh để biết thông tin mới nhất.
5 - Tutorials
Phần này của tài liệu có chứa các hướng dẫn. Phần hướng dẫn sẽ chỉ cho bạn cách thực hiện một mục tiêu lớn hơn một tác vụ đơn lẻ.
Thông thường, một hướng dẫn có nhiều phần, mỗi phần có một trình tự các bước. Trước khi thực hiện từng hướng dẫn, bạn có thể muốn đánh dấu trang Thuật ngữ chuẩn hóa để tham khảo.
5.1 - Học kiến thức cơ bản về Kubernetes
Kiến thức cơ bản về Kubernetes
Hướng dẫn này cung cấp những kiến thức cơ bản về một cụm Kubernetes. Mỗi mô-đun chứa một số thông tin cơ bản về các tính năng cũng như khái niệm chính của Kubernetes, đồng thời bao gồm một hướng dẫn tương tác trực tuyến. Các hướng dẫn tương tác này giúp bạn quản lý một cluster đơn giản và các ứng dụng được đóng gói của bạn.
Bằng các hướng dẫn tương tác, bạn có thể học cách:
Triển khai một ứng dụng container trong một cluster.
Thay đổi quy mô triển khai.
Cập nhật ứng dụng container.
Debug ứng dụng container.
Những hướng dẫn này dùng Katacoda để chạy một terminal ảo trên trình duyệt web của bạn chạy Minikube. Không cần phải cài đặt và cấu hình bất kỳ phần mềm nào; mỗi hướng dẫn tương tác chạy trực tiếp từ trình duyệt web của bạn.
Kubernetes có thế làm những gì?
Với các dịch vụ web hiện đại, người dùng mong muốn các ứng dụng luôn sẵn sàng hoạt động 24/7 và các lập trình viên muốn triển khai các phiên bản của ứng dụng đó nhiều lần trong ngày. Việc đóng gói ứng dụng vào container giúp giải quyết mục tiêu này, cho phép các ứng dụng được phát hành và cập nhật một cách dễ dàng, nhanh chóng mà không có downtime. Kubernetes giúp bạn đảm bảo các ứng dụng container chạy ở bất kì đâu và bất kì lúc nào bạn muốn, đồng thời giúp chúng tìm thấy các tài nguyên và công cụ cần thiết để chạy. Kubernetes là nền tảng mã nguồn mở, chạy được trong môi trường production, được thiết kế và phát triển bởi Google, kết hợp với những ý tưởng tốt nhất từ cộng đồng.
Khởi tạo một Kubernetes cluster sử dụng terminal trực tuyến.
Kubernetes Clusters
Kubernetes kết nối và điều phối các máy tính trong một cluster để chúng có thể hoạt động như một đơn vị thống nhất (unit). Nó cho phép bạn triển khai các ứng dụng trên Container mà không cần phải bận tâm chúng sẽ được khởi chạy trên chiếc máy tính cụ thể nào trong cluster. Để sử dụng mô hình triển khai của Kubernetes, các ứng dụng cần được đóng gói theo một cách linh động và không phụ thuộc vào từng máy tính cụ thể (host): tức là các ứng dụng được Container hóa. Các ứng dụng dạng Container có được sự khả chuyển và sẵn sàng cao hơn các mô hình triển khai được sử dụng trong quá khứ, ở đó chúng được cài đặt trực tiếp trên các máy tính cụ thể và gắn chặt với các bộ thư viện trên đó. Kubernetes phân bổ và điều phối các ứng dụng hoàn toàn tự động xuyên suốt cluster theo một cách hiệu quả. Ngoài ra Kubernetes là mã nguồn mở và sẵn sàng để sử dụng trong môi trường triển khai thực tế (production).
Một Kubernetes cluster bao gồm 2 loại tài nguyên:
Node Master làm nhiệm vụ quản lý toàn cluster.
Các Node còn lại khởi chạy các ứng dụng trực tiếp trên đó là các Worker.
Tổng kết:
Kubernetes cluster
Minikube
Kubernetes là một bộ công cụ mã nguồn mở, đáp ứng tiêu chuẩn triển khai thực tế, làm nhiệm vụ điều phối và khởi chạy các ứng dụng dạng Container bên trong một cluster hoặc thậm chí xuyên suốt nhiều cluster.
Mô hình Cluster
Node Master chịu trách nhiệm quản lý cluster. Nó quản lý toàn bộ các hoạt động bên trong cluster, như là việc khởi chạy các ứng dụng, kiểm soát chúng để chắc chắn chúng luôn ở các trạng thái như mong muốn, thay đổi khả năng đáp ứng của chúng (scaling), hoặc triển khai các phiên bản nâng cấp theo thời gian.
Một Node có thể là một máy ảo (VM) hoặc một máy tính vật lý làm việc với vai trò cung cấp khả năng tính toán cho cluster. Mỗi Node có một chương trình chạy thường trực bên trong tên là Kubelet, làm nhiệm vụ quản lý Node và duy trì kết nối với node Master. Mỗi Node bên cạnh đó còn chạy các chương trình dùng để khởi chạy và quản lý các Container như Docker hay rkt. Mỗi một Kubernetes cluster được triển khai trong thực tế khai thác thường có ít nhất 3 node thuộc 2 loại như bên trên.
Master quản lý cluster và các Node đóng vai trò chạy các ứng dụng Container.
Khi bạn triển khai các ứng dụng trên Kubernetes, bạn yêu cầu node Master phân bổ và khởi chạy các ứng dụng của bạn. Node Master tiếp đó tính toán để tìm ra các Node nào thích hợp cho việc triển khai ứng dụng. Các Node trong cluster kết nối và giao tiếp với nhau theo bộ qui tắc Kubernetes API do node Master đưa ra. Quản trị viên hoặc người sử dụng đầu cuối cũng có thể sử dụng bộ qui tắc này để tương tác trực tiếp với một cluster.
Một Kubernetes cluster có thể được xây dựng trên các máy tính vật lý hoặc các máy ảo. Để bắt đầu việc phát triển cho Kubernetes, bạn có thể sử dụng Minikube. Minikube là một bộ cài đặt Kubernetes bằng cách tạo ra một máy ảo trên máy tính của bạn và triển khai một cluster đơn giản bên trong máy ảo đó chỉ bao gồm một Node. Minikube có cho Linux, macOS, và Windows. Minikube CLI, một bộ công cụ dòng lệnh, cung cấp khả năng điều khiển cluster cho người sử dụng, như chạy, dừng chạy, xem trạng thái, hoặc xóa một thành phần trong cluster. Trong bài hướng dẫn này, bạn sẽ sử dụng một giao diện terminal trực tuyến với Minikube đã được cài đặt sẵn để thao tác.
Giờ bạn đã biết Kubernetes là gì, hãy tiếp tục với phần tương tác và tạo ra cluster đầu tiên!
Triển khai ứng dụng đầu tiên của bạn trên Kubernetes với kubectl.
Kubernetes Deployments
Giả sử bạn đã có một Kubernetes cluster đang hoạt động, bạn có thể triển khai ứng dụng của bạn trên cluster này. Để thực hiện điều đó, bạn cần tạo một kịch bản triển khai (Deployment). Kịch bản này sẽ giúp Kubernetes có thể tạo và cập nhật các phiên bản chạy (instances) của ứng dụng của bạn. Sau khi một kịch bản triển khai được tạo ra trong Kubernetes, node Master sẽ lập lịch để khởi chạy ứng dụng của bạn trên các Node của cluster.
Sau khi ứng dụng của bạn được khởi chạy trên các Node của cluster, Kubernetes sẽ tiếp tục theo dõi các chương trình đang chạy (instances) này. Nếu một Node đang chạy một instance của ứng dụng của bạn gặp trục trặc hoặc bị xóa khỏi cluster, Kubernetes sẽ thay thế instance đó bằng cách khởi chạy một instance mới trên một Node khác của cluster. Đây là cơ chế tự phục hồi (self-healing) khi có lỗi xảy ra hoặc khi một Node nào đó cần được bảo trì.
Ở thời điểm trước Kubernetes, các ứng dụng thường được khởi chạy thông qua các bộ tool cài đặt (installation scripts), nhưng chúng hầu như không thể hỗ trợ việc phục hồi khi có lỗi xảy ra với một máy tính trong cluster. Bằng cách khởi chạy các instances của ứng dụng trên nhiều Node xuyên suốt cluster, Kubernetes về cơ bản đã cho thấy một cách tiếp cận rất khác biệt về việc quản lý các ứng dụng.
Tổng kết:
Deployments
Kubectl
Một kịch bản triển khai (Deployment) là một tập hợp các thao tác làm nhiệm vụ khởi chạy ứng dụng của bạn và theo dõi cập nhật các instances của ứng dụng trên phạm vi toàn cluster
Triển khai ứng dụng đầu tiên của bạn trên Kubernetes
Bạn có thể tạo ra và quản lý các kịch bản triển khai (Deployment) thông qua giao diện dòng lệnh của Kubernetes với Kubectl. Kubectl sử dụng Kubernetes API để tương tác với cluster. Ở bài hướng dẫn này, bạn sẽ tìm hiểu các câu lệnh cơ bản nhất của Kubectl cần thiết để triển khai ứng dụng của bạn trên một Kubernetes cluster.
Khi tạo một kịch bản triển khai (Deployment), bạn cần chỉ ra một tệp Container Image chứa ứng dụng của bạn và số lượng bản sao (replicas) của ứng dụng bạn muốn chạy. Bạn hoàn toàn có thể thay đổi các thông số này bằng cách cập nhật kịch bản triển khai sau thông qua Module 5 và 6 của tập hướng dẫn cách cập nhật các Deployments.
Các ứng dụng phải được đóng gói trong một định dạng Container được hỗ trợ bởi Kubernetes để có thể triển khai trên hệ thống này
Về ứng dụng dầu tiên của bạn, nó sẽ là một ứng dụng Node.js được đóng gói trong một Docker container. (Nếu bạn chưa biết cách tạo một ứng dụng Node.js và đóng gói dưới dạng Container, vui lòng theo dõi hướng dẫn tại địa chỉ Hello Minikube tutorial).
Giờ bạn đã biết kịch bản triển khai (Deployment) là gì, hãy bắt đầu triển khai ứng dụng đầu tiên của bạn!
Khi bạn triển khai ứng dụng thông qua Module 2, Kubernetes tạo ra Pod để lưu trữ phiên bản chạy của ứng dụng của bạn. Một Pod là một khái niệm trừu tượng của Kubernetes, đại diện cho một nhóm gồm một hoặc nhiều ứng dụng containers (ví dụ như Docker hoặc rkt) và một số tài nguyên được chia sẻ cho các containers đó. Những tài nguyên đó bao gồm:
Lưu trữ được chia sẻ, dưới dạng Volumes
Kết nối mạng, như một cluster IP duy nhất
Thông tin về cách chạy từng container, chẳng hạn như phiên bản container image hoặc các ports cụ thể để sử dụng
Một Pod mô phỏng một "máy chủ logic" dành riêng cho ứng dụng và có thể chứa các ứng dụng containers khác nhau được liên kết tương đối chặt chẽ. Ví dụ, một Pod có thể bao gồm cả container với ứng dụng Node.js của bạn cũng như một container khác cung cấp dữ liệu hiển thị bởi webserver của Node.js. Các containers trong một Pod chia sẻ một địa chỉ IP và port space, chúng luôn được đặt cùng vị trí, cùng lên lịch trình, và chạy trong ngữ cảnh được chia sẻ trên cùng một Node.
Pods là các đơn vị nguyên tử trên nền tảng Kubernetes. Khi chúng tôi tạo một kịch bản triển khai (Deployment) trên Kubernetes, kịch bản triển khai đó tạo ra các Pods với các containers bên trong chúng (trái ngược với việc tạo các containers trực tiếp). Mỗi Pod được gắn với Node nơi nó được lên lịch trình, và tiếp tục ở đó cho đến khi chấm dứt (theo chính sách khởi động lại). Trong trường hợp có lỗi ở Node, các Pods giống nhau được lên lịch trình trên các Nodes có sẵn khác trong cluster.
Tổng Kết:
Pods
Nodes
Những lệnh chính của Kubectl
Một Pod là một nhóm gồm một hoặc nhiều ứng dụng containers (như Docker hoặc rkt) và bao gồm lưu trữ được chia sẻ (dưới dạng volumes), địa chỉ IP và thông tin về cách chạy chúng.
Tổng quan về Pods
Nodes
Một Pod luôn chạy trên một Node. Một Node là một máy worker trong Kubernetes và có thể là máy ảo hoặc máy vật lý, tuỳ thuộc vào cluster. Mỗi Node được quản lí bởi Master. Một Node có thể chứa nhiều Pods và Kubernetes master tự động xử lí việc lên lịch trình các Pods thuộc các Nodes ở trong cluster. Việc lên lịch trình tự động của Master sẽ tính đến các tài nguyên có sẵn trên mỗi Node.
Mỗi Node ở Kubernetes chạy ít nhất:
Kubelet, một quy trình chịu trách nhiệm liên lạc giữa Kubernetes Master và Node; quản lí các Pods và các containers đang chạy trên cùng một máy.
Một container runtime (như Docker, rkt) chịu trách nhiệm lấy container image từ registry, giải nén container và chạy ứng dụng. Các containers chỉ nên được lên lịch trình cùng nhau trong một Pod duy nhất nếu chúng được liên kết chặt chẽ.
Các containers chỉ nên được lên lịch trình cùng nhau trong một Pod duy nhất nếu chúng được liên kết chặt chẽ và cần chia sẻ tài nguyên như disk.
Tổng quan về Node
Khắc phục sự cố với kubectl
Ở Module 2, bạn đã sử dụng giao diện dòng lệnh Kubectl. Bạn sẽ tiếp tục sử dụng nó trong Module 3 để nhận thông tin về các ứng dụng đã triển khai và môi trường của chúng. Các hoạt động phổ biến nhất có thể được thực hiện với các lệnh kubectl sau:
kubectl get - liệt kê các tài nguyên
kubectl describe - hiển thị thông tin chi tiết về một tài nguyên
kubectl logs - in các bản ghi (logs) từ một container trong một pod
kubectl exec - thực hiện một lệnh trên một container trong một pod
Bạn có thể sử dụng các lệnh này để xem khi nào các ứng dụng được triển khai, trạng thái hiện tại của chúng là gì, nơi chúng đang chạy và cấu hình của chúng là gì.
Bây giờ chúng ta đã biết thêm về các thành phần cluster và dòng lệnh, hãy khám phá ứng dụng của chúng tôi.
Một Node là một máy worker trong Kubernetes và có thể là máy ảo hoặc máy vật lý, tuỳ thuộc vào cluster. Nhiều Pods có thể chạy trên cùng một Node.
Hiểu mối quan hệ giữa labels và selectors với Service
Công khai một ứng dụng ra bên ngoài Kubernetes cluster
Tổng quan về Service trong Kubernetes
Pods trong Kubernetes có tính tạm thời. Pods có một
vòng đời nhất định. Khi một worker node ngừng hoạt động,
các Pod đang chạy trên Node đó cũng bị mất. Một ReplicaSet
có thể tự động điều chỉnh cluster về trạng thái mong muốn bằng cách tạo
các Pod mới để giữ cho ứng dụng tiếp tục hoạt động. Ví dụ khác, hãy xem xét một backend xử lý container image với 3 bản sao. Những bản sao này có thể thay thế lẫn nhau; hệ thống frontend không cần quan tâm đến các bản sao backend hoặc việc một Pod bị mất và được tạo lại. Tuy nhiên, mỗi Pod trong Kubernetes cluster đều có một địa chỉ IP duy nhất, kể cả các Pod trên cùng một Node, vì vậy cần có cơ chế tự động điều phối các thay đổi giữa các Pod để ứng dụng có thể tiếp tục hoạt động.
Service trong Kubernetes là một lớp trừu tượng định nghĩa một tập hợp logic các Pod và cho phép công khai lưu lượng truy cập, cân bằng tải và service discovery cho những Pod đó.
Service trong Kubernetes là một lớp trừu tượng định nghĩa một tập hợp logic các Pod và chính sách truy cập cho chúng. Service cho phép các Pod phụ thuộc nhau có thể kết nối với nhau một cách "lỏng lẻo". Service được định nghĩa bằng YAML hoặc JSON, giống như tất cả các manifest đối tượng khác của Kubernetes. Tập hợp các Pod mà Service nhắm đến thường được xác định bằng một label selector (xem phần dưới để hiểu tại sao đôi khi bạn có thể muốn một Service mà không cần selector trong đặc tả).
Mặc dù mỗi Pod có một địa chỉ IP duy nhất, những IP này không được công khai ra bên ngoài cluster nếu không có Service. Service cho phép ứng dụng của bạn nhận lưu lượng truy cập từ bên ngoài. Service có thể được công khai theo nhiều cách khác nhau bằng cách chỉ định type trong phần spec của Service:
ClusterIP (mặc định) - Công khai Service trên một IP nội bộ trong cluster. Kiểu này chỉ cho phép Service có thể truy cập được từ bên trong cluster.
NodePort - Công khai Service trên cùng một port của mỗi Node được chọn trong cluster sử dụng NAT. Cho phép Service có thể truy cập được từ bên ngoài cluster thông qua <NodeIP>:<NodePort>. Là tập mở rộng của ClusterIP.
LoadBalancer - Tạo một bộ cân bằng tải bên ngoài trong cloud hiện tại (nếu được hỗ trợ) và gán một IP cố định bên ngoài cho Service. Là tập mở rộng của NodePort.
ExternalName - Ánh xạ Service với nội dung của trường externalName (ví dụ: foo.bar.example.com), bằng cách trả về một bản ghi CNAME với giá trị tương ứng. Không thiết lập bất kỳ proxy nào. Kiểu này yêu cầu phiên bản v1.7 trở lên của kube-dns hoặc CoreDNS phiên bản 0.0.8 trở lên.
Ngoài ra, lưu ý rằng có một số trường hợp sử dụng Service mà không cần định nghĩa selector trong đặc tả. Service được tạo không có selector sẽ không tạo đối tượng Endpoints tương ứng. Điều này cho phép người dùng tự ánh xạ Service đến các endpoints cụ thể. Một trường hợp khác là khi bạn chỉ sử dụng type: ExternalName.
Service và Labels
Service định tuyến lưu lượng qua một tập hợp các Pod. Service là lớp trừu tượng cho phép các Pod có thể được tạo và xóa trong Kubernetes mà không ảnh hưởng đến ứng dụng. Việc service discovery và định tuyến giữa các Pod phụ thuộc nhau (như các thành phần frontend và backend trong một ứng dụng) được xử lý bởi Kubernetes Services.
Service khớp với một tập hợp các Pod sử dụng labels và selectors, một cơ chế nhóm cho phép thao tác logic trên các đối tượng trong Kubernetes. Labels là các cặp key/value được gắn vào đối tượng và có thể được sử dụng theo nhiều cách:
Chỉ định đối tượng cho môi trường development, test và production
Gắn thẻ phiên bản
Phân loại đối tượng bằng tags
Labels có thể được gắn vào đối tượng khi tạo hoặc sau đó và có thể được sửa đổi bất cứ lúc nào. Bây giờ hãy công khai ứng dụng của chúng ta bằng Service và áp dụng một số labels.
Bước 1: Tạo một Service mới
Đầu tiên, hãy kiểm tra xem ứng dụng của chúng ta có đang chạy không. Chúng ta sẽ sử dụng lệnh kubectl get để xem các Pod hiện có:
kubectl get pods
Nếu không có Pod nào đang chạy, điều đó có nghĩa là các đối tượng từ bài hướng dẫn trước đã được dọn dẹp. Trong trường hợp này, hãy quay lại và tạo lại deployment từ bài hướng dẫn Sử dụng kubectl để tạo Deployment. Vui lòng đợi vài giây và liệt kê lại các Pod. Bạn có thể tiếp tục khi thấy một Pod đang chạy.
Tiếp theo, hãy liệt kê các Service hiện có trong cluster:
kubectl get services
Bây giờ chúng ta có một Service đang chạy tên là kubernetes-bootcamp. Service này đã nhận được một cluster-IP duy nhất, một port nội bộ và một external-IP (IP của Node).
Để tìm hiểu port nào được mở ra bên ngoài (cho Service kiểu NodePort), chúng ta sẽ chạy lệnh con describe service:
kubectl describe services/kubernetes-bootcamp
Tạo một biến môi trường NODE_PORT với giá trị là Node port được gán:
exportNODE_PORT="$(kubectl get services/kubernetes-bootcamp -o go-template='{{(index .spec.ports 0).nodePort}}')"echo"NODE_PORT=$NODE_PORT"
Bây giờ chúng ta có thể kiểm tra xem ứng dụng đã được công khai ra ngoài cluster chưa bằng cách sử dụng curl, địa chỉ IP của Node và port được công khai ra bên ngoài:
curl http://"$(minikube ip):$NODE_PORT"
Lưu ý:
Nếu bạn đang chạy minikube với Docker Desktop làm container driver, bạn cần một minikube tunnel. Điều này là do các container trong Docker Desktop bị cô lập với máy host của bạn.
Trong một cửa sổ terminal riêng biệt, thực thi:
minikube service kubernetes-bootcamp --url
Kết quả sẽ như sau:
http://127.0.0.1:51082
!  Because you are using a Docker driver on darwin, the terminal needs to be open to run it.
Sau đó sử dụng URL được cung cấp để truy cập ứng dụng:
curl 127.0.0.1:51082
Và chúng ta nhận được phản hồi từ server. Service đã được công khai.
Bước 2: Sử dụng labels
Deployment đã tự động tạo một label cho Pod của chúng ta. Với lệnh con describe deployment, bạn có thể thấy tên (khóa) của label đó:
kubectl describe deployment
Hãy sử dụng label này để truy vấn danh sách Pod của chúng ta. Chúng ta sẽ sử dụng lệnh kubectl get pods với tham số -l, theo sau là giá trị của label:
kubectl get pods -l app=kubernetes-bootcamp
Bạn có thể làm tương tự để liệt kê các Service hiện có:
kubectl get services -l app=kubernetes-bootcamp
Lấy tên của Pod và lưu vào biến môi trường POD_NAME:
exportPOD_NAME="$(kubectl get pods -o go-template --template '{{range .items}}{{.metadata.name}}{{"\n"}}{{end}}')"echo"Name of the Pod: $POD_NAME"
Để áp dụng một label mới, chúng ta sử dụng lệnh con label theo sau bởi loại đối tượng, tên đối tượng và label mới:
kubectl label pods "$POD_NAME"version=v1
Điều này sẽ áp dụng một label mới cho Pod của chúng ta (chúng ta đã gắn phiên bản ứng dụng vào Pod), và chúng ta có thể kiểm tra nó bằng lệnh describe pod:
kubectl describe pods "$POD_NAME"
Chúng ta thấy rằng label đã được gắn vào Pod của chúng ta. Và bây giờ chúng ta có thể truy vấn danh sách pod sử dụng label mới:
kubectl get pods -l version=v1
Và chúng ta thấy Pod đó.
Bước 3: Xóa một service
Để xóa Service, bạn có thể sử dụng lệnh con delete service. Labels cũng có thể được sử dụng ở đây:
kubectl delete service -l app=kubernetes-bootcamp
Xác nhận rằng Service đã bị xóa:
kubectl get services
Điều này xác nhận rằng Service của chúng ta đã được gỡ bỏ. Để xác nhận rằng route không còn được công khai nữa, bạn có thể thử curl tới IP và port đã được công khai trước đó:
curl http://"$(minikube ip):$NODE_PORT"
Điều này chứng minh rằng ứng dụng không còn có thể truy cập được từ bên ngoài cluster nữa.
Bạn có thể xác nhận rằng ứng dụng vẫn đang chạy bằng cách curl từ bên trong pod:
source <(kubectl completion bash)# thiết lập autocomplete trong bash vào shell hiện tại, gói bash-completion nên được cài đặt trước tiên echo"source <(kubectl completion bash)" >> ~/.bashrc # thêm vĩnh viễn autocomplete vào trong bash shell
Bạn có thể dùng một alias cho kubectl cũng hoạt động với completion:
aliask=kubectl
complete -F __start_kubectl k
ZSH
source <(kubectl completion zsh)# thiết lập autocomplete trong zsh vào shell hiện tạiecho"if [ $commands[kubectl] ]; then source <(kubectl completion zsh); fi" >> ~/.zshrc # thêm vĩnh viễn autocomplete vào trong zsh shell
Ngữ cảnh và cấu hình kubectl
Thiết lập cụm Kubernetes nào mà kubectl sẽ giao tiếp với và sửa đổi thông tin cấu hình.
Xem tài liệu Xác thực giữa các cụm với kubeconfig
để biết thông tin chi tiết của tệp cấu hình.
kubectl config view # Hiển thị các thiết lập kubeconfig đã được merged# sử dụng nhiều tệp kubeconfig cùng một lúc và xem cấu hình hợp nhấtKUBECONFIG=~/.kube/config:~/.kube/kubconfig2
kubectl config view
# lấy mật khẩu cho người dùng e2ekubectl config view -o jsonpath='{.users[?(@.name == "e2e")].user.password}'kubectl config view -o jsonpath='{.users[].name}'# hiển thị người dùng đầu tiên kubectl config view -o jsonpath='{.users[*].name}'# lấy danh sách người dùng kubectl config get-contexts # hiển thị danh sách các ngữ cảnh kubectl config current-context # hiển thị ngữ cảnh hiện tạikubectl config use-context my-cluster-name # thiết lập ngữ cảnh mặc định cho my-cluster-name# thêm một cụm mới vào kubeconf hỗ trợ xác thực cơ bảnkubectl config set-credentials kubeuser/foo.kubernetes.com --username=kubeuser --password=kubepassword
# lưu vĩnh viễn namespace cho tất cả các lệnh kubectl tiếp theo trong ngữ cảnh đókubectl config set-context --current --namespace=ggckad-s2
# thiết lập ngữ cảnh sử dụng tên người dùng và namespace cụ thểkubectl config set-context gce --user=cluster-admin --namespace=foo \
&& kubectl config use-context gce
kubectl config unset users.foo # xóa người dùng foo
Apply
apply quản lý các ứng dụng thông qua các tệp định nghĩa tài nguyên Kubernetes. Nó tạo và cập nhật các tài nguyên trong một cụm thông qua việc chạy kubectl apply. Đây là cách được đề xuất để quản lý các ứng dụng Kubernetes trong thực tế. Xem thêm Kubectl Book.
Tạo một đối tượng
Kubernetes manifests có thể được định nghĩa trong tệp json hoặc yaml. Phần mở rộng .yaml,
.yml, và .json có thể được dùng.
kubectl apply -f ./my-manifest.yaml # tạo tài nguyênkubectl apply -f ./my1.yaml -f ./my2.yaml # tạo từ nhiều tệpkubectl apply -f ./dir # tạo tài nguyên từ tất cả các tệp manifest trong thư mục dirkubectl apply -f https://git.io/vPieo # tạo tài nguyên từ urlkubectl create deployment nginx --image=nginx # tạo một deployment nginxkubectl explain pods,svc # lấy thông tin pod và service manifest# Tạo nhiều đối tượng YAML từ stdincat <<EOF | kubectl apply -f -
apiVersion: v1
kind: Pod
metadata:
name: busybox-sleep
spec:
containers:
- name: busybox
image: busybox
args:
- sleep
- "1000000"
---
apiVersion: v1
kind: Pod
metadata:
name: busybox-sleep-less
spec:
containers:
- name: busybox
image: busybox
args:
- sleep
- "1000"
EOF# Tạo một secret với một số keyscat <<EOF | kubectl apply -f -
apiVersion: v1
kind: Secret
metadata:
name: mysecret
type: Opaque
data:
password: $(echo -n "s33msi4" | base64 -w0)
username: $(echo -n "jane" | base64 -w0)
EOF
Xem, tìm các tài nguyên
# Lệnh get với một số đầu ra cơ bảnkubectl get services # Liệt kê tất cả các services trong namespacekubectl get pods --all-namespaces # Liệt kê tất cả các pods trong tất cả các namespaceskubectl get pods -o wide # Liệt kê tất cả các pods namespace, với nhiều thông tin hơnkubectl get deployment my-dep # Liệt kê một deployment cụ thểkubectl get pods # Liệt kê tất cả các pods trong namespacekubectl get pod my-pod -o yaml # Lấy thông tin của một pod ở dạng YAMLkubectl get pod my-pod -o yaml --export # Lấy thông tin của một pod ở dạng YAML mà không có thông tin cụ thể về cụm# Lệnh describekubectl describe nodes my-node
kubectl describe pods my-pod
# Liệt kê các services được sắp xếp theo tênkubectl get services --sort-by=.metadata.name
# Liệt kê các pods được sắp xếp theo số lần khởi động lạikubectl get pods --sort-by='.status.containerStatuses[0].restartCount'# Liệt kê các pods được sắp xếp theo dung lượng trong namespace có tên là testkubectl get pods -n test --sort-by='.spec.capacity.storage'# Lấy thông tin phiên bản của tất cả các pods có nhãn app=cassandrakubectl get pods --selector=app=cassandra -o \
jsonpath='{.items[*].metadata.labels.version}'# Liệt kê tất cả các worker nodes (sử dụng một selector để loại trừ kết quả có một nhãn# có tên 'node-role.kubernetes.io/master' kubectl get node --selector='!node-role.kubernetes.io/master'# Liệt kê tất cả các pods đang chạy trong namespacekubectl get pods --field-selector=status.phase=Running
# Liệt kê tất cả các ExternalIPs của tất cả các nodeskubectl get nodes -o jsonpath='{.items[*].status.addresses[?(@.type=="ExternalIP")].address}'# Liệt kê tên của các pods thuộc về một RC nhất định# Lệnh "jq" hữu ích cho các chuyển đổi quá mức phức tạp cho jsonpath, xem thêm tại https://stedolan.github.io/jq/sel=${$(kubectl get rc my-rc --output=json | jq -j '.spec.selector | to_entries | .[] | "\(.key)=\(.value),"')%?}echo$(kubectl get pods --selector=$sel --output=jsonpath={.items..metadata.name})# Hiển thị nhãn của tất cả các pods (hoặc các đối tượng Kubernetes khác hỗ trợ gán nhãn)kubectl get pods --show-labels
# Kiểm tra xem nodes nào đã sẵn sàngJSONPATH='{range .items[*]}{@.metadata.name}:{range @.status.conditions[*]}{@.type}={@.status};{end}{end}'\
&& kubectl get nodes -o jsonpath="$JSONPATH"| grep "Ready=True"# Liệt kê tất cả cá Secrets hiện đang sử dụng bởi một podkubectl get pods -o json | jq '.items[].spec.containers[].env[]?.valueFrom.secretKeyRef.name'| grep -v null | sort | uniq
# Liệt kê tất cả các sự kiện được sắp xếp theo thời giankubectl get events --sort-by=.metadata.creationTimestamp
Cập nhật các tài nguyên
Theo như phiên bản 1.11, rolling-update đã không còn được dùng nữa (xem CHANGELOG-1.11.md), sử dụng rollout thay thế.
kubectl set image deployment/frontend www=image:v2 # Cập nhận container "www" của deployment "frontend", cập nhật imagekubectl rollout history deployment/frontend # Kiểm tra lịch sử deployment bao gồm các sửa đổikubectl rollout undo deployment/frontend # Quay trở lại deployment trước đókubectl rollout undo deployment/frontend --to-revision=2# Quay trở lại một phiên bản cụ thểkubectl rollout status -w deployment/frontend # Xem trạng thái cập nhật của deployment "frontend" cho đến khi hoàn thành# không còn được sử dụng kể từ phiên bản 1.11kubectl rolling-update frontend-v1 -f frontend-v2.json # (không dùng nữa) Cập nhật pods của frontend-v1kubectl rolling-update frontend-v1 frontend-v2 --image=image:v2 # (không dùng nữa) Đổi tên tài nguyên và cập nhật image kubectl rolling-update frontend --image=image:v2 # (không dùng nữa) Cập nhật image của pod của frontendkubectl rolling-update frontend-v1 frontend-v2 --rollback # (không dùng nữa) Hủy bỏ tiến trình cập nhật hiện tạicat pod.json | kubectl replace -f - # Thay thế một pod dựa trên JSON được truyền vào std# Buộc thay thế, xóa và sau đó tạo lại tài nguyên, sẽ gây ra sự cố ngưng serviceskubectl replace --force -f ./pod.json
# Tạo một services cho nginx, phục vụ trên công 80 và kết nối đến các container trên cổng 8000kubectl expose rc nginx --port=80 --target-port=8000# Cập nhật phiên bản image của một container đơn lẻ lên v4 kubectl get pod mypod -o yaml | sed 's/\(image: myimage\):.*$/\1:v4/'| kubectl replace -f -
kubectl label pods my-pod new-label=awesome # Thêm một nhãnkubectl annotate pods my-pod icon-url=http://goo.gl/XXBTWq # Thêm một chú thíchkubectl autoscale deployment foo --min=2 --max=10# Tự động scale deployment "foo"
Vá các tài nguyên
# Cập nhật một phần một nodekubectl patch node k8s-node-1 -p '{"spec":{"unschedulable":true}}'# Cập nhật image của container; spec.containers[*].name là bắt buộc vì đó là khóa hợp nhấtkubectl patch pod valid-pod -p '{"spec":{"containers":[{"name":"kubernetes-serve-hostname","image":"new image"}]}}'# Cập nhật image của container sử dụng một bản vá json với các mảng vị tríkubectl patch pod valid-pod --type='json' -p='[{"op": "replace", "path": "/spec/containers/0/image", "value":"new image"}]'# Vô hiệu hóa một deployment livenessProbe sử dụng một bản vá json với các mảng vị tríkubectl patch deployment valid-deployment --type json -p='[{"op": "remove", "path": "/spec/template/spec/containers/0/livenessProbe"}]'# Thêm một phần tử mới vào một mảng vị tríkubectl patch sa default --type='json' -p='[{"op": "add", "path": "/secrets/1", "value": {"name": "whatever" } }]'
Chỉnh sửa các tài nguyên
Chỉnh sửa bất kì API tài nguyên nào trong trình soạn thảo ưa thích của bạn.
kubectl edit svc/docker-registry # Chỉnh sửa services có tên docker-registryKUBE_EDITOR="nano" kubectl edit svc/docker-registry # Sử dụng một trình soạn thảo thay thế
Scaling tài nguyên
kubectl scale --replicas=3 rs/foo # Scale một replicaset có tên 'foo' thành 3kubectl scale --replicas=3 -f foo.yaml # Scale một tài nguyên được xác định trong "foo.yaml" thành 3kubectl scale --current-replicas=2 --replicas=3 deployment/mysql # Nếu kích thước hiện tại của deployment mysql là 2, scale mysql thành 3kubectl scale --replicas=5 rc/foo rc/bar rc/baz # Scale nhiều replication controllers
Xóa tài nguyên
kubectl delete -f ./pod.json # Xóa một pod sử dụng loại và tên được xác định trong pod.jsonkubectl delete pod,service baz foo # Xóa pods và services có tên "baz" và "foo"kubectl delete pods,services -l name=myLabel # Xóa pods và services có nhãn name=myLabelkubectl -n my-ns delete pod,svc --all # Xóa tất cả pods và services trong namespace my-ns,# Xóa tất cả pods matching với pattern1 hoặc pattern2kubectl get pods -n mynamespace --no-headers=true| awk '/pattern1|pattern2/{print $1}'| xargs kubectl delete -n mynamespace pod
Tương tác với các pods đang chạy
kubectl logs my-pod # kết xuất logs của pod (stdout)kubectl logs -l name=myLabel # kết xuất logs của pod có nhãn name=myLabel (stdout)kubectl logs my-pod --previous # kết xuất logs của pod (stdout) cho khởi tạo trước của một containerkubectl logs my-pod -c my-container # kết xuất logs của container của pod (stdout, trường hợp có nhiều container)kubectl logs -l name=myLabel -c my-container # kết xuất logs của container có tên my-container và có nhãn name=myLabel (stdout)kubectl logs my-pod -c my-container --previous # kết xuất logs của container my-container của pod my-pod (stdout, trường hợp có nhiều container) cho khởi tạo trước của một containerkubectl logs -f my-pod # lấy logs của pod my-pod (stdout)kubectl logs -f my-pod -c my-container # lấy logs của container my-container trong pod my-pod (stdout, trường hợp nhiều container)kubectl logs -f -l name=myLabel --all-containers # lấy logs của tất cả các container của pod có nhãn name=myLabel (stdout)kubectl run -i --tty busybox --image=busybox -- sh # Chạy pod trong một shell tương táckubectl run nginx --image=nginx --restart=Never -n
mynamespace # Chạy pod nginx trong một namespace cụ thểkubectl run nginx --image=nginx --restart=Never # Chạy pod nginx và ghi spec của nó vào file có tên pod.yaml--dry-run -o yaml > pod.yaml
kubectl attach my-pod -i # Đính kèm với container đang chạykubectl port-forward my-pod 5000:6000 # Lắng nghe trên cổng 5000 của máy local và chuyển tiếp sang cổng 6000 trên pod my-podkubectl exec my-pod -- ls / # Chạy lệnh trong một pod (trường hợp 1 container)kubectl exec my-pod -c my-container -- ls / # Chạy lệnh trong pod (trường hợp nhiều container)kubectl top pod POD_NAME --containers # Hiển thị số liệu của pod và container chạy trong nó
Tương tác với các nodes và cụm
kubectl cordon my-node # Đánh dấu my-node là không thể lập lịchkubectl drain my-node # Gỡ my-node ra khỏi cụm để chuẩn bị cho việc bảo trìkubectl uncordon my-node # Đánh dấu my-node có thể lập lịch trở lạikubectl top node my-node # Hiển thị số liệu của nodekubectl cluster-info # Hiển thị địa chỉ master và các serviceskubectl cluster-info dump # Kết xuất trạng thái hiện tại của cụm ra ngoài stdoutkubectl cluster-info dump --output-directory=/path/to/cluster-state # Kết xuất trạng thái hiện tại của cụm vào /path/to/cluster-statekubectl taint nodes foo dedicated=special-user:NoSchedule
Các loại tài nguyên
Liệt kê tất cả các loại tài nguyên được hỗ trợ cùng với tên viết tắt của chúng, API group, cho dù chúng là namespaced, và Kind:
kubectl api-resources
Các hoạt động khác để khám phá các tài nguyên API:
kubectl api-resources --namespaced=true# Tất cả các tài nguyên được đặt tênkubectl api-resources --namespaced=false# Tất cả các tài nguyên không được đặt tênkubectl api-resources -o name # Tất cả các tài nguyên với đầu ra đơn giản (chỉ gồm tên tài nguyên)kubectl api-resources -o wide # Tất cả các tài nguyên với đầu ra mở rộngkubectl api-resources --verbs=list,get # Tất cả các tài nguyên hỗ trợ yêu cầu "list" và "get"kubectl api-resources --api-group=extensions # Tất cả tài nguyên trong nhóm API "tiện ích mở rộng"
Định dạng đầu ra
Để xuất thông tin chi tiết ra cửa sổ terminal của bạn theo một định dạng cụ thể, bạn có thể thêm các cờ -o hoặc --output vào lệnh kubectl được hỗ trợ.
Định dạng đầu ra
Mô tả
-o=custom-columns=<spec>
In một bảng bằng danh sách, các cột tùy chỉnh được phân tách bằng dấu phẩy
-o=custom-columns-file=<filename>
In một bảng bằng cách sử dụng mẫu cột tùy chỉnh trong tệp <filename>
In ra các trường được xác định bởi jsonpath trong tệp <filename>
-o=name
Chỉ in tên tài nguyên và không có gì khác
-o=wide
Xuất ra ở định dạng văn bản thuần với bất kì thông tin bổ sung nào và đối với pods, cần phải thêm tên node
-o=yaml
Xuất ra đối tượng API theo định dạng YAML
Kubectl output verbosity and debugging
Kubectl verbosity được kiểm soát bởi cờ -v or --v theo sau là một số nguyên biểu thị mức log. Các quy ước ghi logs của Kubernetes và các mức logs liên quan được mô tả ở đây.
Verbosity
Description
--v=0
Hữu ích cho việc hiển thị cho các người vận hành cụm.
--v=1
Một mức log mặc định hợp lý nếu bạn không muốn lấy quá nhiều logs.
--v=2
Thông tin trạng thái về services và các thông điệp logs quan trọng có thể tương quan với những thay đổi quan trọng trong hệ thống. Đây là mức ghi logs mặc định được khuyến nghị cho hầu hết các hệ thống.
--v=3
Thông tin mở rộng về những thay đổi.
--v=4
Debug level verbosity.
--v=6
Hiển thị tài nguyên được yêu cầu.
--v=7
Hiển thị HTTP request headers.
--v=8
Hiển thị nội dung HTTP request.
--v=9
Hiển thị nội dung HTTP request mà không cắt ngắn nội dung.
Có rất nhiều cách để đóng góp cho Kubernetes. Bạn có thể tham gia thiết kế cho các tính năng mới, viết tài liệu cho mã nguồn hiện có, hoặc viết cho blog của chúng tôi. Còn nhiều hơn nữa: bạn có thể triển khai các tính năng mới hoặc sửa lỗi. Bạn cũng có thể giúp mọi người tham gia vào cộng đồng những người đóng góp của chúng tôi, hoặc hỗ trợ những người đóng góp hiện tại.
Với tất cả những cách khác nhau để tạo ra sự khác biệt cho dự án, chúng tôi - Kubernetes - đã tạo ra một trang web riêng: https://k8s.dev/. Bạn có thể truy cập vào đó để tìm hiểu thêm về việc đóng góp cho Kubernetes.
 Trang này hướng dẫn cách cài đặt hộp công cụ